在这组测试的节点上,Kata Pod 从创建到 Ready(就绪)需要 4.76 秒,gVisor 为 0.95 秒,普通 runc 为 0.84 秒。启动速度只是选择容器隔离方案的一个方面:同样的密集系统调用循环,Kata 比 runc 快约三倍,而 gVisor 慢约五倍。具体负载决定了隔离成本体现在哪里。
测试在同一台宿主机上比较 runc、gVisor、Kata 和普通 KVM 虚拟机,涵盖冷启动、Pod 就绪、空闲内存、系统调用循环、fio 与 nginx。Kata Containers 4.3.1 的数据来自 2026 年 10 月、运行于 Proxmox 嵌套虚拟化环境的 Ubuntu 26.04;Kata 启动最慢,因此相关数据适合观察这套环境中的相对差异,不能直接当成裸机性能。后半部分给出适用于 k3s 和 kubeadm 的 containerd 配置,以及包含 Pod 额外资源开销的 Kubernetes RuntimeClass 对象。
四种隔离方案的测试结果
下表主要列出多次运行的中位数。时间和内存越低越好,IOPS(每秒输入输出操作数)、吞吐量和每秒请求数越高越好。完整虚拟机使用 Ubuntu 26.04 云镜像,分配 2 个 vCPU、1 GiB 内存,与每个测试 Pod 的 CPU 和内存限制一致。
| 指标,中位数 | runc | gVisor(runsc) | Kata(QEMU) | 完整 KVM 虚拟机 |
|---|---|---|---|---|
容器冷启动,nerdctl run --rm |
0.61 s | 0.61 s | 4.60 s | 29.1 s 后可通过 SSH 登录 |
| Pod 创建到 Ready,括号内为 p95 | 0.84 s(0.86) | 0.95 s(3.87) | 4.76 s(4.89) | 不适用 |
| 每个空闲沙箱占用的宿主机内存 | 5.3 MiB | 30.9 MiB | 179.9 MiB | 717.5 MiB |
系统调用循环,dd bs=1 复制 1,000,000 字节 |
2.31 s | 12.06 s | 0.68 s | 3.17 s |
| fio 4k 随机读写,缓冲读取 IOPS | 9,933 | 49,190 | 5,197 | 1,987 |
| fio 顺序写入 1 GiB,最后执行 fsync | 246.6 MiB/s | 245.7 MiB/s | 128.7 MiB/s | 97.3 MiB/s |
| nginx,wrk 64 个连接,每秒请求数 | 41,762 | 4,700 | 1,966 | 23,786 |
| nginx p99 延迟 | 2.70 ms | 34.02 ms | 63.14 ms | 9.60 ms |
三个结果尤其影响选择。首先,gVisor 几乎不增加启动时间,每个 Pod 只比 runc 多消耗约 26 MiB 内存;但系统调用需要经过用户态内核,因此测试循环慢约五倍,nginx 请求率降至 runc 的约十分之一。其次,在这台嵌套虚拟化宿主机上,Kata 每个 Pod 多出约 4 秒启动时间和约 175 MiB 内存;其客户机内核关闭了部分 CPU 漏洞缓解措施,这也是后面系统调用性能较高的重要原因。最后,完整虚拟机与 Kata 具有类似的硬件虚拟化边界,却需要启动完整操作系统,启动耗时 29.1 秒、驻留内存 717.5 MiB;它的网络请求率则达到 Kata 的约十二倍。
gVisor 的 49,190 IOPS 不能当作磁盘本身的性能:请求由沙箱文件缓存响应,后面的直接 I/O 测试进一步印证了这一点。
各种隔离边界如何工作
四种方案的关键区别是:应用程序发出的 syscall(系统调用)由哪个内核接收。这一设计差异有助于解释上面的性能数据。
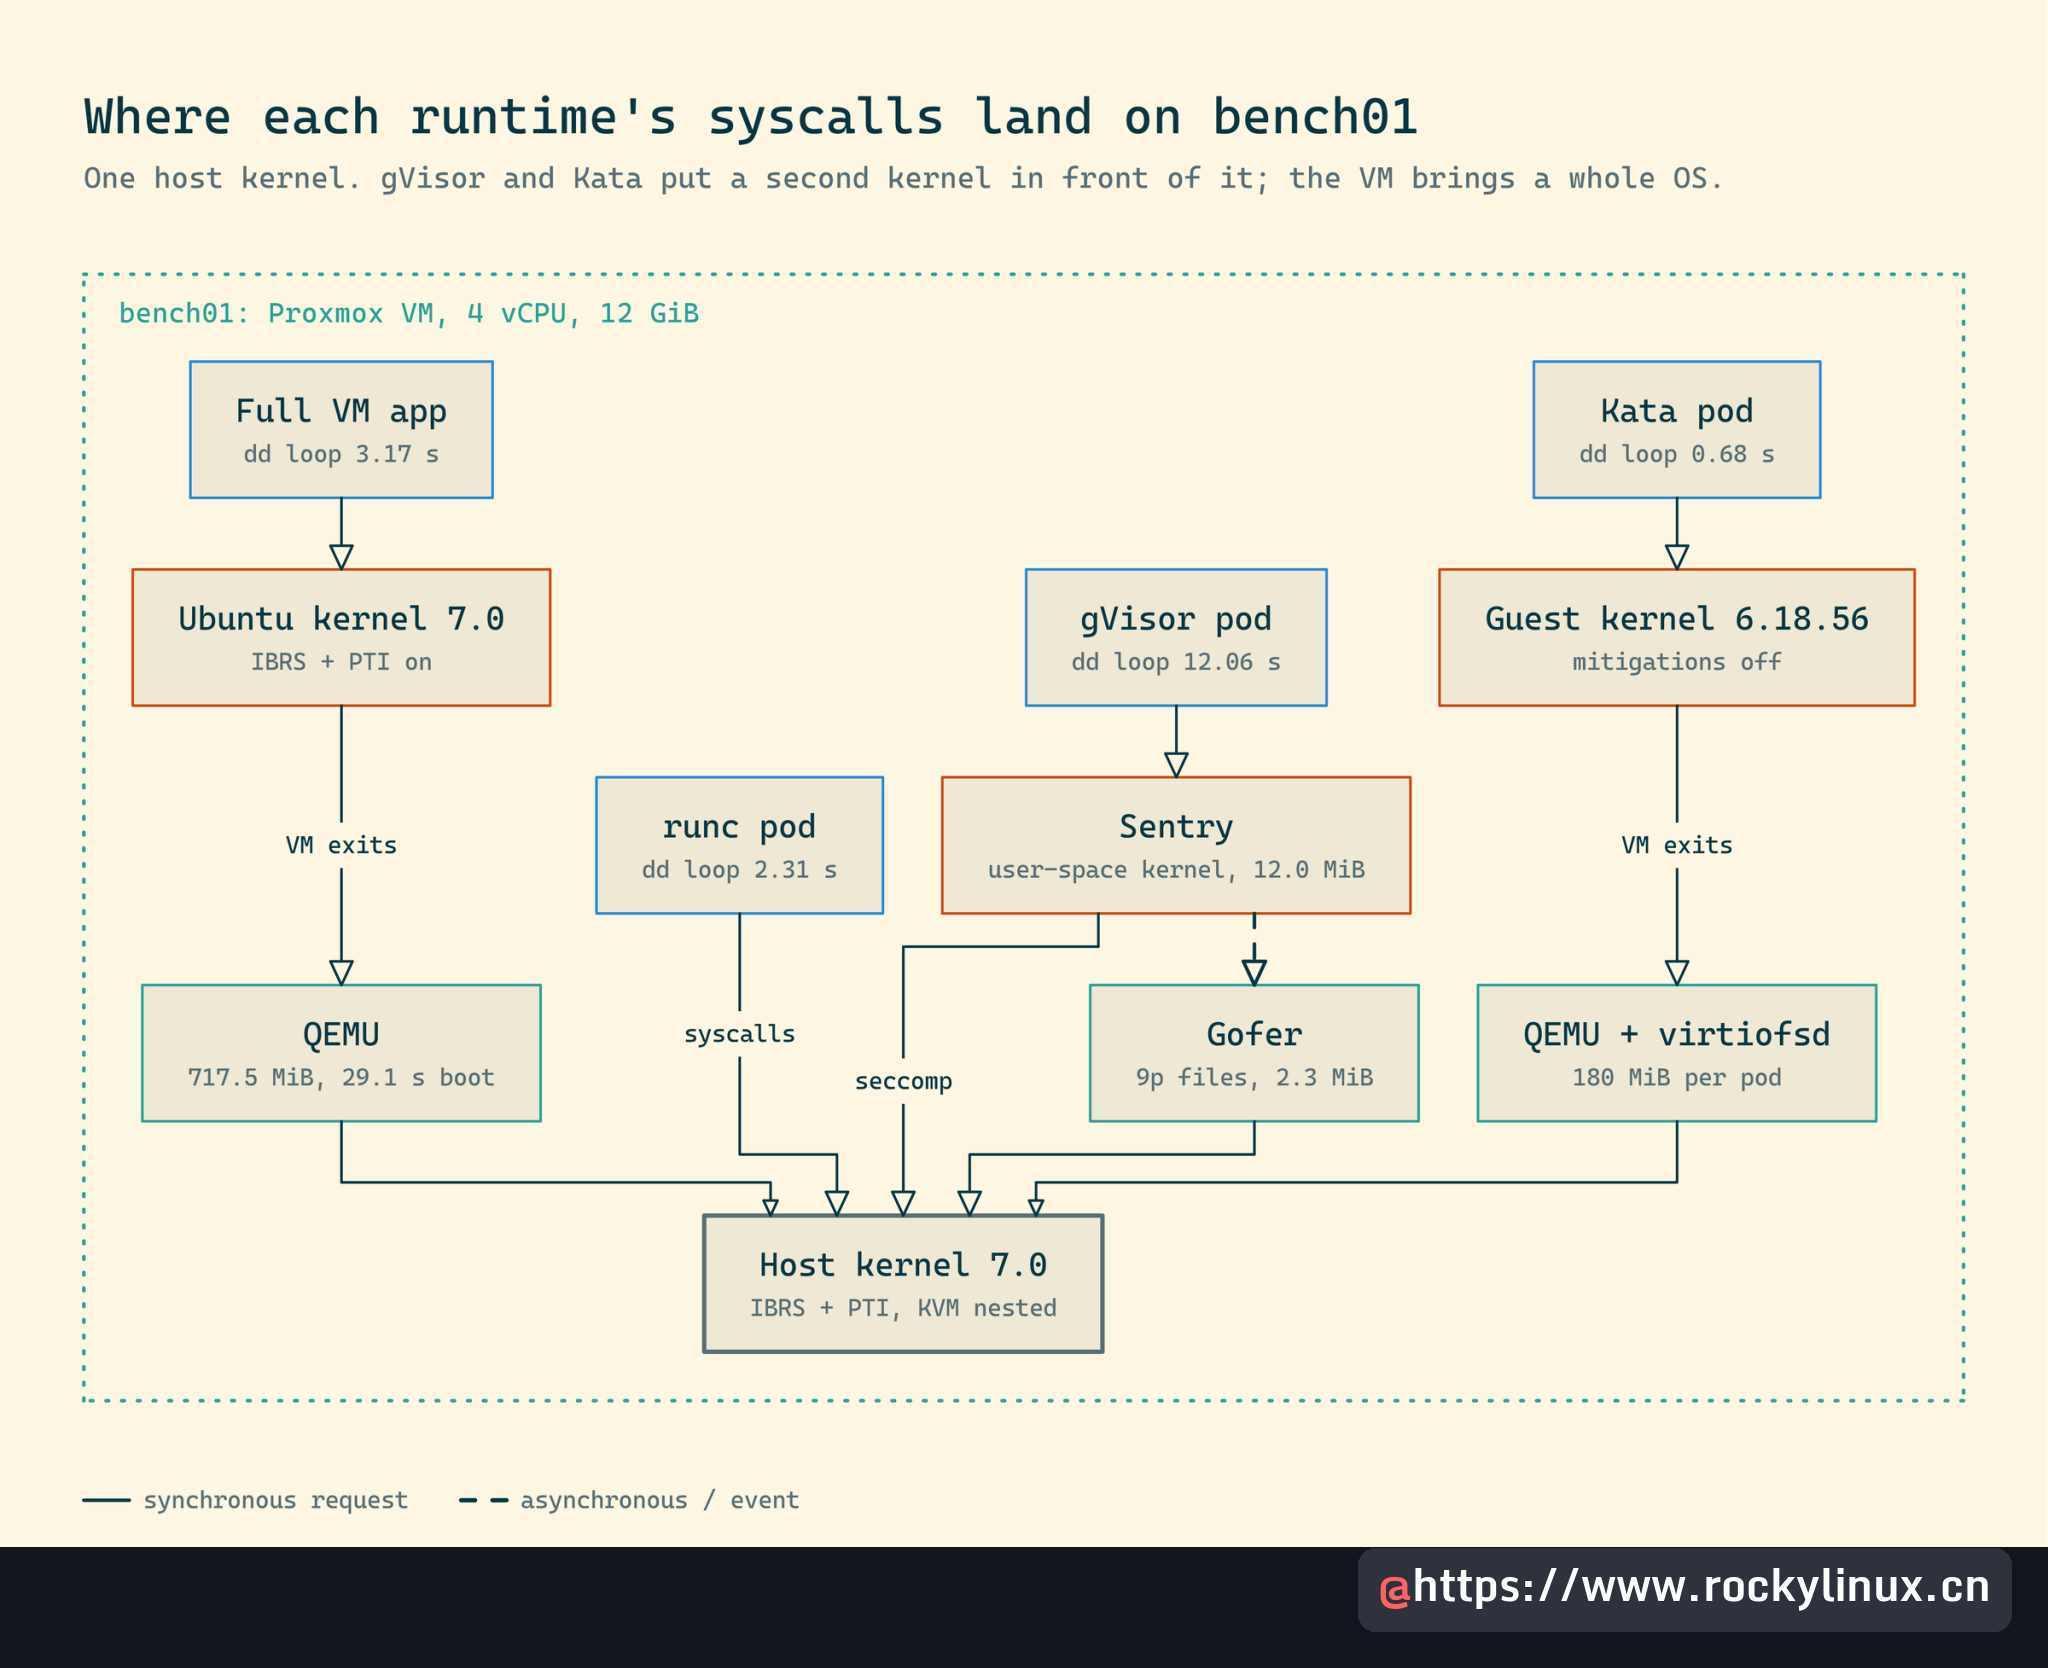
从图中的应用向下看,应用与宿主机内核之间增加的隔离层改变了攻击路径,也会带来运行成本:
- runc:在共享宿主机内核上使用 namespace(命名空间)、cgroup(控制组)和 seccomp(系统调用过滤)。容器能够触达的内核漏洞,也可能影响宿主机。
- gVisor:由 Go 编写的 Sentry 在用户空间实现 Linux 系统调用,并通过较小的 seccomp 允许列表访问宿主机。文件操作经过 gofer 进程,Pod 内看到的内核版本为
4.19.0-gvisor。 - Kata Containers:每个 Pod 获得一台轻量 QEMU 虚拟机及独立客户机内核,Kata 4.3.1 的测试内核为
6.18.56,文件通过 virtiofsd 提供。硬件虚拟化构成主要隔离边界。 - 完整虚拟机:使用与 Kata 类似的 KVM 边界,同时拥有完整发行版、初始化系统和独立磁盘镜像;本例由 Kubernetes 之外的工具管理。
Firecracker 在架构上更接近 Kata 所在的一层:它也是 Kata 可以驱动的 VMM(虚拟机监控器)。4.3.1 压缩包提供了 configuration-rs-fc.toml,但其 bin 目录只有 QEMU、Cloud Hypervisor 和 OpenVMM,没有 Firecracker 可执行文件,因此本次没有测试 Firecracker。其独立部署方式见 OpenNebula 上的 Firecracker 微虚拟机指南。
测试环境与方法
全部数据来自 Intel Core i7-6700 节点上的一台 Proxmox 虚拟机,分配 4 个 vCPU、12 GiB 内存,并将 CPU 类型设为 host,使其内部能够访问 /dev/kvm。因此,Kata 和完整虚拟机都属于嵌套客户机。
嵌套虚拟化会为特权操作增加额外的退出与切换成本,主要影响 Kata 启动和网络路径,裸机结果可能与这里存在明显差异。如果虚拟机内看不到 /dev/kvm,可以参考 KVM 嵌套虚拟化指南检查 CPU 标志。四种方案采用以下统一测量方式:
- 冷启动:预热一次后,测量
nerdctl run --rm alpine:3.22 true的实际耗时,共运行 20 次。完整虚拟机则从启动qemu-system-x86_64开始,直到首次 SSH 命令执行成功,共启动 5 次。 - Pod 就绪时间:在 k3s 上测量
kubectl apply加kubectl wait --for=condition=Ready的总耗时,运行 20 次,镜像已提前拉取。 - 内存:启动空闲 Pod 后等待 60 秒,计算宿主机
MemAvailable的下降量,再除以 Pod 数;同时与 shim、沙箱、QEMU 和 virtiofsd 的 PSS(按比例分摊的实际内存占用)总和交叉核对。 - 系统调用循环:BusyBox
dd每次复制一个字节,总计 1,000,000 字节,约产生两百万次读写调用,运行 5 次。完整虚拟机使用 Ubuntubusybox-static包提供的同一个 BusyBox 子命令。 - 磁盘:在 emptyDir 上运行 fio 4k 随机读写,读写比例 70/30,使用 psync、持续 30 秒,分别测试缓冲 I/O 和
--direct=1;另测顺序写入 1 GiB、最后执行 fsync。 - 网络:nginx 使用 2 个 worker 提供 1 KB 文件,宿主节点通过 wrk 发起测试,使用 2 个线程、64 个连接,预热 10 秒后运行 20 秒,共测 3 次。
每个 Pod 的限制为 2 个 CPU 和 1 GiB 内存。以下版本均从测试主机读取。独立 containerd 来自 nerdctl-full 套件,版本为 2.4.1,比测试当时的 2.4.2 落后一个补丁版本。
| 组件 | 测试主机上的版本 |
|---|---|
| 宿主操作系统与内核 | Ubuntu 26.04.1 LTS,7.0.0-15-generic |
| 独立 containerd,nerdctl-full 套件 | containerd 2.4.1,runc 1.5.2,nerdctl 2.4.1 |
| Kubernetes | k3s v1.37.1+k3s1,containerd 2.3.4-k3s1 |
| gVisor | apt 仓库中的 runsc release-20261026.0 |
| Kata Containers | 4.3.1 静态压缩包,runtime-rs shim、QEMU,客户机内核 6.18.56 |
| 完整虚拟机客户机 | Ubuntu 26.04 云镜像,2 个 vCPU、1 GiB 内存,virtio 磁盘与网卡 |
第一步:测量冷启动和 Pod 就绪时间
通过 nerdctl 启动容器时,runc 和 gVisor 都约为 0.61 秒,gVisor 初始化 Sentry 和 gofer 的成本没有超出 0.59~0.65 秒的正常波动范围。Kata 多出约 4 秒,主要用于启动 QEMU 客户机,嵌套虚拟化会进一步放大这一成本。Pod 路径还包含 Kubernetes 的处理时间:
| 路径,20 次运行 | runc | gVisor | Kata |
|---|---|---|---|
| nerdctl 启动,中位数 | 0.613 s | 0.612 s | 4.597 s |
| nerdctl 启动,p95 | 0.631 s | 0.634 s | 4.648 s |
| Pod 到 Ready,中位数 | 0.835 s | 0.951 s | 4.755 s |
| Pod 到 Ready,p95 | 0.864 s | 3.874 s | 4.892 s |
| Pod 到 Ready,最慢一次 | 0.879 s | 3.891 s | 4.913 s |
gVisor 的 p95 值需要单独解释。20 个 Pod 中有 16 个在 0.88~1.05 秒内就绪,连续四次测试,也就是第 9~12 次,需要 3.39~3.89 秒,此后恢复到较低水平。Kata 的 20 次结果最大差异没有超过 0.24 秒,虽然成本较高,但更加稳定。
对于每个任务都需要新沙箱的短任务队列,例如每个 AI 代理工具调用都启动一个 Pod,这种成本会累积。在本测试主机上依次创建 100 个沙箱,Kata 约需 8 分钟,gVisor 约需 1.6 分钟。
完整虚拟机使用已经准备好的磁盘,5 次从 qemu 命令到可用 SSH 登录的启动耗时为 28.4~33.8 秒,中位数 29.1 秒。这包括固件初始化、完整 systemd 启动和 SSH 服务,而精简后的 Kata 客户机不需要这些环节。与完整虚拟机相比,Kata 的 4.6 秒启动时间已经很快。
第二步:计算每个沙箱的内存成本
每个空闲 runc Pod 占用 5.3 MiB 宿主机内存,gVisor 为 30.9 MiB,Kata 为 179.9 MiB。进程级 PSS 与这一结果基本一致:gVisor 的 Sentry(runsc-sandbox,约 12.0 MiB)、两个约 2.3 MiB 的 gofer、两个约 1.9 MiB 的 runsc 辅助进程和两个约 5.0 MiB 的 shim,总计约 30 MiB。Kata 每个 Pod 的 QEMU 进程 PSS 为 179~185 MiB,此外还有约 2 MiB 的 virtiofsd 和约 7 MiB 的 Rust shim。
| 运行时 | 测量的空闲 Pod 数量 | 每个 Pod 的宿主机内存 | 主要用途 |
|---|---|---|---|
| runc | 10 | 5.3 MiB | shim 与应用进程 |
| gVisor | 10 | 30.9 MiB | Sentry、gofer、shim |
| Kata | 7 | 179.9 MiB | QEMU 客户机内存、virtiofsd、shim |
| 完整虚拟机 | 1 | 717.5 MiB | 完整 Ubuntu 启动实际触达的客户机页面,总分配量为 1 GiB |
Kata QEMU 配置中的 default_memory = 2048 并不意味着宿主机立即承担全部内存成本。启用 static_sandbox_resource_mgmt = true 后,客户机按 Pod 限制确定大小,示例 1 GiB Pod 内的 free 报告总内存 947 MiB。QEMU 按客户机实际触达的页面分配宿主机内存,因此初始成本主要来自精简内核和 agent。
随着负载增加,这个数字还会增长,因为客户机页缓存仍占用客户机内存。一台容纳 60 个小 Pod 的节点,仅沙箱自身就可能让 Kata 消耗约 10.5 GiB,而 gVisor 约为 1.8 GiB。对于节点容量规划,这一差异可能比吞吐量更关键。
Kata 只测量了 7 个 Pod,没有达到 10 个。两次测试中,第八个 Kata Pod 都停留在 Pending,提示 Insufficient cpu,但 kubectl describe node 显示 4000m CPU 中只请求了 2020m;runc 和 gVisor 都能达到 10 个。原因尚未查明,因此应自行验证小节点的 Kata 密度,不能只依赖请求量的算术推导。后面的错误章节保留了相关信息。
第三步:测试系统调用、磁盘和 HTTP 负载
这一部分体现了 gVisor 的性能开销,也解释了 Kata 为什么在部分测试中更快。系统调用循环使用 BusyBox dd,每次调用只移动一个字节,在各个 Pod 内执行:
kubectl exec b-gvisor -- sh -c 'time dd if=/dev/zero of=/dev/null bs=1 count=1000000'每种运行时执行 5 次,实际耗时依次如下:
| 运行时 | 第 1 次 | 第 2 次 | 第 3 次 | 第 4 次 | 第 5 次 |
|---|---|---|---|---|---|
| runc | 2.29 s | 2.31 s | 2.29 s | 2.41 s | 2.69 s |
| gVisor | 11.60 s | 12.56 s | 12.06 s | 11.83 s | 19.41 s |
| Kata | 0.67 s | 0.68 s | 0.69 s | 0.68 s | 0.69 s |
| 完整虚拟机 | 3.29 s | 2.81 s | 2.92 s | 3.37 s | 3.17 s |
gVisor 慢约五倍,是每次调用都经过 Sentry 的成本。Kata 比 runc 快约 3.4 倍,则不是虚拟化本身带来的加速。这台 Skylake CPU 的宿主机内核启用了针对 Spectre、retbleed 和 Meltdown 的 IBRS(间接分支限制推测)与页表隔离措施,每次系统调用都要付出相应成本。宿主机直接运行 dd 需要 2.28~2.72 秒,与 runc 基本一致。
Kata 客户机内核报告的部分漏洞缓解状态则不同:
kubectl exec mit-kata -- sh -c 'cd /sys/devices/system/cpu/vulnerabilities && for f in retbleed spectre_v2 mds meltdown spec_store_bypass; do echo "$f:$(cat $f)"; done'在该 Kata 客户机内,retbleed、Spectre v2、MDS 和推测存储绕过均显示 Vulnerable,只有 Meltdown 保留了 PTI(页表隔离):
retbleed:Vulnerable
spectre_v2:Vulnerable; IBPB: disabled; STIBP: disabled; PBRSB-eIBRS: Not affected; BHI: Vulnerable
mds:Vulnerable; SMT Host state unknown
meltdown:Mitigation: PTI
spec_store_bypass:Vulnerable
这体现了一种安全与性能取舍:客户机承载一个 Pod,由虚拟化边界和宿主机缓解措施承担跨沙箱保护,但同一 Kata Pod 内多个进程之间并没有这里列出的全部推测执行防护。完整虚拟机提供了对照:其标准 Ubuntu 内核在客户机内仍启用 IBRS 和 PTI,同一循环耗时 3.17 秒,更接近 runc,而不是 Kata。因此,速度差异与客户机缓解措施有关,不能归功于虚拟化。
测试只覆盖这颗 i7-6700。较新的 CPU 可以使用增强型 IBRS,宿主机每次系统调用的成本可能降低,runc 与 Kata 的差距也可能缩小。
磁盘结果必须结合挂载方式解读。runc 直接访问宿主机 ext4;gVisor 通过带有 cache=remote_revalidating 和 directfs 的 9p 挂载访问;Kata 使用 virtiofs:
| fio 测试 | runc | gVisor | Kata | 完整虚拟机 |
|---|---|---|---|---|
| 4k 缓冲随机读写,读取/写入 IOPS | 9,933 / 4,267 | 49,190 / 21,097 | 5,197 / 2,224 | 1,987 / 847 |
4k 随机读写,--direct=1,读取/写入 IOPS |
3,122 / 1,335 | 50,026 / 21,460 | 4,864 / 2,080 | 1,767 / 758 |
| 顺序写入 1 GiB,最后执行 fsync | 246.6 MiB/s | 245.7 MiB/s | 128.7 MiB/s | 97.3 MiB/s |
要求直接 I/O 后,gVisor 的随机 I/O 结果几乎没有变化,说明响应仍来自 Sentry 文件缓存,O_DIRECT 没有以预期方式到达宿主机磁盘。最后执行 fsync 的顺序写入才会迫使数据下刷,此时 gVisor 和 runc 都约为 246 MiB/s,表明大块写入时,gVisor 文件路径并非主要瓶颈。
Kata 的 virtiofs 路径让顺序写入吞吐量下降约一半;它的随机直接 I/O 又高于 runc,提示客户机 O_DIRECT 与物理磁盘之间仍受 virtiofsd 和宿主机页缓存影响。完整虚拟机的磁盘结果最慢:宿主机 ext4 上的 qcow2 覆盖层增加了一次转换,并使用 cache=none 打开,因此客户机写入通过宿主机直接 I/O 路径处理。数据库等依赖 O_DIRECT 语义的负载,应在选定运行时上自行验证,不能只比较一个随机 I/O 数字。
网络是两个沙箱方案表现最弱的一项。runc 下的 nginx 达到每秒 41,762 次请求,p99 为 2.70 毫秒;gVisor 在用户空间实现 TCP/IP 的 netstack 将其降至每秒 4,700 次、约 34 毫秒;Kata 只有每秒 1,966 次、约 63 毫秒。
嵌套虚拟化无法解释全部差异。同一宿主机上的完整虚拟机,通过 Linux 网桥上的普通 tap 设备,仍达到每秒 23,786 次请求、p99 9.60 毫秒,约为 Kata 的十二倍。区别与 Kata Pod 网络路径有关:4.3.1 配置使用 internetworking_model = "tcfilter",通过 tc 规则将 Pod veth 流量镜像到客户机 tap 设备,且 network_queues = 1,只有一个队列。本次没有进一步分离各部分成本。gVisor 的损耗来自宿主机上的用户态网络栈,不是嵌套虚拟化造成的。
第四步:在 containerd 旁安装 runsc 和 Kata
两个沙箱均通过 shim 接入 containerd。shim 是连接 containerd 与具体运行时的适配进程,只要位于 PATH 中即可使用,不会替换 runc。以下安装命令对应本次 Ubuntu 测试环境。
gVisor 提供 apt 仓库。添加密钥和软件源,然后安装 runsc 包;它会将 runsc、containerd-shim-runsc-v1 和辅助程序安装到 /usr/bin/gvisor-bin/ 下:
curl -fsSL https://gvisor.dev/archive.key | sudo gpg --dearmor -o /usr/share/keyrings/gvisor-archive-keyring.gpg
echo "deb [arch=$(dpkg --print-architecture) signed-by=/usr/share/keyrings/gvisor-archive-keyring.gpg] https://storage.googleapis.com/gvisor/releases release main" | sudo tee /etc/apt/sources.list.d/gvisor.list > /dev/null
sudo apt-get update && sudo apt-get install -y runsc
先确认版本,并验证二进制程序能够独立启动沙箱,再接入 containerd:
runsc --version
sudo runsc do uname -r
正常情况下会输出发布版本和 Sentry 对外呈现的内核版本:
runsc version release-20261026.0
spec: 1.2.1
4.19.0-gvisor
Kata 需要节点提供 /dev/kvm,下载前先检查。Kata 4.x 使用 zstd 压缩包,文件名为 kata-static-<version>-amd64.tar.zst;3.x 教程中的 .tar.xz,以及更早的 x86_64 命名,不适用于这一版本系列。下载地址中包含版本号,可以从 Kata Containers 发布页面对应的 API 获取最新标签;测试当天返回 4.3.1:
ls -l /dev/kvm
sudo apt-get install -y zstd
KATA_VERSION=$(curl -s https://api.github.com/repos/kata-containers/kata-containers/releases/latest | grep '"tag_name"' | cut -d '"' -f 4)
curl -fsSLO https://github.com/kata-containers/kata-containers/releases/download/${KATA_VERSION}/kata-static-${KATA_VERSION}-amd64.tar.zst
sudo tar --zstd -xf kata-static-${KATA_VERSION}-amd64.tar.zst -C /
4.x 默认使用 Rust 运行时,Go 运行时已弃用。主 kata-static 压缩包中没有 kata-runtime 命令,/opt/kata/bin 中也没有对应 shim;Go 组件转移到了独立的 kata-go-static 压缩包。
containerd 需要的是 runtime-rs 下的 Rust shim。它读取 /opt/kata/share/defaults/kata-containers/runtime-rs/configuration.toml,该文件指向 QEMU 配置。将 shim 链接到 PATH 中并检查:
sudo ln -sf /opt/kata/runtime-rs/bin/containerd-shim-kata-v2 /usr/local/bin/containerd-shim-kata-v2
containerd-shim-kata-v2 --version
输出标明它是 Rust 构建,同时给出版本和提交号:
Kata Containers containerd shim (Rust): id: io.containerd.kata.v2, version: 4.3.1, commit: 03cf2ec06a5d302f23af811744f6bcea49988bfb通过独立 containerd 做一次基本检查,比较两个沙箱的内核。nerdctl 使用 gVisor 时直接指定 runsc 二进制路径,原因见后面的错误章节:
sudo nerdctl run --rm --runtime /usr/bin/runsc alpine:3.22 uname -r
sudo nerdctl run --rm --runtime io.containerd.kata.v2 alpine:3.22 uname -r
第一行来自 Sentry,第二行来自 Kata 客户机,宿主机仍运行 7.0 内核。Kata 测试中 nerdctl 还会显示一条无害的 cannot set cgroup manager to "systemd" 警告,下面省略了该警告:
4.19.0-gvisor
6.18.56
如果 Kata 命令失败,先重新检查 /dev/kvm。没有它,QEMU 客户机无法启动,修改 containerd 配置也不能代替硬件虚拟化支持。
第五步:为 kubeadm 或 k3s 注册运行时
Kubernetes 通过 handler(处理器)名称选择运行时,对应 containerd 配置中 CRI(容器运行时接口)插件下的键。对于 kubeadm 节点,可以用 drop-in(附加配置)文件注册两个运行时,避免直接改动主配置。
containerd 2.4 的默认配置版本为 4,并导入 /etc/containerd/conf.d/*.toml;但节点完全没有 config.toml 时,也不会读取这些附加文件。先检查导入设置:
grep -n "^imports" /etc/containerd/config.toml文件不存在或没有输出时,需要生成带有 imports 的默认配置。已有 kubeadm 节点应在当前配置中添加导入行,保留 SystemdCgroup 等现有设置。以下生成命令仅用于新节点:
containerd config default | sudo tee /etc/containerd/config.toml >/dev/null
sudo mkdir -p /etc/containerd/conf.d
创建附加配置文件:
sudo vim /etc/containerd/conf.d/sandbox-runtimes.toml加入两个运行时。pod_annotations 允许 Kata 读取每个 Pod 的注解;privileged_without_host_devices 防止特权 Pod 自动将宿主机的全部设备传入客户机:
version = 4

[plugins.'io.containerd.cri.v1.runtime'.containerd.runtimes.runsc]
  runtime_type = "io.containerd.runsc.v1"

[plugins.'io.containerd.cri.v1.runtime'.containerd.runtimes.kata]
  runtime_type = "io.containerd.kata.v2"
  privileged_without_host_devices = true
  pod_annotations = ["io.katacontainers.*"]
重启 containerd,再读取合并后的配置:
sudo systemctl restart containerd
sudo containerd config dump | grep -A1 -E "runtimes\.(runsc|kata)\]"
两个 handler 都应出现,并带有对应 runtime_type。如果没有出现,检查是否缺少 imports 行:
        [plugins.'io.containerd.cri.v1.runtime'.containerd.runtimes.kata]
          runtime_type = 'io.containerd.kata.v2'
--
        [plugins.'io.containerd.cri.v1.runtime'.containerd.runtimes.runsc]
          runtime_type = 'io.containerd.runsc.v1'
k3s 使用自己的 containerd,不会自动发现 runsc 或 Kata,因此需要模板。应在安装 k3s 前创建;对于已运行的节点,保存模板后重启 k3s:
sudo mkdir -p /var/lib/rancher/k3s/agent/etc/containerd
sudo vim /var/lib/rancher/k3s/agent/etc/containerd/config-v3.toml.tmpl
第一行导入 k3s 自动生成的基础配置,后面继续添加同样的两个运行时:
{{ template "base" . }}

[plugins.'io.containerd.cri.v1.runtime'.containerd.runtimes.runsc]
  runtime_type = "io.containerd.runsc.v1"

[plugins.'io.containerd.cri.v1.runtime'.containerd.runtimes.kata]
  runtime_type = "io.containerd.kata.v2"
  privileged_without_host_devices = true
  pod_annotations = ["io.katacontainers.*"]
以下安装与基准测试一致的 k3s 版本。其余设置可参考 Ubuntu 26.04 的 k3s 指南;kubeadm 集群的 containerd 设置见 Ubuntu 26.04 的 kubeadm 指南:
curl -sfL https://get.k3s.io | INSTALL_K3S_VERSION=v1.37.1+k3s1 sh -   # https://github.com/k3s-io/k3s/releases
sudo grep -A3 -E "runtimes.(runsc|kata)\]" /var/lib/rancher/k3s/agent/etc/containerd/config.toml
生成后的 config.toml 应包含模板中的两个区块:
[plugins.'io.containerd.cri.v1.runtime'.containerd.runtimes.runsc]
  runtime_type = "io.containerd.runsc.v1"

[plugins.'io.containerd.cri.v1.runtime'.containerd.runtimes.kata]
  runtime_type = "io.containerd.kata.v2"
  privileged_without_host_devices = true
  pod_annotations = ["io.katacontainers.*"]
测试随后执行 sudo systemctl restart k3s,自动重新生成的配置仍保留了两个区块,因此持久配置应写入模板。
第六步:创建 gVisor 与 Kata 的 RuntimeClass
RuntimeClass(运行时类)将 Pod 使用的类名映射到 containerd handler。其 overhead 字段会将沙箱自身的额外资源开销加入每个 Pod 的资源请求,使调度器与 Pod cgroup 一并计费。
示例按第二步测得的内存设置开销。gVisor 空闲 Pod 为 30.9 MiB,配置 64Mi,为 Sentry 在负载下增长留出空间。Kata 保留项目 kata-deploy chart 为 QEMU 设置的 320Mi 内存和 250m CPU,既覆盖约 180 MiB 的空闲内存,也为客户机繁忙时 VMM 的增长留出余量。创建清单:
vim runtimeclasses.yamlhandler 必须与 containerd 中的运行时名称一致,而不一定与 RuntimeClass 的名称相同:
apiVersion: node.k8s.io/v1
kind: RuntimeClass
metadata:
  name: gvisor
handler: runsc
overhead:
  podFixed:
    memory: "64Mi"
    cpu: "100m"
---
apiVersion: node.k8s.io/v1
kind: RuntimeClass
metadata:
  name: kata
handler: kata
overhead:
  podFixed:
    memory: "320Mi"
    cpu: "250m"
应用配置并列出两个运行时类:
kubectl apply -f runtimeclasses.yaml
kubectl get runtimeclass gvisor kata
k3s 也会列出自身检测到的 crun、WebAssembly shim 和 NVIDIA 运行时等;这里的 gvisor 和 kata 则由清单创建:
NAME     HANDLER   AGE
gvisor   runsc     24s
kata     kata      24s
如果 RuntimeClass 指定的 handler 没有在 containerd 中注册,Pod 不会自动退回 runc。因此名称写错的结果是 Pod 无法启动,而不是悄悄在没有沙箱的情况下运行。
第七步:启动沙箱 Pod 并核对资源开销
Pod 只需通过 runtimeClassName 选择沙箱,其余配置可以保持一致,便于只对需要额外隔离的工作负载启用沙箱。创建测试 Pod:
vim sandbox-test.yaml下面的 Pod 输出内核版本与内核日志前几行,然后进入休眠:
apiVersion: v1
kind: Pod
metadata:
  name: sandbox-test
spec:
  runtimeClassName: gvisor
  containers:
  - name: shell
    image: docker.io/library/alpine:3.22
    command: ["sh", "-c", "uname -r; dmesg | head -3; sleep 3600"]
    resources:
      requests:
        cpu: 100m
        memory: 64Mi
      limits:
        memory: 256Mi
应用清单,等待 Ready,再查看日志:
kubectl apply -f sandbox-test.yaml
kubectl wait --for=condition=Ready pod/sandbox-test --timeout=180s
kubectl logs sandbox-test
gVisor 会返回自己的内核版本以及带有幽默内容的启动日志,可以快速确认 Pod 看到的不是宿主机内核:
4.19.0-gvisor
[   0.000000] Starting gVisor...
[   0.382965] Reading process obituaries...
[   0.880296] DeFUSEing fork bombs...
测试 Kata 时,将同样的 Pod 改为 runtimeClassName: kata,名称改为 kata-test。日志应显示 6.18.56 和真实的 Linux 内核启动信息。随后确认准入处理是否已将额外开销写入 Pod 规范:
kubectl get pod sandbox-test -o jsonpath='{.spec.overhead}'; echo
kubectl get pod kata-test -o jsonpath='{.spec.overhead}'; echo
每个 Pod 都携带对应运行时类的开销:
{"cpu":"100m","memory":"64Mi"}
{"cpu":"250m","memory":"320Mi"}
节点视图可以显示调度器实际计入的资源。gVisor Pod 原本请求 100m CPU、64Mi 内存,加上开销后计为 200m、128Mi;Kata Pod 的同样请求计为 350m、384Mi,内存限制也从 256Mi 增至 576Mi:
kubectl describe node bench01 | grep -E "kata-test|sandbox-test"下面各列依次为 CPU 请求、CPU 限制、内存请求、内存限制:
  default                     kata-test                                  350m (8%)     0 (0%)      384Mi (3%)       576Mi (4%)     15s
  default                     sandbox-test                               200m (5%)     0 (0%)      128Mi (1%)       320Mi (2%)     24s
这一内存限制调整对 Kata 很关键。4.3.1 QEMU 配置默认 sandbox_cgroup_only = true,意味着 QEMU 自身也位于 Pod cgroup 中。kata-deploy chart 将 QEMU 内存开销从 160Mi 调至 320Mi,原因就是较低的值可能使内存限制较小的 Pod 中的 QEMU 被 OOM(内存不足)机制终止。
调度器和 kubelet 如何应用该字段,见 Kubernetes 的 Pod 额外开销文档。如果需要确保不可信命名空间始终使用沙箱,还应将 RuntimeClass 与准入策略配合使用;命名空间侧的配置见 Pod 安全标准指南。
测试中遇到的错误与处理
以下问题均出现在这套测试环境中,保留了对应的原始错误文本。
gVisor:sandbox no longer running and its exit status is unavailable
在独立 containerd 中,通过自己的 shim 运行 gVisor,例如 ctr run --runtime io.containerd.runsc.v1 或 nerdctl run --runtime io.containerd.runsc.v1,可能没有任何输出并以 128 退出。打开 shim 调试日志后,可以看到该错误,且 shim 首次调用 runsc 耗时 5.0 秒。
应用本身实际运行过,Sentry 启动日志记录了 application exiting with exit status 0,只是标准输出没有传到终端。Kubernetes 路径没有出现这个问题,k3s CRI 在本次所有 Pod 中都能正常使用同一 shim。nerdctl 可改为通过 runc shim 将 runsc 作为 OCI 二进制程序调用,Docker 也使用类似方式:
sudo nerdctl run --rm --runtime /usr/bin/runsc alpine:3.22 uname -r该形式输出 4.19.0-gvisor 并返回 0,前面的 gVisor 冷启动数据采用的就是这条路径。
nerdctl -d 配合 gVisor:failed to start io pipe copy
在 runsc shim 上以后台模式运行 nerdctl 容器时,错误为:
failed to create shim task: failed to start io pipe copy: gvisor-containerd-shim: opening binary:///usr/local/bin/nerdctl?_NERDCTL_INTERNAL_LOGGING=...: no such file or directory
nerdctl 将日志驱动的 binary:// 日志 URI 传给 containerd,而 gVisor shim 尝试将其当作文件路径打开。同样改用 --runtime /usr/bin/runsc 可以避开这一问题。
Kata 4.x:kata-runtime: command not found
解压 4.3.1 后,如果按旧教程链接 /opt/kata/bin/containerd-shim-kata-v2 和 /opt/kata/bin/kata-runtime,会出现 bash: line 19: kata-runtime: command not found,因为这两个文件不在主要的 4.x 压缩包中,已弃用的 Go 运行时转移到了 kata-go-static。
顶层 configuration.toml 还可能是指向已不再提供的 configuration-qemu.toml 的失效链接。应使用第四步的 /opt/kata/runtime-rs/bin/containerd-shim-kata-v2;Rust shim 读取 runtime-rs 配置目录,不需要 kata-runtime 命令。
Kata Pod 一直 Pending:0/1 nodes are available: 1 Insufficient cpu
逐个创建空闲 Kata Pod,每个请求 10m CPU,再加上 250m 开销时,第八个 Pod 始终无法调度。Pod 事件显示:
0/1 nodes are available: 1 Insufficient cpu. preemption: 0/1 nodes are available: 1 No preemption victims found for incoming pod.
与此同时,节点已分配资源却显示 cpu 2020m (50%)。保留七个 Kata Pod 运行时,请求 240m 和 250m 的普通 runc 探测 Pod 都能在同一节点上调度成功,说明节点仍能容纳同等大小的普通 Pod。
该现象复现了两次,但原因尚未找到。应在自己的小节点上测试 Kata Pod 密度;沙箱 Pod 长时间 Pending 时,检查 kubectl describe pod 中的事件。
containerd 2.4:Configuration migrated from version 3
以 version = 3 开头的 config.toml 仍可在 containerd 2.4 中加载,但会记录:“Configuration migrated from version 3, use containerd config migrate to avoid migration”。
版本 3 与版本 4 的相关 CRI 插件键没有变化,因此新文件可使用 version = 4;旧文件可通过 containerd config migrate 迁移。
根据工作负载选择运行时与 AI 代理沙箱
这些结果支持按负载选择隔离层。在多数集群中,可以默认使用 runc,再为运行非自有代码的 Pod 配置 RuntimeClass:
- 自行构建并扫描的可信服务:使用 runc。它在这组测试的网络与启动指标中表现最好,但仍需接受共享宿主机内核的攻击面。
- 短时运行的不可信代码,例如 AI 代理工具调用、Notebook 单元或来自 fork 的 CI 作业:可考虑 gVisor。本次 Pod 就绪时间中位数不足一秒,每个沙箱约 31 MiB,适合按任务创建;前提是负载不依赖密集系统调用或高网络吞吐。
- 计算密集、系统调用密集,或者需要真实 Linux 内核的不可信代码:可考虑 Kata。它在本次系统调用循环中最快,并支持 gVisor 未实现的内核功能。应预留约 4~5 秒启动时间、每个 Pod 约 180 MiB 的空闲内存;需要即时响应时,可维护预热沙箱池。同时评估前文说明的客户机缓解措施差异。
- 需要独立操作系统、内核模块或单独生命周期的长期租户:完整虚拟机更合适。本例普通 KVM 虚拟机不通过 Pod/RuntimeClass 直接调度,启动也最慢,但能让租户在自己的完整内核和操作系统上拥有 root 权限。
网络密集且不可信的服务最难取舍。本测试中,gVisor 保留了 runc 约十分之一的请求率,Kata 不到二十分之一,普通虚拟机则超过一半。如果服务需要持续处理实际流量,在决定前值得验证每租户一台虚拟机的方案,或在裸机上重新测试 Kata;本次两种沙箱的网络性能都明显落后于 runc。
运行时与 containerd、CRI-O 之间的层次关系,可参考 Docker、CRI-O 与 containerd 对比以及 在 Kubernetes 中使用 containerd。