选择 Ollama 模型的第一步不是看排行榜,而是看你手上到底有多少内存。16 GB 显卡可以用 64K 上下文运行 gpt-oss:20b,达到每秒 95 token;而文件只有约 15 GB 的 devstral-small-2 一旦溢出到系统内存,就会跌到每秒 5.5 token。本文按 8 GB、12 GB、16 GB、24 GB、32 GB、48 GB 以上显存以及 16 GB Apple Silicon 分别给出模型选择,并附实测速度、许可证、量化、显存公式和常用命令。
测试使用 Ollama 0.40.6,在 RTX 4090、RTX 5060 Ti 16 GB 和 16 GB M4 MacBook Pro 上运行;两项 10 月下旬补充测试使用 Ollama 0.40.11,在无 GPU 的 Ubuntu 26.04 虚拟机完成。
按显存选择模型
| 显存或内存 | 通用聊天 | 编码 | 视觉 |
|---|---|---|---|
| 4 GB 或 8 GB 内存纯 CPU | llama3.2:3b、qwen3.5:2b |
qwen2.5-coder:1.5b |
qwen3.5:2b(约 2.7 GB) |
| 8 GB | qwen3.5:9b、ornith-1.5:9b、bonsai-2、llama3.1:8b |
qwen2.5-coder:7b |
qwen3.5:9b |
| 12 GB | gemma4:12b、bonsai-2:27b(8.3 GB) |
qwen2.5-coder:14b Q4 |
gemma4:12b、bonsai-2:27b |
| 16 GB | gpt-oss:20b(95 tok/s)、ornith-1.5:9b(72)、bonsai-2:27b(44) |
gpt-oss:20b、qwen2.5-coder:14b Q5 |
gemma4:12b-it-qat(53)、ornith-1.5:9b |
| 24 GB | ornith-1.5:35b(215)、qwen3.8:27b、gpt-oss:20b(195)、gemma4:26b |
qwen3-coder:30b、devstral-small-2、glm-4.7-flash |
nemotron-3.5-bolt(114)、qwen3.8:27b、gemma4:26b |
| 32 GB | nemotron-3.5-bolt 全 GPU;所有 24 GB 选择并留余量 |
同 24 GB,且有长上下文余量 | nemotron-3.5-bolt |
| 48 GB 以上 | llama3.3:70b、gpt-oss:120b(80 GB)、mistral-medium-3.5:128b(96 GB+) |
qwen3-coder:30b Q8、devstral-small-2 Q8 |
qwen3-vl:32b、llama3.2-vision:90b |
| 16 GB Apple Silicon | gemma4:e4b-it-qat(30)、bonsai-2(27)、qwen3.5:9b MLX(24) |
qwen2.5-coder:7b |
gemma4:e4b-it-qat、qwen3.5:9b |
16 GB 档位最容易误判。RTX 5060 Ti 上,gpt-oss:20b 在 4K 上下文占用 12.7 GB,在 64K 上下文也只有 12.8 GB,因为滑动窗口注意力让 KV 缓存增长很小,所以它能 100% 留在 GPU 上并维持约 95 token/s。相反,qwen3.8:27b 文件 17 GB,只有 73% 在 GPU,速度降到 15 token/s;devstral-small-2 在 64K 上下文更会跌到 5.5 token/s。
Apple Silicon 应把统一内存视为显存,并为 macOS 预留约四分之一。16 GB M4 在同时打开浏览器和编辑器时,gemma4:e4b-it-qat 约 29.8 token/s,bonsai-2 约 26.8 token/s,qwen3.5:9b 走 MLX 约 24.2 token/s,足以聊天,但不适合长时间编码代理任务。
列出、查看与管理模型
| 命令 | 内容 | 关注点 |
|---|---|---|
ollama list / ollama ls |
磁盘上的全部模型 | SIZE 是下载大小,也是内存占用下限 |
ollama ps |
已加载模型 | PROCESSOR 显示 GPU/CPU 比例,CONTEXT 显示上下文 |
ollama show <model> |
单个模型详情 | 参数、上下文、量化、能力、最低 Ollama 版本 |
curl localhost:11434/api/tags |
已安装模型 JSON | 名称、字节大小、摘要、量化 |
curl localhost:11434/api/ps |
已加载模型 JSON | 比较 size_vram 与 size,发现溢出 |
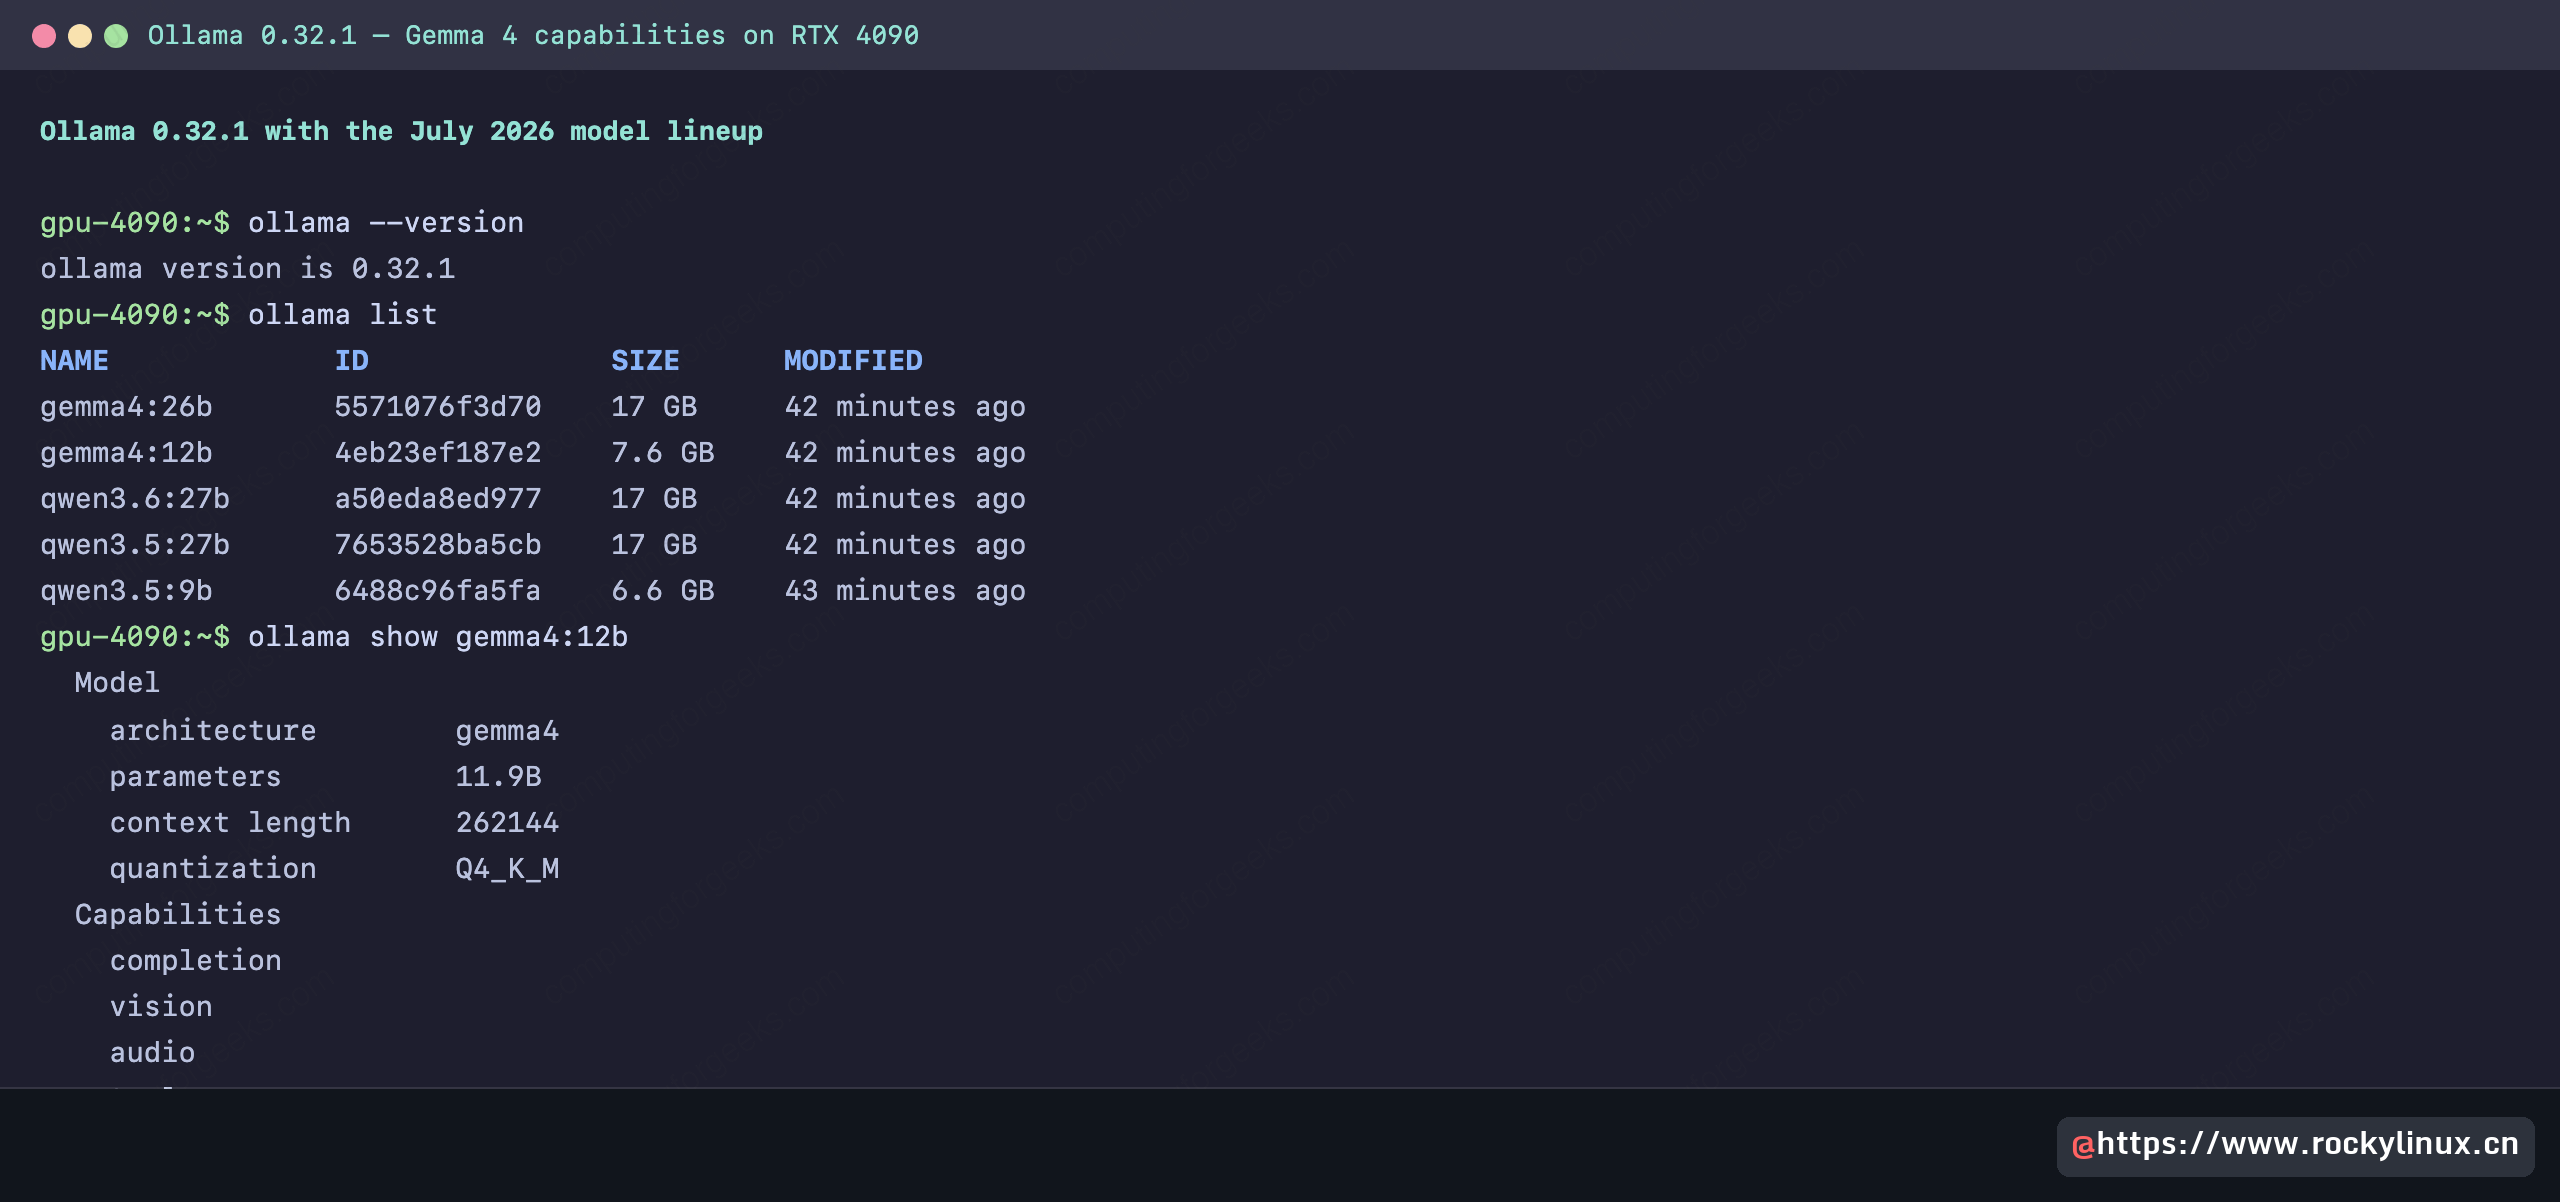
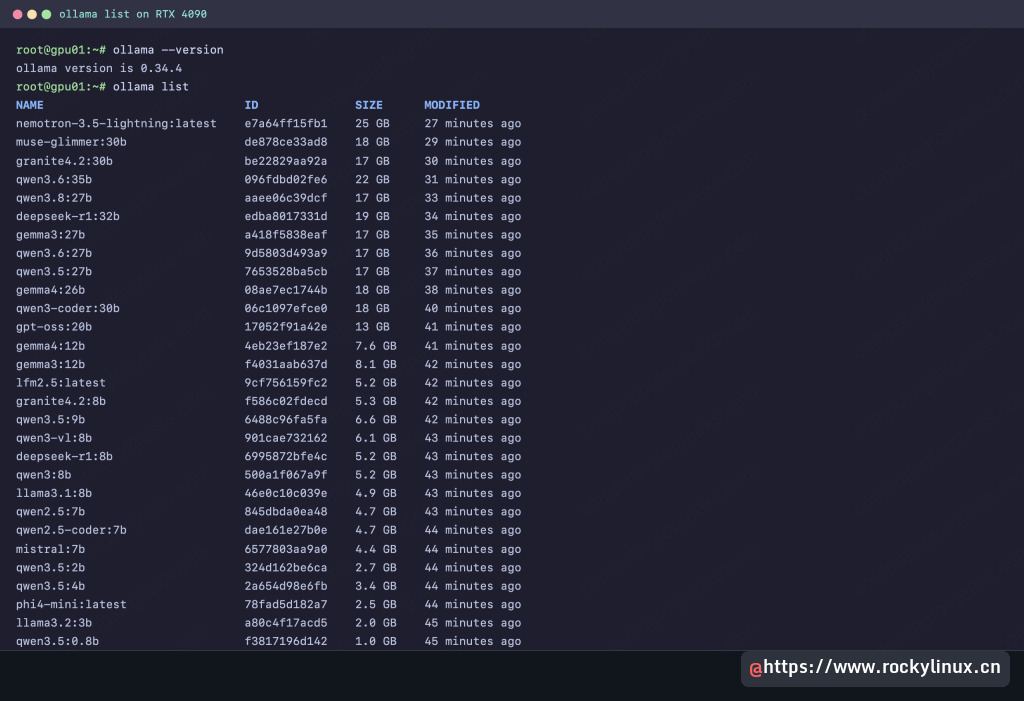
ollama list示例:
NAME                       ID              SIZE      MODIFIED
devstral-small-2:latest    24277f07f62d    15 GB     4 minutes ago
qwen3.8:27b                aaee06c39dcf    17 GB     25 minutes ago
llama3.1:8b                46e0c10c039e    4.9 GB    27 minutes ago
nimble:latest              6aa3fde96874    9.5 GB    28 minutes ago
bonsai-2:27b               f3c4f4208659    8.3 GB    28 minutes ago
gemma4:12b-it-qat          38044be4f923    7.2 GB    31 minutes ago
脚本读取:
curl -s http://localhost:11434/api/tags \
  | jq -r '.models[] | "\(.name)\t\(.size)"'
加载模型后查看运行状态:
ollama ps示例:
NAME                     ID              SIZE      PROCESSOR    CONTEXT    RUNNER      UNTIL
nemotron-3.5-bolt:e4b    69f2be39b309    2.9 GB    100% CPU     4096       llamacpp    4 minutes from now
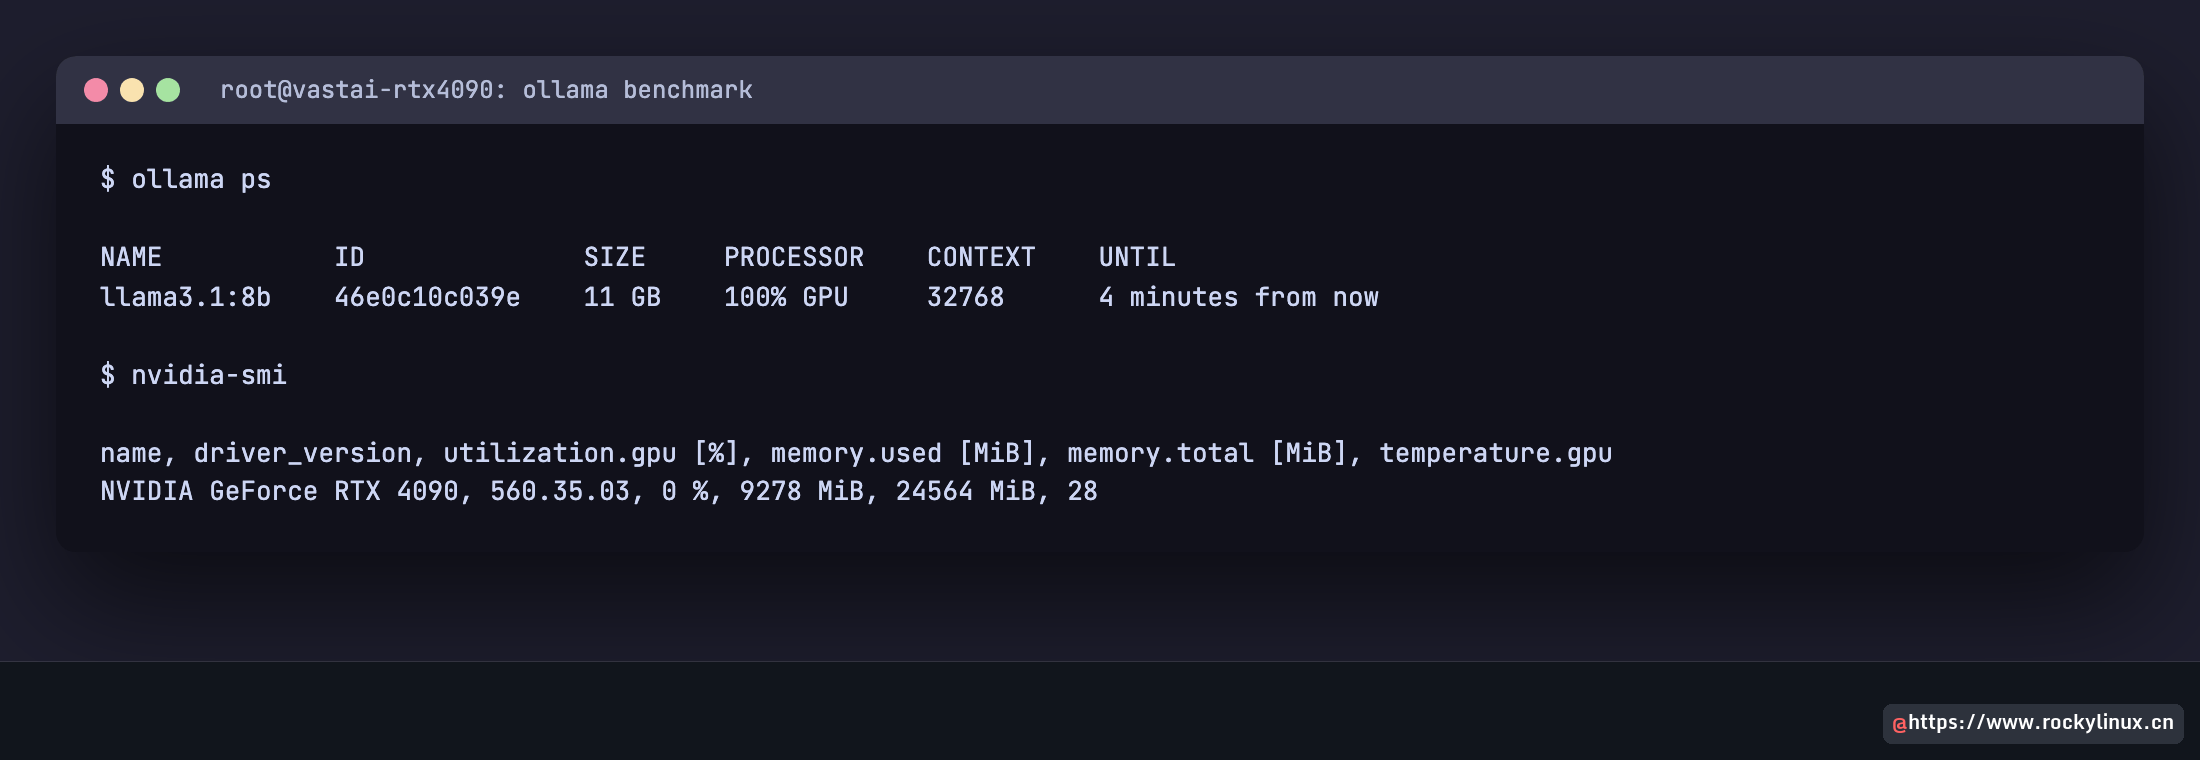
理想值是 100% GPU。出现 27%/73% CPU/GPU 说明部分权重已溢出到系统内存。对 Bolt 这类 MoE,SIZE 可能低估实际占用,应同时执行 free -m 或 nvidia-smi。
ollama show 还会显示模型能力、上下文、量化和渲染器:
查看模型细节:
ollama show d3:2b关键信息包括 requires、renderer、template source 和 Capabilities。如果 Capabilities 只有 decision,前端不会把它用于普通聊天。
查看 Modelfile:
ollama show --modelfile llama3.1:8b输出可看到系统提示词、模板、默认参数、许可证和底层 GGUF 路径。
安装 Ollama
Linux:
curl -fsSL https://ollama.com/install.sh | sh
ollama --version示例输出:ollama version is 0.40.11。安装器会检测 GPU,将二进制放到 /usr/local/bin/ollama,创建 ollama 系统用户并注册 systemd 服务,API 默认监听 127.0.0.1:11434。
macOS 从官网下载 .dmg,Windows 使用 .exe 安装器。Ollama 0.40 起在受支持的 Apple 架构上优先使用 MLX 运行器,但并非所有标签都有 MLX 构建;ollama ps 会显示实际使用的 runner。
按任务浏览模型库
模型库有数百个标签,但主要分为五类:聊天、编码、视觉、嵌入和决策模型。编码模型不是聊天模型的附加模式,嵌入模型不是小型聊天模型,决策模型甚至不能对话。
能力与许可证
| 模型 | 大小 | 上下文 | 工具 | 思考 | 视觉 | 许可证 |
|---|---|---|---|---|---|---|
gpt-oss:20b |
13 GB | 128K | 是 | 是 | 否 | Apache 2.0 |
qwen3.8:27b |
17 GB | 256K | 是 | 是 | 是 | Apache 2.0 |
qwen3.6:35b |
22 GB | 256K | 是 | 是 | 是 | Apache 2.0 |
qwen3.5:9b |
6.6 GB | 256K | 是 | 是 | 是 | Apache 2.0 |
gemma4:12b |
8.0 GB | 256K | 是 | 是 | 是,含音频 | Apache 2.0 |
gemma4:26b |
18 GB | 256K | 是 | 是 | 是,含音频 | Apache 2.0 |
bonsai-2:27b |
8.3 GB | 256K | 是 | 是 | 是 | Apache 2.0 |
nemotron-3.5-bolt |
25 GB | 256K | 是 | 是 | 是 | OpenMDW 1.1 |
devstral-small-2 |
15 GB | 384K | 是 | 否 | 是 | Apache 2.0 |
qwen3-coder:30b |
18 GB | 256K | 是 | 否 | 否 | Apache 2.0 |
llama3.1:8b |
4.9 GB | 128K | 是 | 否 | 否 | Llama 3.1 Community |
deepseek-r1:8b |
5.2 GB | 128K | 是 | 是 | 否 | MIT |
Llama 3.1 Community 在产品月活超过 7 亿时需要 Meta 单独授权,分发时还要保留 “Built with Llama” 标记。Nemotron 的 NVIDIA Open Model License 和 OpenMDW 也不是通用 OSI 许可证。使用 ollama show --license <model> 查看完整文本。
通用聊天与推理
| 模型 | 尺寸 | 默认文件 | 上下文 | 工具 | 适合 |
|---|---|---|---|---|---|
gpt-oss |
20b、120b | 13/65 GB | 128K | 是 | 开放权重 MoE,20b 适合 16 GB,120b 适合单张 80 GB |
llama3.3 |
70b | 43 GB | 128K | 是 | 稳固的传统 70B 基线 |
llama3.2 |
1b、3b | 1.3/2.0 GB | 128K | 是 | 设备端、边缘、快速工具路由 |
llama3.1 |
8b、70b、405b | 4.9 GB 起 | 128K | 是 | 8B 通用安全基线 |
mistral-nemo |
12b | 7.1 GB | 128K | 是 | 多语言、8B 升级 |
mistral-small |
22b、24b | 14 GB | 32K–128K | 原生 | JSON、函数调用、代理工作负载 |
gemma4 |
e2b–31b | 8–20 GB | 256K | 原生 | 多模态、工具、思考一体化 |
deepseek-r1 |
1.5b–671b | 视尺寸 | 128K–160K | 是 | 数学和链式推理;小尺寸为蒸馏版 |
qwen3.8 |
27b | 17 GB | 256K | 是 | 单张 24 GB 卡上的高性价比多模态模型 |
qwen3.6 |
27b、35b | 17/22 GB | 256K | 是 | 代理式编码和长任务推理 |
qwen3.5 |
0.8b–122b | 视尺寸 | 256K | 是 | 全尺寸多模态、防御式 MoE 架构 |
编码模型
| 模型 | 尺寸 | 上下文 | FIM | 适合 |
|---|---|---|---|---|
qwen3-coder |
30b、480b | 256K–1M | 是 | 30B-A3B,24 GB 卡上的本地编码首选 |
qwen2.5-coder |
0.5b–32b | 32K | 是 | 最佳中小型编码家族 |
deepseek-coder-v2 |
16b、236b | 160K/4K | 是 | 长文件重构 |
codegemma |
2b、7b | 8K | 是 | 编辑器内联补全 |
starcoder2 |
3b、7b、15b | 16K | 是 | 许可证优先、600+ 语言 |
devstral |
24b | 128K | 是 | Mistral 的本地代理编码 |
视觉与嵌入
| 模型 | 尺寸 | 上下文 | 说明 |
|---|---|---|---|
qwen3.8 |
27b | 256K | 新通用 Qwen 内置视觉、工具和聊天能力 |
qwen3-vl |
2b–235b | 256K–1M | 当前最强开放视觉语言家族之一 |
gemma4 |
12b、26b、31b | 256K | 紧凑多模态,所有尺寸均支持视觉 |
llama3.2-vision |
11b、90b | 128K | 较旧但仍可用的视觉模型 |
llava |
7b、13b、34b | 32K/4K | 轻量 CPU 视觉实验 |
嵌入模型:embeddinggemma(622 MB、768 维、100+ 语言)、nomic-embed-text(274 MB、768 维、本地 RAG 默认值)、mxbai-embed-large(670 MB、1024 维、英文高召回)、bge-m3(1.2 GB、1024 维、多语言长文档和稀疏向量)。
调用嵌入 API:
curl http://localhost:11434/api/embed -d '{
  "model": "nomic-embed-text",
  "input": ["First doc to embed.", "Second doc to embed."]
}'
显存估算与上下文
完整占用 = 权重 + KV 缓存 + 运行时开销。当前 Ollama 会根据显存自动选择默认上下文:低于 24 GiB 为 4K,24 到 48 GiB 为 32K,48 GiB 以上为 256K,但不超过模型训练上限。
VRAM_weights ≈ (参数十亿数 × 每权重 bit 数 / 8) GB
VRAM_kv      ≈ 层数 × 2 × KV头数 × head_dim × 上下文 token 数 × 2 字节
Total        ≈ 权重 × 1.15 + KV + 约 0.5 GB Ollama 运行时
1.15 倍用于激活和 CUDA 工作区。Llama 3.1 8B Q4_K_M 示例:
权重     : 8 × 4.5 / 8 = 4.5 GB → ×1.15 ≈ 5.2 GB
8K KV   : 32 × 2 × 8 × 128 × 8192 × 2 ≈ 1.1 GB
32K KV  : ≈ 4.3 GB
总计    : 8K 约 6.8 GB;32K 约 10 GB
在 32K 上下文下,8B 仍可放进 24 GB 卡;真正危险的是 30B 以上稠密模型。一个 32B Q4 模型权重约 20 GB,再叠加长上下文就会溢出。可设置 OLLAMA_KV_CACHE_TYPE=q8_0 将 KV 缓存减半,或设置 OLLAMA_CONTEXT_LENGTH / num_ctx 限制上下文。
量化选择
| 标签 | 实际 bit/权重 | 相对 FP16 | 质量 | 选择时机 |
|---|---|---|---|---|
| FP16 | 16.0 | 100% | 基准 | 微调、评测基线 |
Q8_0 |
8.5 | 约 53% | 与 FP16 几乎无差别 | 显存充足,要求最高质量 |
Q6_K |
6.5625 | 约 41% | 接近无损 | Q5 略差,Q8 放不下 |
Q5_K_M |
5.5 | 约 34% | 优秀 | 质量优先且有显存 |
Q4_K_M |
4.5 | 约 28% | 推荐默认 | 综合平衡最佳 |
Q3_K_M |
3.4375 | 约 22% | 明显下降 | 24 GB 勉强跑 70B 的最后选择 |
Q2_K |
2.625 | 约 17% | 质量断崖 | 仅应急 |
绝大多数任务使用 Q4_K_M。有约 30% 显存余量且对质量敏感时选 Q5_K_M 或 Q6_K。需要更大模型类别才降到 Q3_K_M,并用自己的评测确认。显式拉取指定量化:
ollama pull llama3.1:8b-instruct-q5_K_M
ollama pull qwen2.5-coder:7b-instruct-q8_0
ollama pull deepseek-r1:14b-qwen-distill-q4_K_M
模型家族选择
- Llama:
llama3.1:8b仍是 12 GB 以下通用聊天基线;llama3.2:1b/3b适合边缘;llama3.3:70b需要 48 GB 以上;Llama 4 Scout/Maverick 分别约 67 GB 和 245 GB。 - gpt-oss:
20b约 13 GB,在 16 GB 卡上可运行;120b约 65 GB,适合 80 GB GPU 或多卡。 - Mistral:Nemo 12B 是多语言升级选择;Mistral Small 适合 JSON、函数调用和代理;Mixtral 需要至少 48 GB。
- Gemma 4:12B 可放 12 GB,26B 是 26B-A4B MoE,在 24 GB 卡上以接近 4B 的速度运行,并原生支持视觉、工具和思考。
- DeepSeek R1:1.5B 到 70B 都是蒸馏版,只有
deepseek-r1:671b是完整模型。14B/32B 适合数学和分步推理,但不等同于 Claude/GPT-4。 - Qwen:
qwen2.5-coder仍是小模型编码首选;24 GB 新任务优先qwen3.8:27b或qwen3-coder:30b;qwen3.5从 0.8B 到 122B,全尺寸原生多模态。 - Phi/llava/codegemma/starcoder2:Phi 4 适合 STEM 但工具调用弱;llava 适合轻量视觉实验;codegemma 适合内联补全;starcoder2 适合许可证优先的场景。
决策模型:路由与分类
决策模型不写文本,而是读取一段 state,并回答带概率的判断题或多分类问题。常见模型包括 nimble、nimble-v3、tev1、clef、pplx-decider、d3、kev、laya 和 strands-decider。
示例:
echo "Order 48213 arrived with a cracked screen. I want my money back, not a replacement." > ticket.txtollama run nimble --ask "Is a refund being requested?" < ticket.txt输出:
yes 100%多分类:
ollama run nimble --ask "Which team should handle this?" \
  --choice billing="Payments and refunds" \
  --choice technical="Software problems" \
  --choice shipping="Damaged or lost deliveries" < ticket.txt
shipping 68%实际队列可把置信度高于约 90% 的结果自动路由,其余交给人工。REST 示例:
curl -s http://localhost:11434/v1/systemone -d '{
  "model": "nimble",
  "state": "Our checkout has returned 500 errors since 9am.",
  "questions": {
    "label": {
      "type": "choice",
      "instructions": "Which label fits this ticket?",
      "criteria": {
        "billing": "Payments and refunds",
        "bug": "Software errors",
        "account": "Login and account access"
      }
    }
  }
}'
响应直接给出各标签概率,不生成输出 token。RTX 5060 Ti 在模型已加载时约 0.09 秒返回;纯 CPU 的 d3:2b 每次约 2.1 到 2.3 秒。
{"model":"nimble","answers":{"label":{"type":"choice","choice":"bug","probabilities":{"billing":0.01588957214904755,"bug":0.9717168615755916,"account":0.012393566275360835},"confidence":0.9575752923633873}},"usage":{"input_tokens":198,"output_tokens":0}}五组基准提示词
- 推理: 球棒和球总价 $1.10,球棒比球贵 $1.00,球多少钱?要求展示步骤。正确答案 $0.05。
- 代码: 写
merge_intervals(intervals),合并重叠区间,包含类型提示、docstring 和三个测试,其中包括空输入和端点重叠。 - 多语言: 将斯瓦希里语 “Haraka haraka haina baraka, lakini polepole ndiyo mwendo.” 翻译成英文并解释文化背景。
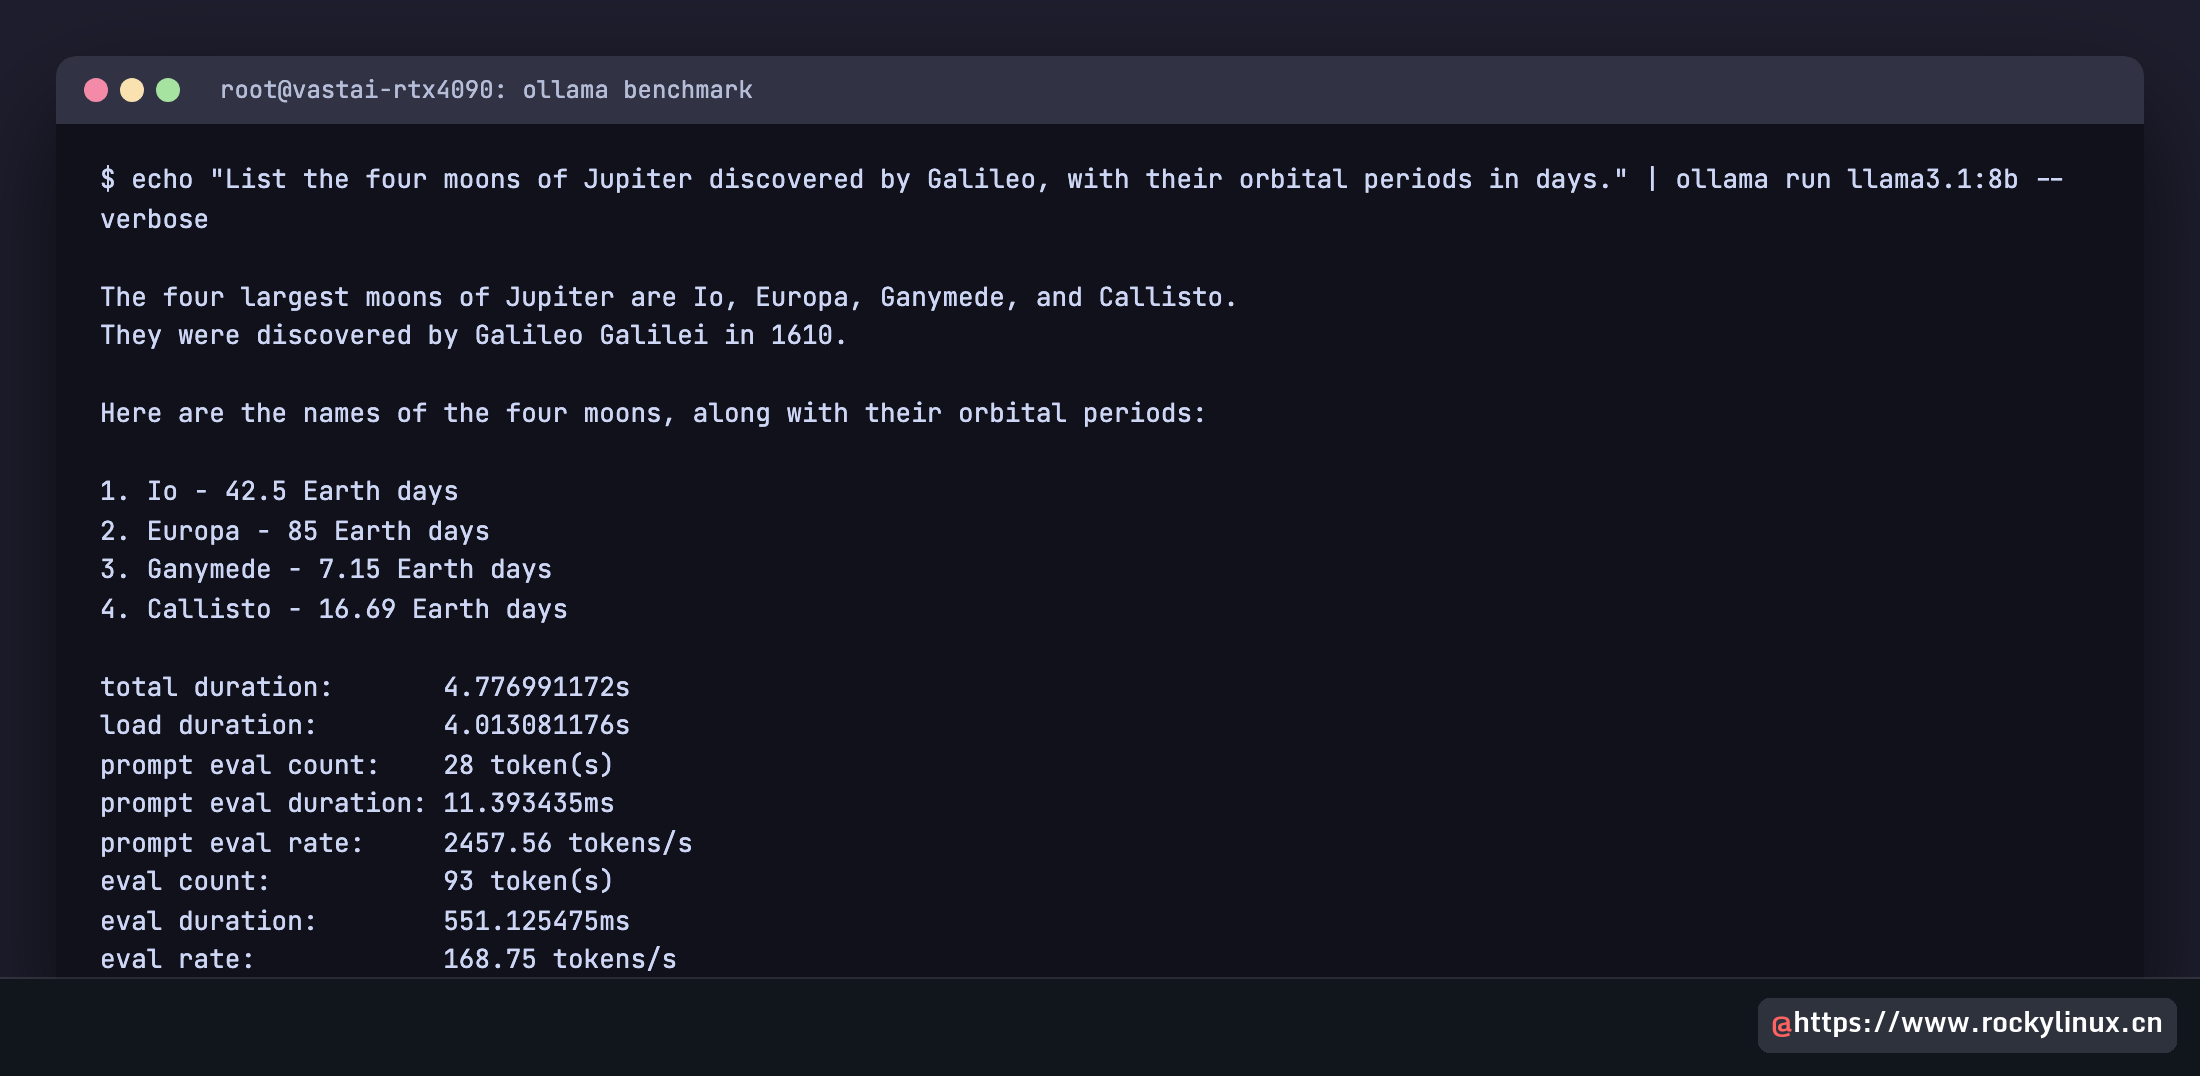
- 事实与不确定性: 按距木星远近列出伽利略发现的四颗卫星及轨道周期;不确定时应明确说明。答案:Io 1.77、Europa 3.55、Ganymede 7.15、Callisto 16.69 天。
- 创作约束: 写一首关于数据中心濒死服务器的六行诗,每行恰好七个词,末行与首行押韵。
可使用 ollama run --verbose 查看 eval rate。建议在自己的 GPU 上至少跑一次,因为宿主 CPU 和驱动对结果影响很大。
实测性能
测试统一使用固定 256 输出 token、temperature 0、seed 42,取五组提示词的平均生成速度。
RTX 4090
| 模型 | 磁盘 | 类型 | 32K tok/s | 64K tok/s |
|---|---|---|---|---|
gemma4:26b |
18 GB | MoE 约 4B 激活 | 311.7 | 310.2 |
ornith-1.5:35b |
22 GB | MoE 3B 激活 | 215.2 | 215.5 |
gpt-oss:20b |
13 GB | MoE 约 3B 激活 | 194.6 | 194.6 |
bonsai-2 |
3.2 GB | 9B ternary | 189.0 | 189.5 |
ornith-1.5:9b |
6.6 GB | dense 9B | 141.1 | 141.0 |
qwen3.5:9b |
6.6 GB | dense 多模态 | 127.9 | 128.1 |
qwen3.8:27b |
17 GB | dense 27B | 120.3 | 120.1 |
nemotron-3.5-bolt |
25 GB | 74B MoE,9B 激活 | 114.4 | 158.4 |
bonsai-2:27b |
8.3 GB | 27B ternary | 84.2 | 84.2 |
devstral-small-2 |
15 GB | dense 24B | 60.8 | 未测 |
除 Bolt 外,64K 上下文下这些模型都报告 100% GPU 且速度基本不变。Bolt 在 24 GB 卡上会自动分层,部分专家留在系统内存,使用草稿模型投机解码,速度在约 100 到 160 token/s 波动。
RTX 5060 Ti 16 GB
| 模型 | 4K tok/s | 4K 占用 | 64K tok/s | 64K 占用 |
|---|---|---|---|---|
bonsai-2 |
117.1 | 2.8 GB | 117.9 | 5.1 GB |
gpt-oss:20b |
94.5 | 12.7 GB | 94.8 | 12.8 GB |
llama3.1:8b |
83.2 | 5.3 GB | 82.9 | 13.4 GB |
ornith-1.5:9b |
71.6 | 5.6 GB | 71.7 | 7.7 GB |
qwen3.5:9b |
67.7 | 5.6 GB | 67.7 | 7.7 GB |
gemma4:12b-it-qat |
53.0 | 7.7 GB | 52.8 | 8.1 GB |
bonsai-2:27b |
44.2 | 8.1 GB | 44.2 | 12.2 GB |
devstral-small-2 |
22.5 | 15.0 GB | 5.5 | 19.6 GB |
qwen3.8:27b |
15.2 | 18.3 GB | 10.1 | 20.7 GB |
llama3.1:8b 的 KV 缓存随上下文从 5.3 GB 增至 13.4 GB;gpt-oss:20b 因滑动窗口注意力几乎不增长。devstral-small-2 和 qwen3.8:27b 在 16 GB 卡上会溢出,64K 时速度明显下降。
Apple M4 16 GB
| 模型 | Runner | tok/s | RTX 4090 对照 |
|---|---|---|---|
gemma4:e4b-it-qat |
llama.cpp/Metal | 29.8 | 未测 |
bonsai-2 |
llama.cpp/Metal | 26.8 | 189.0 |
qwen3.5:9b |
MLX | 24.2 | 127.9 |
ornith-1.5:9b |
llama.cpp/Metal | 15.3 | 141.1 |
25 token/s 已经足够舒适聊天,但执行编码代理任务时会比 RTX 4090 慢 5 到 9 倍。
9 月完整测试中,llama3.2:1b 达到 482.7 token/s,lpm2.5 401.7,gemma4:26b 294.4,qwen3-coder:30b 224.7,gpt-oss:20b 192.0,llama3.1:8b 164.7,qwen3.8:27b 119.1,deepseek-r1:32b 43.9。qwen3.6:27b 从 7 月的 48 token/s 提升到 115,是因为启用了 draft_num_predict=3 的投机解码。把该参数设置为 0 后,速度从 122.6 回落到 48.9 token/s;gemma4:26b 则从 289.6 降到 155.9。
自定义 Modelfile
ollama show --modelfile llama3.1:8b编码助手:
FROM qwen2.5-coder:7b

PARAMETER temperature 0.1
PARAMETER top_p 0.9
PARAMETER repeat_penalty 1.0
PARAMETER num_ctx 16384

SYSTEM """You are a senior software engineer. Always respond with code first, comments second.
Use type hints in Python, JSDoc in JavaScript, and prefer the standard library where possible.
When asked to fix a bug, output a unified diff."""
ollama create coder-strict -f Modelfile.coder
ollama run coder-strict "fix the off-by-one in this for loop: for i in range(len(arr)+1): print(arr[i])"RAG 检索器:
FROM llama3.1:8b

PARAMETER temperature 0.0
PARAMETER top_p 1.0
PARAMETER repeat_penalty 1.0
PARAMETER num_ctx 8192
PARAMETER stop "<end>"

SYSTEM """You answer ONLY using the context provided.
If the context does not contain the answer, reply: "Not in the provided context."
Cite the source paragraph index in square brackets after each claim."""
JSON 路由:
FROM mistral-small:24b

PARAMETER temperature 0.0
PARAMETER num_ctx 8192

SYSTEM """You are a function-call router. Always respond with a single JSON object and nothing else.
Schema: {"tool": string, "args": object}.
Available tools: search_docs, run_sql, send_email, file_read."""
可复现评测:
FROM llama3.1:8b

PARAMETER seed 42
PARAMETER temperature 0.0
PARAMETER top_p 1.0
PARAMETER top_k 1
PARAMETER repeat_penalty 1.0

SYSTEM "Answer concisely. No preamble."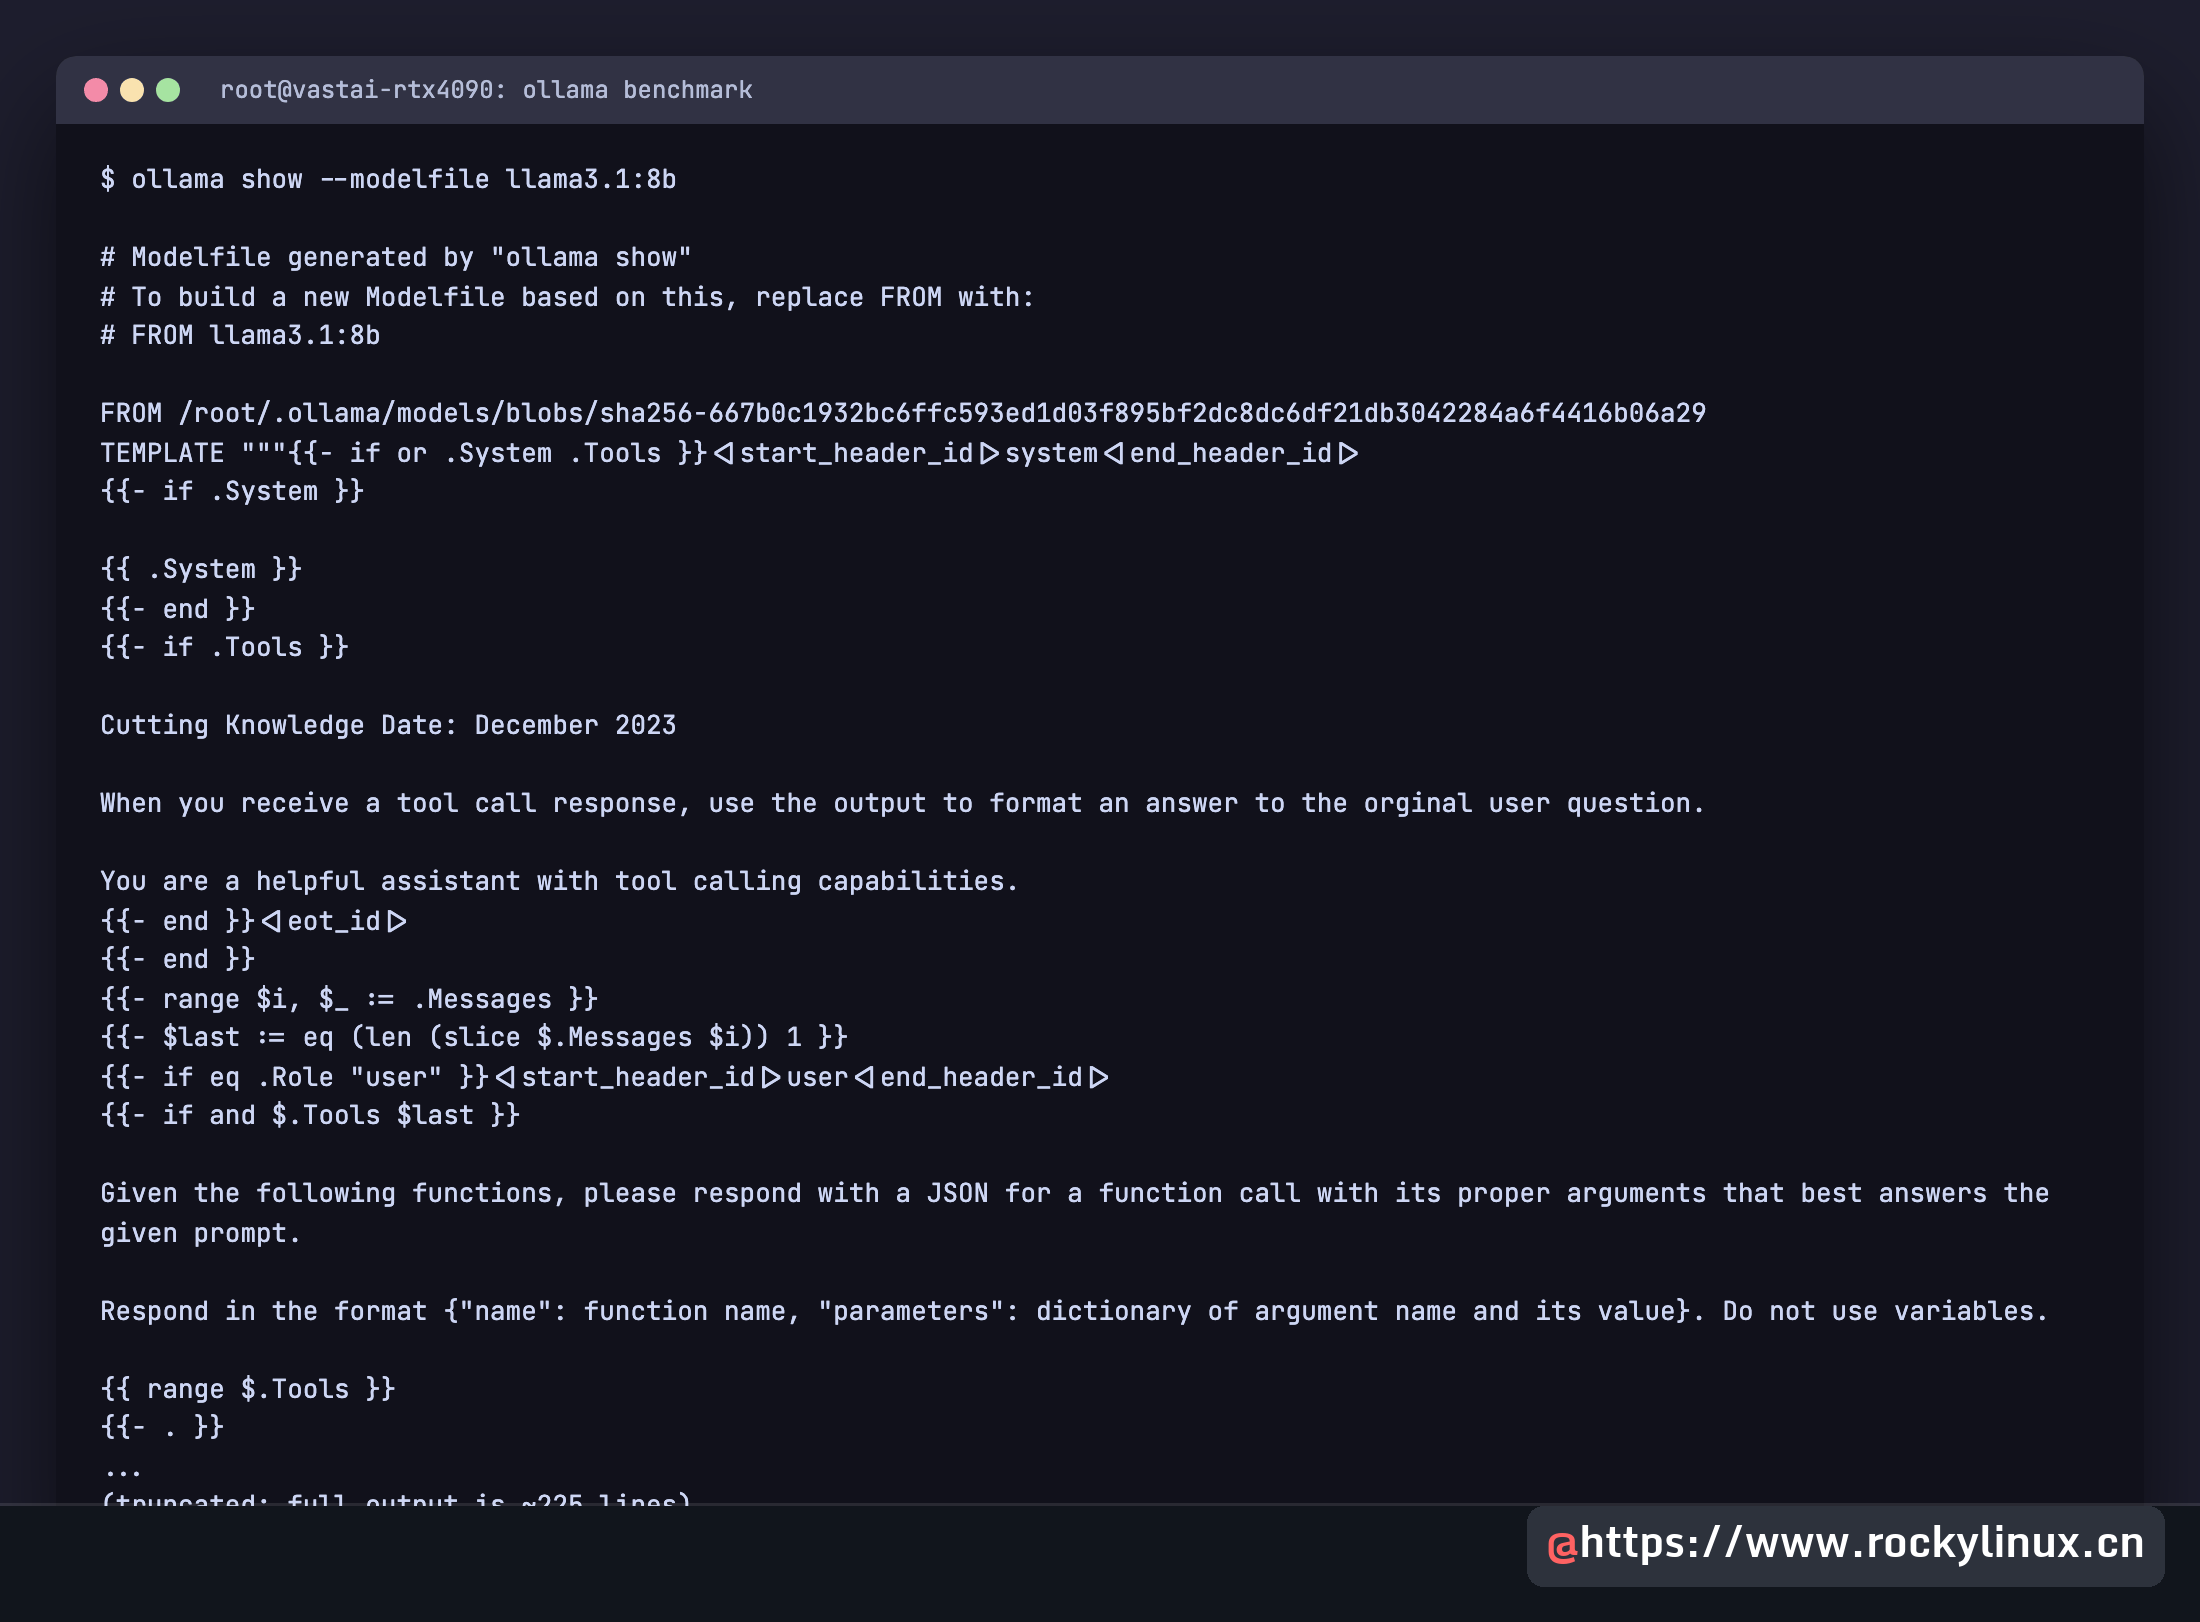
关键参数
| 参数 | 默认值 | 作用 | 调整方式 |
|---|---|---|---|
num_ctx |
按显存 4K/32K/256K | 上下文 token 数 | 显存紧张时降低 |
temperature |
0.8 | 随机性 | 代码和事实用 0.0–0.2 |
top_p |
0.9 | 核采样 | 通常保持 0.9 |
top_k |
40 | Top-k 采样 | 1 强制贪心 |
repeat_penalty |
1.0 | 重复惩罚 | 老模型循环时可到 1.1–1.2 |
draft_num_predict |
模型决定 | 投机解码草稿数 | 设 0 可关闭 |
seed |
随机 | 固定采样 | 复现实验时设置 |
num_predict |
-1 | 最大输出 | 控制延迟和成本 |
num_gpu |
自动 | GPU 卸载层数 | 0 强制 CPU,-1 全部 GPU |
num_thread |
自动 | CPU 线程 | 设为物理核心数 |
keep_alive |
5m | 模型驻留时间 | -1 永久,0 立即卸载 |
思考模型默认会消耗大量 token。例如在 M4 上,qwen3.5:4b 开启思考回答球棒问题用了 1,457 token、62 秒;关闭后为 426 token、17 秒,两者都得出 $0.05。检查可用级别:
ollama show qwen3.5:4b关闭或降低思考:
ollama run qwen3.8:27b --think=false
ollama run qwen3.8:27b --think=low
ollama run qwen3.8:27b --hidethinking
API 请求可传 "think": false 或 "think": "low"。工具路由、抽取和短答通常不需要推理;复杂重构和数学问题才值得开启。
常见选型错误
- 默认上下文不是固定 2048。 当前按显存档位选择 4K、32K 或 256K,大显存机器会因此占用更多 KV 缓存。显存紧张时应主动限制。
:latest会漂移。 固定到明确尺寸和量化,确保可复现。- “R1 8B 不是完整 R1”。 1.5B 到 70B 是蒸馏版,只有
deepseek-r1:671b是完整模型。 - 长上下文 OOM 主要影响 30B 以上稠密模型。 8B 在 32K 下约 10 GB;32B Q4 光权重就约 20 GB。可量化 KV 或缩小上下文。
ollama ps可能低估 MoE 溢出。 Bolt 在 24 GB 卡上显示 3.0 GB、97% GPU,但服务日志显示 17,561 MiB 模型缓冲,约 3.4 GB 专家张量在系统内存。应同时看nvidia-smi、free -m和服务日志。- 应测试宿主而不只是显卡。 繁忙共享服务器可能让相同显卡速度减半。
- 每次请求
keep_alive=0会反复从磁盘加载。 服务端应使用OLLAMA_KEEP_ALIVE=24h或 API 传keep_alive: -1。 - 默认一个模型一次只处理一个请求。 多用户场景应调高
OLLAMA_NUM_PARALLEL,同时按并发数预留内存。 - 视觉模型需通过 API 或文件路径传图。 不能直接把图片粘贴到通用聊天输入。
常见问题
最适合编码的模型?
24 GB 卡优先 qwen3-coder:30b;更小显存选 qwen2.5-coder:14b/7b;16 GB 卡可继续使用 gpt-oss:20b。
Llama 3.3 70B 需要多少内存?
文件约 43 GB。Q4_K_M 应准备至少 48 GB 显存或统一内存,并给上下文留余量;64K 上下文通常需要更多。
Apple Silicon 可以运行 Ollama 吗?
可以。统一内存会作为显存使用,并优先选择 MLX 构建。16 GB 机器应给 macOS 留约 4 GB。
Mistral、Llama、Qwen 哪个最好?
没有统一答案。Qwen 多语言和编码覆盖强,Llama 生态成熟,Mistral 的工具调用和 JSON 输出好。按显存、许可证、视觉和语言需求选。
最小但真正有用的模型?
1B 到 3B 可做快速分类、工具路由和简单摘要。低于 1B 的模型可用于极简任务,但复杂任务质量下降明显。
如何更新模型?
重新执行 ollama pull <model>。它只下载变化层;用 ollama list 确认修改时间。ollama --version 查看自身版本。
为什么 CPU 上很慢?
CPU 推理受内存带宽限制。7B Q4 每 token 约读取 4.5 GB,吞吐约等于带宽除以模型大小。双通道 DDR5-5200 约 80 GB/s,可达到约 15 token/s;8 通道服务器内存可到约 80 token/s。增加核心数通常无济于事。
能同时运行两个模型吗?
可以。OLLAMA_MAX_LOADED_MODELS 默认每 GPU 最多 3 个模型,内存不足时会卸载闲置模型。相同模型请求排队时调高 OLLAMA_NUM_PARALLEL。
应该使用自定义 GGUF 还是默认标签?
一般使用默认标签。Ollama 默认是经过整理的 GGUF 与合理量化;需要特定量化、微调或合并时再从 Hugging Face 导入:
ollama create <name> -f ModelfileOllama Cloud
Ollama Cloud 使用相同 CLI 和 API 运行本地显存放不下的模型。纯云模型使用 :cloud,例如 kimi-k3:cloud;既有本地权重的系列使用 gpt-oss:120b-cloud。
ollama signin
ollama run gpt-oss:120b-cloud
套餐分别提供不同并发数和月度额度;费用按每百万 token 计算。可在云端用大模型做原型,再把标签换成适合本机显存的本地模型,无需修改应用代码。Ollama Cloud 也可接在 Open WebUI 后面供团队统一使用。
| 云模型 | 输入 $/M | 缓存输入 $/M | 输出 $/M |
|---|---|---|---|
nemotron-3-super |
0.015 | 0.015 | 0.60 |
gpt-oss:20b |
0.07 | 0.035 | 0.30 |
gemma4 |
0.14 | 0.05 | 0.40 |
gpt-oss:120b |
0.15 | 0.014 | 0.60 |
glm-5.3-flash |
0.15 | 0.03 | 0.50 |
deepseek-v4.1-flash |
0.30 | 0.006 | 1.20 |
deepseek-v4-pro |
1.32 | 0.044 | 3.96 |
glm-5.3 |
1.40 | 0.26 | 4.40 |
kimi-k3 |
3.00 | 0.30 | 15.00 |
DeepSeek 两个模型在工作日 UTC 12:00–18:00 之外及周末按半价计费。