PostgreSQL 14 将于 2026 年 11 月 12 日停止接收修复,14.24 是它的最后一个版本。把 PostgreSQL 14 升级到 18 听起来像要花一个周末做转储与恢复,但 pg_upgrade 会原地重写系统目录并保留所有表文件,因此本次 3.6 GB 的测试集群在转储模式下用时 430 秒,在链接模式下仅用时 18 秒。较慢的方式仍然值得了解,但生产环境通常会使用较快的方式。
本文覆盖两条升级路径:在 Ubuntu 和 Debian 上使用 pg_upgradecluster,由包装脚本选择已安装的最新版本并代为运行 pg_upgrade;在 Rocky Linux 和 RHEL 上则手动驱动 pg_upgrade。文章还会说明扩展更新脚本和统计信息重建步骤。所有命令均于 2026 年 11 月在 Ubuntu 24.04、Debian 13 和 Rocky Linux 9 上,对一个包含 1500 万行数据及三个扩展的集群实际执行,因此文中的耗时和报错均来自实测。
PostgreSQL 14 到 18 有哪些变化
pg_upgrade 可以在一次操作中跨越多个主版本,因此 14 集群可以直接升级到 18,不必先停在 15、16 和 17。这种单步升级是 pg_upgrade 的既定行为,并且在实验环境中的三种发行版上都成立。工具不会做的是:更新扩展、迁移已经移除的服务器设置,或者修复调用了改名函数的应用代码。真正的主版本升级工作往往集中在这些缺口上。
选择目标版本时,截止日期很重要。PostgreSQL 18 是当前稳定版,也是本文的目标版本:
| 版本 | 当前发布版 | 停止支持 |
|---|---|---|
| PostgreSQL 14 | 14.24 | 2026 年 11 月 12 日 |
| PostgreSQL 17 | 17.11 | 2029 年 11 月 8 日 |
| PostgreSQL 18 | 18.6 | 2030 年 11 月 14 日 |
截至 2026 年 11 月,PostgreSQL 19 仍处于候选发布阶段,因此本文以 18 为目标;如果工具链落后于最新主版本,17 仍是保守选择。如果你最终准备升级到 19,Ubuntu、Debian、Rocky 和 AlmaLinux 的 PostgreSQL 19 安装指南会单独跟踪该版本。
14 到 18 之间的若干变化可能在升级后破坏应用代码或脚本,而 pg_upgrade 不会修复这些问题。它们影响的是应用代码,不是升级过程本身:
- 新建数据库不再默认向
PUBLIC授予publicschema 的CREATE权限(15) pg_start_backup和pg_stop_backup已改名为pg_backup_start和pg_backup_stop(15)plpython2u已移除(15)lc_collate和lc_ctype服务器变量已移除(16)old_snapshot_threshold和adminpack扩展已移除(17)
实际最容易出问题的是备份函数改名。调用 pg_start_backup 的监控脚本和旧包装脚本会在 18 上遇到函数不存在的错误,而且错误通常要等到升级后的第一次备份才出现,并非在 pg_upgrade 运行期间出现。动手前先在代码和 cron 任务中搜索旧名称,因为直到首个备份窗口才发现问题,代价会高得多。
动手前先备份
pg_upgrade 会原地迁移数据,因此唯一可靠的撤销手段就是运行前创建的备份。主版本升级前最好准备两种备份:
- 所有数据库的逻辑
pg_dumpall,它也能证明 14 仍可读取自己的数据 - 数据目录的文件系统副本,在需要逐字节恢复旧集群时,可在数分钟内还原
逻辑转储成本较低,而且可以在 14 继续提供流量时执行。测试集群中该操作耗时 31 秒,生成了 1.4 GB 文件:
sudo -u postgres sh -c 'pg_dumpall > /var/lib/postgresql/pg14-all.sql'请把校验和与文件一起保存,并在真正依赖该转储前重新比对:
md5sum /var/lib/postgresql/pg14-all.sql测试集群的校验和输出为:
1d7283d46c989a3b4dbdee45fda146f7 /var/lib/postgresql/pg14-all.sql文件系统副本覆盖另一种故障场景:需要逐字节恢复旧集群。先停止集群,打包数据目录和配置树,然后重新启动 14 并执行升级。同一测试集群的 tar 操作耗时 413 秒,生成了 1,738,519,695 字节的归档,恢复时只需将归档解包回原位:
sudo tar -C / -czf /var/lib/postgresql/pg14-cluster.tgz var/lib/postgresql/14/main etc/postgresql/14该归档同时包含数据目录和 /etc 下的配置树,因此恢复后可以重建整个集群。如果磁盘空间足够,两种备份都做;如果只能保留一种,优先保留 tar,因为它可以逐字节恢复尚未完全升级的 14。条件允许时仍应同时保留逻辑转储,因为后者可以载入任意版本,也是本文所有升级路径最终都使用过的恢复材料。
在 Ubuntu 和 Debian 上升级集群
Ubuntu 24.04 自带仓库最高只提供 PostgreSQL 16,因此 18 来自 PGDG 仓库。配置脚本只需两条命令,并会自动使用当前发行版代号:
sudo apt install postgresql-common
sudo /usr/share/postgresql-common/pgdg/apt.postgresql.org.sh
脚本会显示将要使用的代号,并写入仓库文件:
This script will enable the PostgreSQL APT repository on apt.postgresql.org on
your system. The distribution codename used will be noble-pgdg.
...
Writing /etc/apt/sources.list.d/pgdg.sources ...
You can now start installing packages from apt.postgresql.org.接下来安装服务器,并为每个正在使用的扩展安装与目标版本匹配的软件包。pg_upgradecluster 会执行包预检查,只要缺少一个匹配包就会拒绝开始:
sudo apt install postgresql-18例如,如果使用 pgvector,就需要在现有 postgresql-14-pgvector 旁边安装 postgresql-18-pgvector,其他 PGDG 扩展同理。PostGIS、pgrouting 以及 PGDG 列表中的其余扩展都遵循同一规则。预检查会读取已安装扩展列表,因此能发现任意扩展缺失,并不只限于 pgvector。缺少软件包时的报错原文见后文故障排查部分。
升级前先确认当前状态:正在运行的集群、版本和校验和设置,因为校验和设置会决定后续行为:
pg_lsclusters
psql --version
sudo /usr/lib/postgresql/14/bin/pg_controldata /var/lib/postgresql/14/main | grep -i checksum
下面是测试虚拟机在尚未修改任何内容时的源集群。最后一行会影响后续多个步骤,应立刻记录下来。
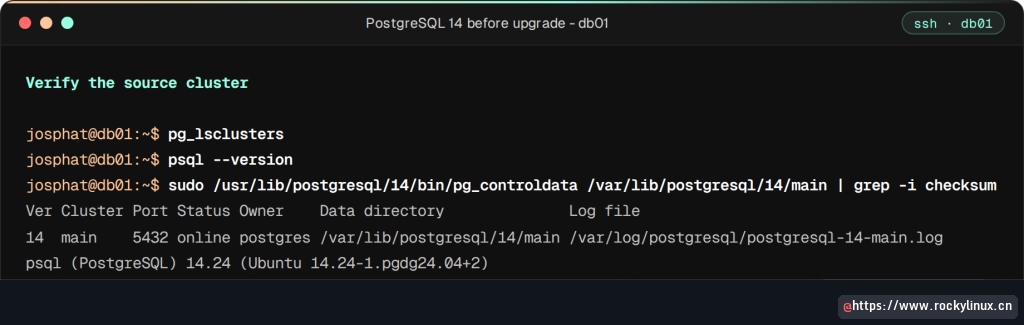
需要记住的是校验和那一行。该集群显示 Data page checksum version: 0,表示未开启校验和;它与 PostgreSQL 18 新默认值的不一致,正是 RHEL 系手动升级中最常见的失败原因。开始前先记录该值。版本号也值得注意:14.24 是 14 系列的最后一个版本。
现在执行升级。只传入旧版本和集群名称,包装脚本会自动检测已安装的最新版本:
sudo pg_upgradecluster 14 main测试虚拟机上的完整转储模式输出如下。内容较长,但各阶段能解释耗时原因,建议从上到下通读一次:
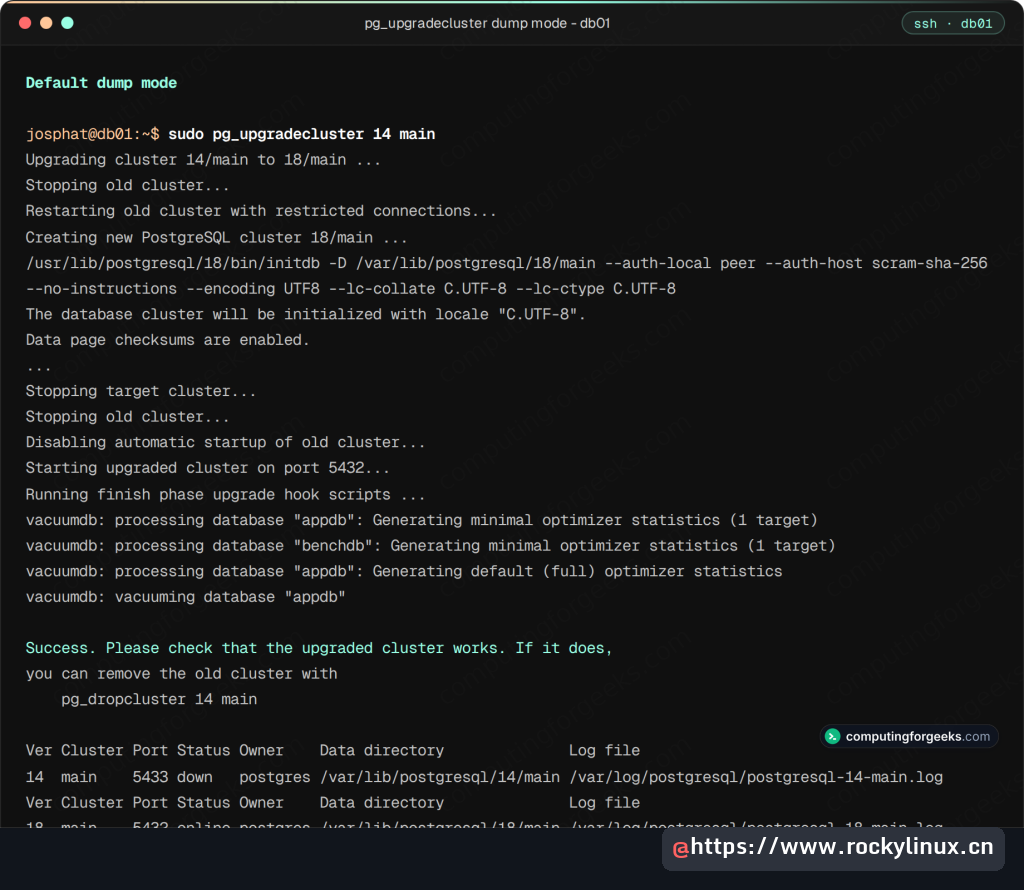
转储模式是默认方式,输出也说明了它为何较慢:包装脚本把 14 中每个数据库转储出来,再载入 18,本次耗时 430 秒。耗时随数据量增长,不取决于跨了几个主版本。脚本最后还会执行统计信息处理,因此集群启动后已有可用的查询规划统计信息。完成后,14 会停止并监听 5433,18 则接管 5432。
删除任何内容之前,先确认数据确实已经迁移:
sudo -u postgres psql -d appdb -tAc 'SELECT count(*) FROM events'
sudo -u postgres psql -d appdb -c '\dx' | grep -E 'pg_trgm|pgcrypto|vector'
systemctl status postgresql@18-main --no-pager | head -5
测试虚拟机上的所有检查均通过。行数应与自己的数据核对:
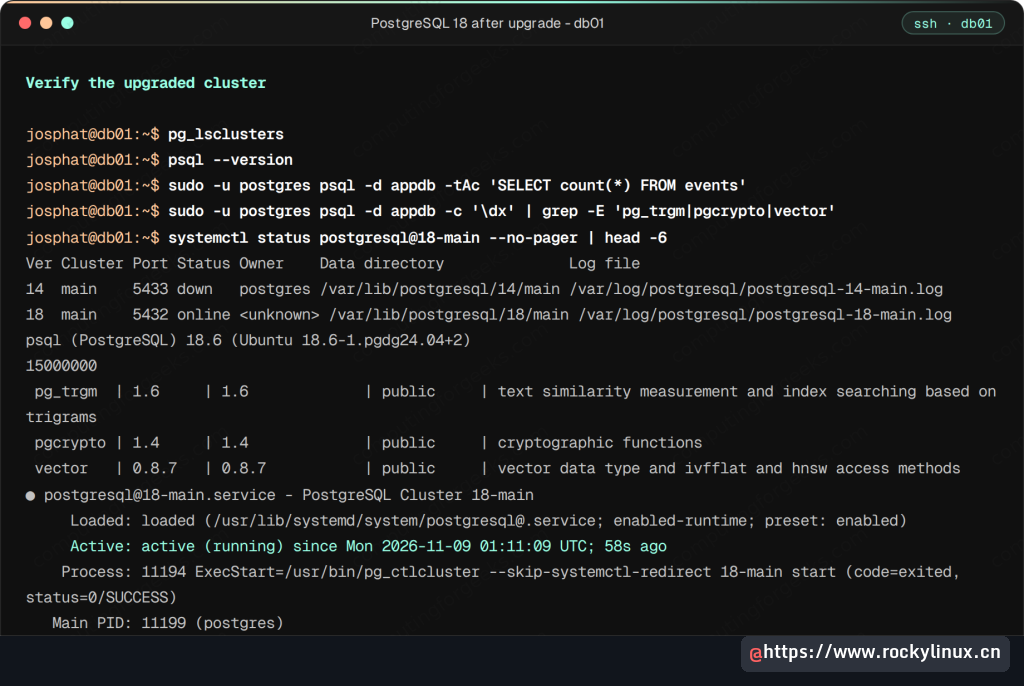
行数与种子数据一致,所有扩展都出现在 18 上,psql 已报告 18.6。只要有一项不满足,就应在继续前重新检查升级。此时可以让应用连接新集群运行,同时保留已停止的 14 监听 5433 且不做修改。直到最后一节再删除 14。
注意参数,这里有一个真实陷阱。第三个位置参数是数据目录,并非新版本号。输入 pg_upgradecluster 14 main 18 main 会让包装脚本把整个转储模式升级结果写入当前目录下一个字面名为 18 的数据目录。测试期间实际复现过该运行方式,它仍会成功完成,所以尤其危险。升级后的 18 集群会在 5432 启动,但其数据位于相对路径;之后删除遗留集群时,清理程序会警告数据目录不存在。始终只传两个参数:版本号和集群名称。Debian 13 的行为与 Ubuntu 相同,那里较小的种子集群在转储模式下耗时 29 秒。如果最终目标是 17 而不是 18,PostgreSQL 17 安装指南中的 pg_upgradecluster 步骤结构相同,只需更换版本号。
切换到链接模式
转储模式安全但较慢,因为它通过新目录复制每一行。链接模式则把旧表文件硬链接到新集群,数据本身完全不需要复制:
sudo pg_upgradecluster --method=link 14 main测试虚拟机的链接模式输出如下,耗时显示在截图底部。
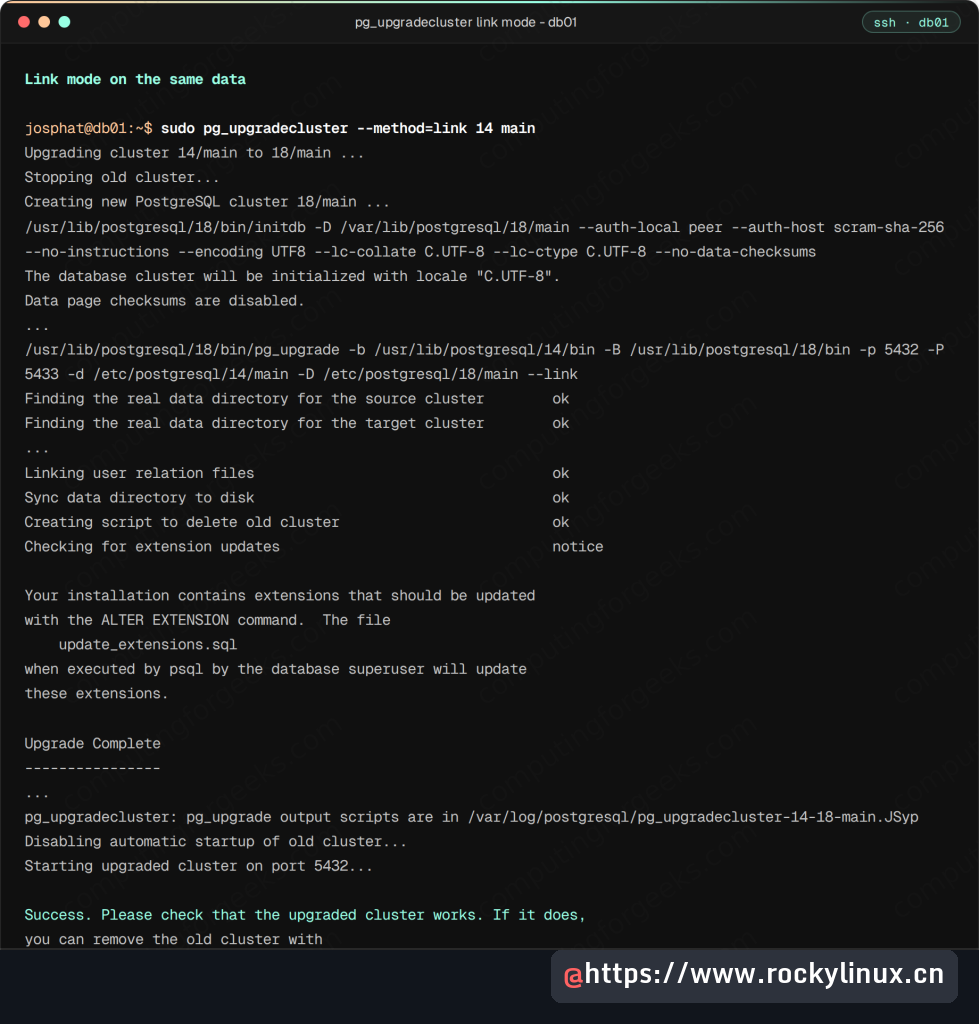
请查看输出中的 initdb 行:包装脚本自动传入 --no-data-checksums,因为 pg_upgrade 要求两个集群的校验和设置一致,而 14 集群通常未开启校验和。这正是 RHEL 系手动升级容易遇到的问题,包装脚本会自动处理。该次运行还会提示 update_extensions.sql,扩展更新一节会详细说明。
同一 3.6 GB 集群的成本差异并不细微:
| 模式 | 升级耗时 | 升级后磁盘占用(18 + 14) |
|---|---|---|
| 转储模式 | 430 秒 | 3.6 GB + 3.6 GB |
| 链接模式 | 18 秒 | 2.6 GB + 1.1 GB |
链接模式会改变回滚方案,选择前必须理解这一点。两个集群共享文件内容,因此一旦 18 启动,14 就不能再安全启动;pg_upgrade 会把旧 pg_control 改名移走,输出中也会明确说明。从此以后,回滚只能依靠上一节的备份,不能依靠旧集群。转储模式则会完整保留并停止 14(端口 5433),在你删除它之前,可用 pg_ctlcluster 14 main start 重新启动。
链接模式会在 /var/log/postgresql/pg_upgradecluster-14-18-main.*/ 中留下辅助脚本,其中实际会用到的就是扩展更新脚本。转储模式不需要这些脚本,因为恢复过程会顺带更新扩展。该目录归 postgres 所有,权限为 700,稍后读取时会受此影响。
在 Rocky Linux 和 RHEL 上升级
RHEL 系系统没有 pg_upgradecluster 包装脚本,需要直接驱动 pg_upgrade,并自行做出包装脚本原本会代为完成的决策。以下步骤在启用 SELinux 强制模式的 Rocky Linux 9 上完成,同样适用于 RHEL 和 AlmaLinux;三者之间只有软件包名称可能不同。Fedora 用户有独立的流程:Fedora 安装指南介绍的 postgresql-setup --upgrade 会以 Fedora 打包方式封装同一个 pg_upgrade。
先安装 PGDG 仓库,并禁用 AppStream 的 postgresql 模块,避免它遮蔽 PGDG 软件包:
sudo dnf install https://download.postgresql.org/pub/repos/yum/reporpms/EL-$(rpm -E %rhel)-x86_64/pgdg-redhat-repo-latest.noarch.rpm
sudo dnf -qy module disable postgresql
然后安装 18 服务器、contrib,以及正在使用的每个扩展对应版本。这里扩展使用版本后缀包名,因此 pgvector 会以 pgvector_18 的形式与现有 pgvector_14 并存:
sudo dnf install postgresql18-server postgresql18-contrib先用默认方式初始化新集群,即使稍后的检查会失败。这样做是为了亲眼看到校验和默认值:PostgreSQL 18 在 initdb 时默认开启数据校验和,而 14 集群几乎一定未开启。检查需要 postgres 可写的当前目录,因此下面先切换到 /tmp:
sudo -u postgres /usr/pgsql-18/bin/initdb -D /var/lib/pgsql/18/data
sudo systemctl stop postgresql-14
cd /tmp
sudo -u postgres /usr/pgsql-18/bin/pg_upgrade -b /usr/pgsql-14/bin -B /usr/pgsql-18/bin -d /var/lib/pgsql/14/data -D /var/lib/pgsql/18/data --check
测试虚拟机上的失败检查正好停在校验和比较处,其他操作没有发生:
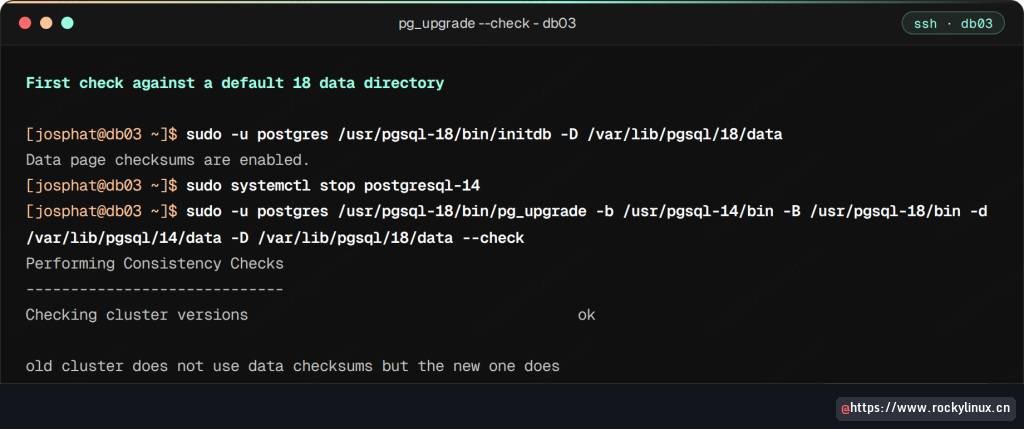
两个集群都没有写入任何内容,检查运行后即退出,数据目录保持原状。解决方式是删除刚初始化的数据目录,再用关闭校验和的方式重新初始化,然后执行同一检查即可通过:
sudo rm -rf /var/lib/pgsql/18/data
sudo -u postgres /usr/pgsql-18/bin/initdb -D /var/lib/pgsql/18/data --no-data-checksums
cd /tmp
sudo -u postgres /usr/pgsql-18/bin/pg_upgrade -b /usr/pgsql-14/bin -B /usr/pgsql-18/bin -d /var/lib/pgsql/14/data -D /var/lib/pgsql/18/data --check
重新初始化后再执行一次,检查会恢复为干净状态。需要看到的是最后一行:
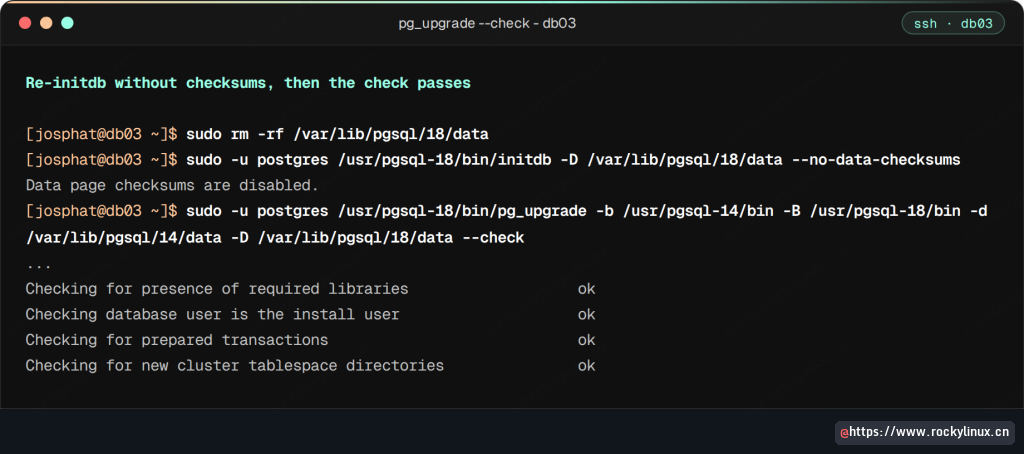
Clusters are compatible 就是继续执行的绿灯。实际运行前还有一个陷阱:pg_upgrade 会把输出脚本写入当前目录,如果从自己的主目录以 postgres 身份运行,就会因 postgres 无法写入而失败。应改在 postgres 拥有的目录中运行:
sudo -u postgres sh -c 'cd /var/lib/pgsql && /usr/pgsql-18/bin/pg_upgrade -b /usr/pgsql-14/bin -B /usr/pgsql-18/bin -d /var/lib/pgsql/14/data -D /var/lib/pgsql/18/data --link'测试虚拟机上的真实运行结果与检查预期完全一致。输出尾部会提示后续步骤:
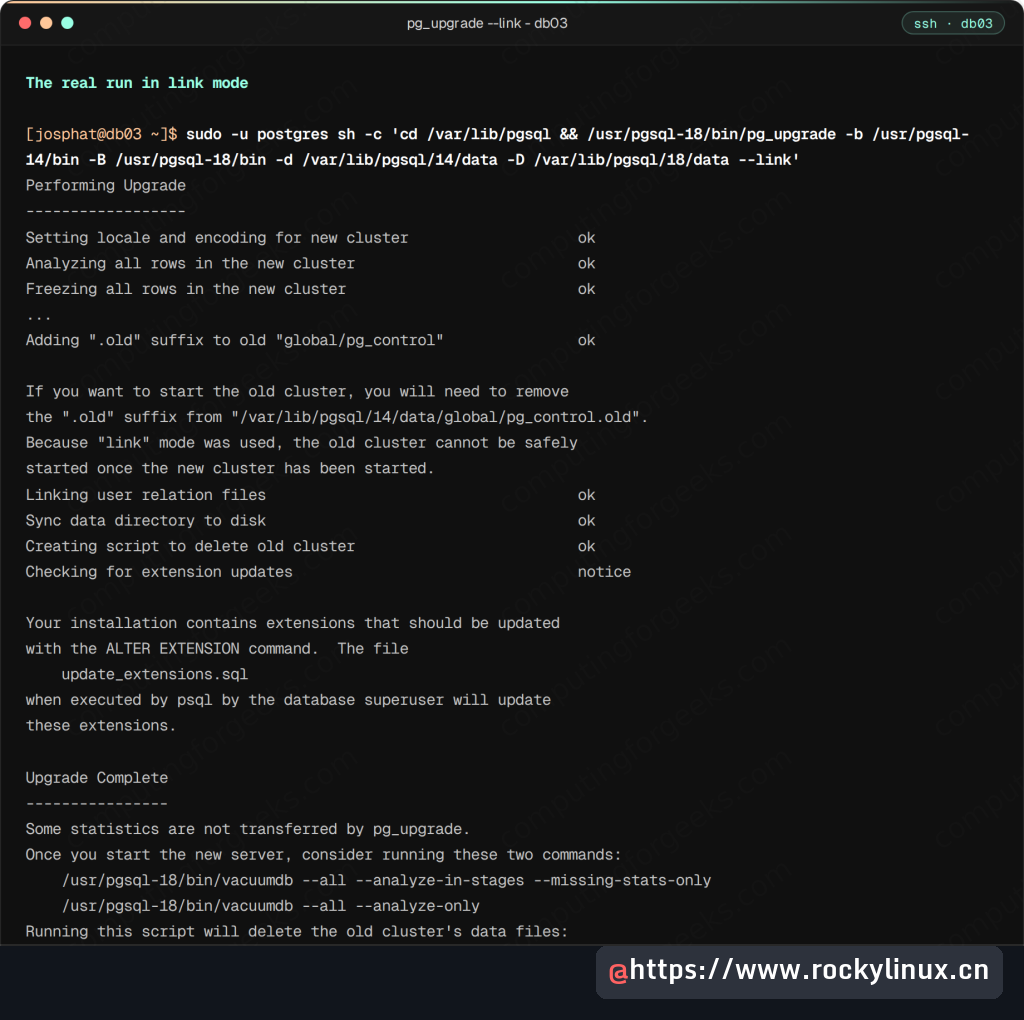
3.6 GB 集群耗时 4 秒。输出列出了之后需要执行的两条 vacuumdb 命令,指向 update_extensions.sql,并在 /var/lib/pgsql 留下 delete_old_cluster.sh,以便完成对 14 的清理。现在启动新集群并设置开机启用:
sudo systemctl enable --now postgresql-18服务已经运行,旁边的磁盘状态如下。两条 du 输出是所有机器上链接模式的典型特征。
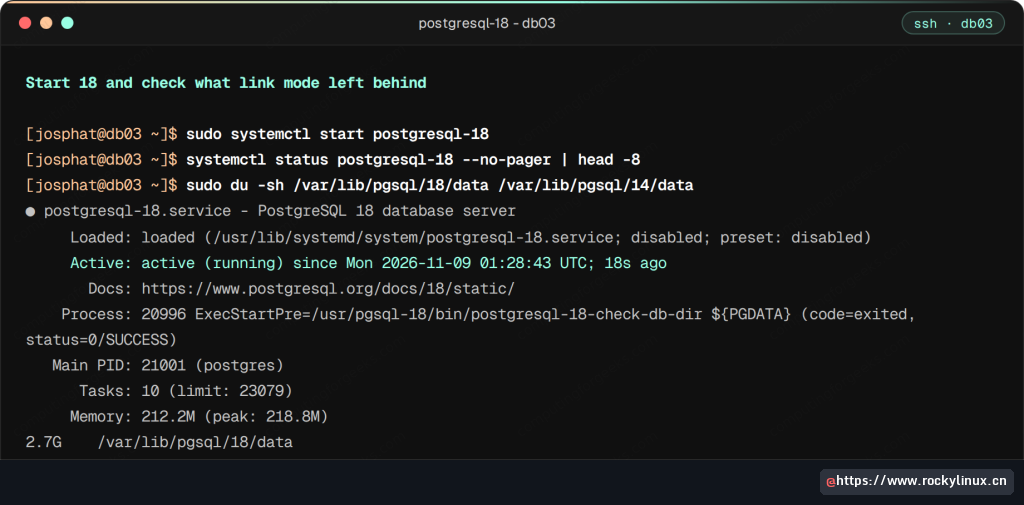
服务成功启动,du 显示了链接模式的遗留状态:18/data 占用 2.7 GB,14/data 下仍列出了 1.1 GB 硬链接文件。SELinux 不需要额外操作;PGDG 单元带有正确的上下文,在启用强制模式的主机上完成整个升级后,ausearch -m avc -ts recent 返回为空。
升级后更新扩展
pg_upgrade 不会更新扩展对象,所有扩展都会保持 14 上的版本。转储模式会在恢复过程中更新扩展,链接模式则会写出 update_extensions.sql 并提示其位置。先找到输出目录并读取脚本:
sudo cat /var/log/postgresql/pg_upgradecluster-14-18-main.*/update_extensions.sql测试集群的脚本包含一个扩展:
\connect appdb
ALTER EXTENSION "pgcrypto" UPDATE;
每个可更新的扩展都会有一行 ALTER EXTENSION,前面带有指向其所在数据库的 \connect。不能直接把文件路径交给 psql,因为输出目录归 postgres 所有、权限为 700,当前 shell 无法进入。应通过管道传入:
sudo cat /var/log/postgresql/pg_upgradecluster-14-18-main.*/update_extensions.sql | sudo -u postgres psql -X -f -在升级后的集群执行该脚本会输出两行:连接提示和 ALTER 结果,二者都符合预期:
You are now connected to database "appdb" as user "postgres".
ALTER EXTENSION
通过目录查询确认扩展版本已经变化:
sudo -u postgres psql -d appdb -tAc "SELECT extname||' '||extversion FROM pg_extension WHERE extname='pgcrypto'"这里应返回 18 版本构建的扩展,测试集群结果为:
pgcrypto 1.4pgcrypto 从 1.3 升级到 1.4,新版本随 postgresql-18 包提供,因为它是 contrib 的一部分。来自 PGDG 的扩展必须先安装对应版本包,这正是 Ubuntu 一节中预检查发挥作用的场景。如果缺少 postgresql-18-pgvector,升级会直接拒绝开始,而不是留下一个无法在 18 加载的 vector 扩展。脚本运行后,\dx 中显示的就是 18 原地记录的版本。
重建查询优化器统计信息
PostgreSQL 18 会自动迁移大多数查询规划统计信息,但有三类不会跨版本保留:
- 使用
CREATE STATISTICS创建的统计信息 - 扩展为其自有对象添加的统计信息
- 查询规划器用于自适应决策的累计计数器
空的统计信息缓存会让第一批查询选择糟糕的执行计划,因此 pg_upgrade 自身也会提示运行两次 vacuumdb。在 RHEL 系系统上,二进制位于 /usr/pgsql-18/bin/vacuumdb,而不是下文的 /usr/lib 路径。第一遍会为完全没有统计信息的关系生成最小统计集,使规划器在几秒内恢复安全状态:
sudo -u postgres /usr/lib/postgresql/18/bin/vacuumdb --all --analyze-in-stages --missing-stats-only测试集群的第一遍覆盖了两个用户数据库和两个系统数据库:
vacuumdb: processing database "appdb": Generating minimal optimizer statistics (1 target)
vacuumdb: processing database "benchdb": Generating minimal optimizer statistics (1 target)
vacuumdb: processing database "postgres": Generating minimal optimizer statistics (1 target)
vacuumdb: processing database "template1": Generating minimal optimizer statistics (1 target)
第二遍按普通 ANALYZE 的方式构建完整统计信息:
sudo -u postgres /usr/lib/postgresql/18/bin/vacuumdb --all --analyze-only下面是在升级后的测试集群上按手动路径执行两遍的完整结果:
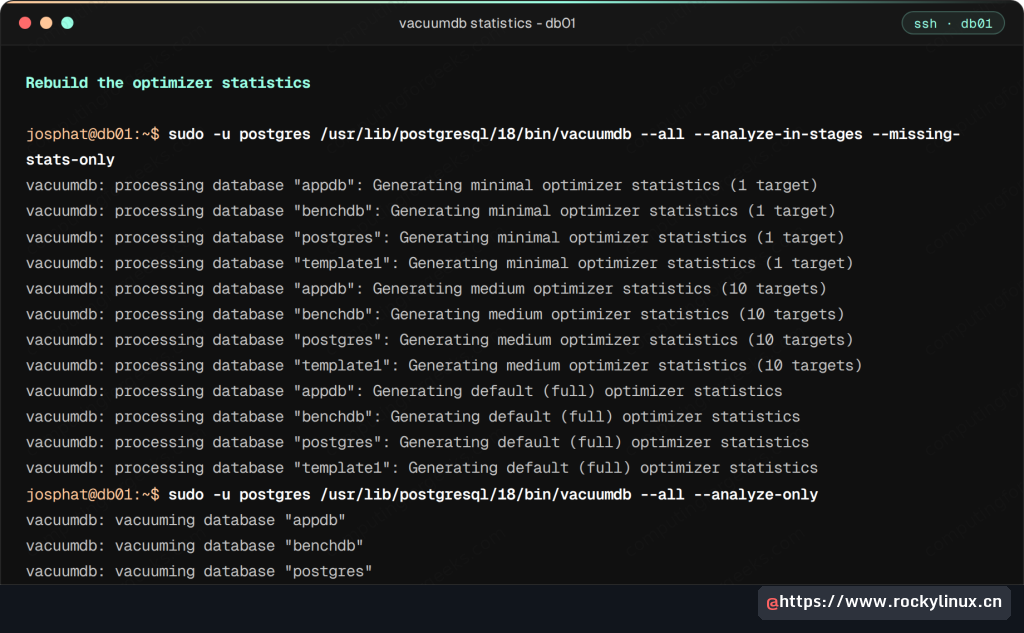
pg_upgradecluster 在转储模式下已经执行了这两遍,因此本节最重要的情况是 RHEL 侧手动运行 pg_upgrade 后,因为工具只会打印建议。之后每次大规模载入数据后都应重新执行普通 ANALYZE,统计信息也会随数据变化而过时。若要深入理解规划器如何使用这些信息,可以参考 PostgreSQL 书籍列表。
删除旧集群
让 14 保留到应用在 18 上正常运行一天,并且新版本完成一次成功备份循环之后,再删除旧集群并回收磁盘空间:
sudo pg_dropcluster 14 main之后 pg_lsclusters 应只列出 18:
Ver Cluster Port Status Owner    Data directory              Log file
18  main    5432 online postgres /var/lib/postgresql/18/main /var/log/postgresql/postgresql-18-main.log
在 Rocky 上,pg_upgrade 留下的删除脚本会完成相同工作:确认要长期使用 18 后,执行 sudo /var/lib/pgsql/delete_old_cluster.sh。两种模式释放的空间不同。链接模式下,旧数据目录中剩余的 1.1 GB 大多是通往新目录的硬链接,因此删除它只会释放 18 重写过的文件;转储模式下重复的 3.6 GB 会全部回收。集群删除后,再用 apt 或 dnf 移除 postgresql-14 相关软件包是安全的,也能避免监控持续告警某个再也不会启动的服务。
单节点数据库的下一步通常是复制,而不是再次跨主版本升级。Rocky 和 AlmaLinux 的 PostgreSQL 流复制指南可从这里继续。18 正常运行、14 已删除后,这套数据库可以支撑到 2030 年。
修复 PostgreSQL 14 到 18 的常见升级错误
测试中遇到的每个失败都在写入任何内容前停止,这正是 pg_upgrade 的优势:先检查,再行动。以下四个是实际最可能遇到的问题,全部属于环境问题,不是数据问题。
旧集群未使用数据校验和,但新集群使用
PostgreSQL 18 在 initdb 时默认启用数据校验和,而 pg_upgrade 拒绝跨越该差异。失败的检查如下:
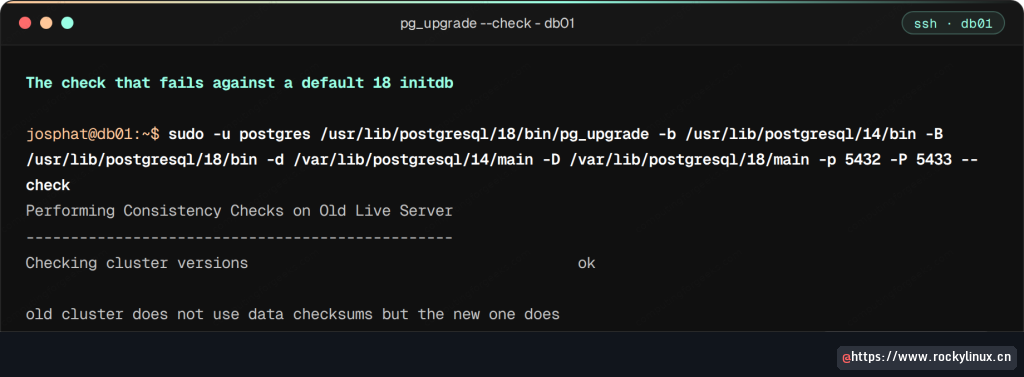
修复方式是像 Rocky 一节那样,使用 --no-data-checksums 初始化新集群。拒绝继续是工具在阻止无法解决的不匹配,并非程序缺陷。pg_upgradecluster 在链接和克隆运行中会自动处理。如果确实希望升级后的集群启用校验和,可在集群停止时用 pg_checksums 后续开启;这会扫描一次所有数据文件,但不会改变升级本身的其他内容。
已安装 postgresql-14-pgvector,但缺少 postgresql-18-pgvector
pg_upgradecluster 会在触碰任何数据前运行软件包预检查;只要已安装扩展没有对应目标版本的包,就会拒绝继续。报错会直接指出修复方法:
postgresql-14-pgvector is installed, but postgresql-18-pgvector is missing
1 package(s) from version 14 missing for version 18
Install the missing packages and try pg_upgradecluster again. To ignore the issue, use --force-packages
安装缺少的软件包后重试。包名始终遵循 postgresql-<版本>-<扩展> 模式。--force-packages 适用于即将删除的扩展;如果扩展仍在使用却强制绕过,新集群将无法加载该扩展,状态会比当前直接拒绝更糟。
You must have read and write access in the current directory
pg_upgrade 会把输出脚本写入工作目录,以 postgres 身份从个人主目录运行时立即失败:
You must have read and write access in the current directory.
Failure, exiting
请从 postgres 拥有的目录启动 pg_upgrade。Rocky 一节使用 sh -c 配合 cd,用一条命令同时切换到正确的用户和目录;任何由 postgres 拥有的目录都可以,不一定是 /var/lib/pgsql。它写出的脚本,包括 delete_old_cluster.sh,也会落在同一目录。
repomd.xml GPG signature verification error: Bad GPG signature
在当前 Rocky 9 上,刚安装的 PGDG 仓库在首次 dnf 事务中无法通过元数据检查,因为仓库带有 repo_gpgcheck=1,而那里的签名路径会失败。关闭元数据检查并重建缓存:
sudo sed -i 's/repo_gpgcheck = 1/repo_gpgcheck = 0/' /etc/yum.repos.d/pgdg-redhat-all.repo
sudo dnf -qy makecache
软件包本身仍由 rpm 做 GPG 验证,因此这里只关闭仓库元数据的一层检查,不影响实际安装内容。缓存重建后,postgresql18-server 可以正常安装,可回到 initdb 步骤继续。事务的其他行为不会变化。
几乎其他所有 pg_upgrade 失败都是第一类问题的变体:工具在搬运一个字节之前会检查集群版本、校验和、扩展包、预置事务和磁盘空间,因此失败的运行通常不会改动正在运行的 14。修正报错指出的问题后重新运行即可。失败的检查只损失几分钟,跳过备份则可能损失整个集群。实验环境中用三种方式升级了同一集群,而逻辑转储是所有路径唯一都会用到的材料。请从第一节起保留该转储,直到 18 完成一次完整备份循环;它是本文覆盖的所有故障模式中唯一普遍有效的撤销手段。