本文搭建一条完全运行在单台 Linux 主机上的检索增强生成(Retrieval-Augmented Generation,RAG)流水线:不依赖托管嵌入端点或 SaaS 向量数据库。语料使用 Kubernetes 官方文档,原文采集时包含 1,669 个 Markdown 文件、约 14.7 MB;Ollama 提供 llama3.1:8b,Qdrant 保存本地向量,LangChain 负责串联检索与生成。
重点是原文的完整运行数据:27,316 个文本块以每秒 90.7 块的速度导入;热查询通常在约 1.5 秒内完成;再使用 12 个手写 Kubernetes 问题,通过 ragas 评估忠实度、答案相关性与上下文精确率。正文提到的 ingest.py、query.py、evaluate.py 等完整配套脚本位于原文配套项目,不是本文每段代码已经包含的文件;以下保留正文给出的代码与运行方法。
原文于 2026 年 8 月审阅。运行数字采集于 2026 年 5 月,环境为 Ubuntu 22.04、NVIDIA RTX 4090、Ollama 0.5.7、Qdrant 1.12.6、LangChain 0.3.27、768 维 nomic-embed-text、llama3.1:8b Q4_K_M、ragas 0.2.15。下文不是译稿另行实测结果。
为什么选择这套组合
三种工具各司其职。Ollama 在 11434 端口提供嵌入与聊天模型 HTTP API,管理本地模型文件并按环境使用 GPU。Qdrant 保存稠密向量,支持载荷、过滤、REST、gRPC 和浏览器管理界面。LangChain 提供 RunnableLambda、RunnableParallel、QdrantVectorStore 与 OllamaEmbeddings,减少检索链的连接代码。
准备好模型、语料、依赖与缓存后,这套系统可以在隔离网络中运行,适合不希望把原型查询发往外部服务的场景。小规模语料也可根据模型大小放到资源较充足的迷你主机上,但不能据此套用 RTX 4090 的性能数字。
取舍之一是吞吐。托管嵌入服务可能利用集中批处理获得更高吞吐;本文同步调用 Ollama 的方式则受每批 HTTP 调用与模型调度开销影响。Ollama 并非在所有配置下都只能串行处理,下面的测量反映的是本文模型、版本与调用方式。
前置条件
- 一台 Linux 主机,配备 NVIDIA GPU。原文建议显存至少 8 GB、24 GB 更宽裕,实际测试使用 RTX 4090。
- Ubuntu 22.04 或更新系统,32 GB 内存、60 GB 可用磁盘。
- 可用的 NVIDIA 驱动;原文版本为 580.126.09,Ollama 为 0.5.7。
- Python 3.10 及以上和 pip,以及用于检查的 curl、git、jq。
- 初次准备时可以通过 HTTPS 下载模型与语料。
llama3.1:8b约 4.9 GB,nomic-embed-text约 274 MB。
本文不用 Docker,而以普通二进制运行 Qdrant,以系统服务运行 Ollama,便于直接观察进程与调用。生产中也可以使用容器,只要验证存储、网络和版本一致。
第 1 步:设置可复用的 Shell 变量
后面的命令复用同一组变量,先在当前 SSH 会话导出:
export RAG_ROOT="/opt/rag"
export CORPUS_DIR="${RAG_ROOT}/corpus"
export QDRANT_URL="http://127.0.0.1:6333"
export OLLAMA_BASE_URL="http://127.0.0.1:11434"
export COLLECTION="k8s_docs"
export EMBED_MODEL="nomic-embed-text"
export LLM_MODEL="llama3.1:8b"
检查变量是否正确:
echo "ROOT:  ${RAG_ROOT}"
echo "QDRANT: ${QDRANT_URL}"
echo "OLLAMA: ${OLLAMA_BASE_URL}"
echo "COLL:   ${COLLECTION}"
这些变量只在当前 Shell 及其子进程生效。重新连接或切换到 sudo -i 后,需要重新设置。离线运行前还应预先准备依赖、语料和 tokenizer 等缓存,不能认为只下载模型就完成全部网络依赖准备。
第 2 步:安装 Ollama 并下载模型
上游安装脚本会安装 Ollama、注册 systemd 服务并启动监听器。执行任何下载脚本前,应按自己的环境核对来源与内容。
curl -fsSL https://ollama.com/install.sh | sh
systemctl enable --now ollama
ollama --version
下载嵌入模型与聊天模型:
ollama pull "${EMBED_MODEL}"
ollama pull "${LLM_MODEL}"
ollama list
原文网络环境中,两者合计约 90 秒完成下载。模型保存在磁盘中,第一次请求时再按配置装载到内存与显存。
第 3 步:在本地运行 Qdrant
系列其他章节使用 Docker 或软件包;本篇在单用途测试主机上使用发布二进制。
mkdir -p /opt/qdrant/{storage,snapshots}

export QDRANT_VERSION="v1.12.6" #https://github.com/qdrant/qdrant/releases
cd /tmp
curl -fsSL -o qdrant.tar.gz \
  "https://github.com/qdrant/qdrant/releases/download/${QDRANT_VERSION}/qdrant-x86_64-unknown-linux-gnu.tar.gz"
tar -xzf qdrant.tar.gz
install -m 0755 qdrant /usr/local/bin/qdrant
写入最小配置,明确数据与快照目录:
cat >/opt/qdrant/config.yaml <<'YAML'
service:
  host: 0.0.0.0
  http_port: 6333
  grpc_port: 6334
  enable_cors: true
storage:
  storage_path: /opt/qdrant/storage
  snapshots_path: /opt/qdrant/snapshots
log_level: INFO
YAML
用简单包装命令启动。实验中使用后台进程,长期运行则应配置 systemd 等进程管理。
nohup /usr/local/bin/qdrant --config-path /opt/qdrant/config.yaml \
  > /var/log/qdrant.log 2>&1 &
sleep 3
curl -s "${QDRANT_URL}/" | jq
检查二进制已启动、REST 监听 6333,并核对构建信息:
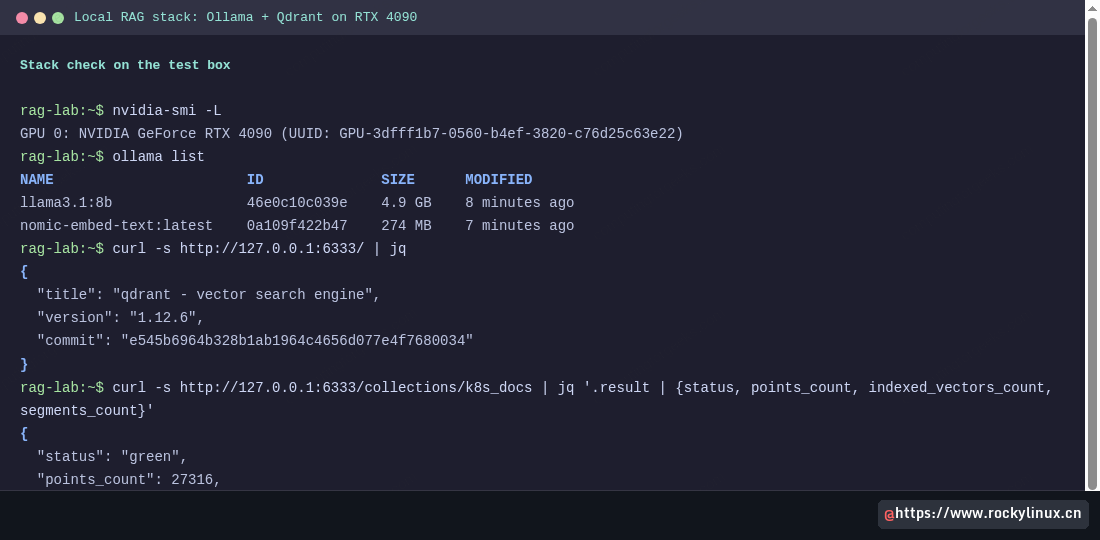
若 curl 没有输出或端口被占用,查看 /var/log/qdrant.log 的启动异常。Ubuntu 22.04 上还要检查所下载二进制要求的 GLIBC,相关问题见后文。
第 4 步:建立 LangChain 的 Python 虚拟环境
运行时主要使用 langchain、langchain-qdrant、langchain-ollama、qdrant-client,评估额外使用 ragas。固定版本便于复现。
apt install -y python3-venv
python3 -m venv "${RAG_ROOT}/venv"
source "${RAG_ROOT}/venv/bin/activate"
pip install --upgrade pip
安装依赖。原文配套项目的 requirements.txt 固定了软件包版本:
pip install \
  "langchain==0.3.27" \
  "langchain-core==0.3.78" \
  "langchain-community==0.3.31" \
  "langchain-qdrant==0.2.1" \
  "langchain-ollama==0.3.10" \
  "langchain-text-splitters==0.3.11" \
  "qdrant-client==1.18.0" \
  "ragas==0.2.15" \
  "datasets==3.6.0" \
  "tqdm==4.67.1"
原文使用的 qdrant-client 1.18 与服务端 1.12 并非相同次版本,可能输出兼容性警告。原文所演示调用成功,不足以证明旧服务端完整支持新客户端所有接口,也不能把协议简单称为严格子集。生产环境应采用受支持的版本组合,并在升级前验证实际调用。
第 5 步:准备语料
克隆上游 Kubernetes 文档仓库,只使用 content/en/docs,包含英文指南、概念、任务、教程与参考,不混入其他语言翻译。
mkdir -p "${CORPUS_DIR}"
git clone --depth 1 --filter=blob:none \
  https://github.com/kubernetes/website.git /tmp/k8s-website
cp -r /tmp/k8s-website/content/en/docs/. "${CORPUS_DIR}/"
find "${CORPUS_DIR}" -name '*.md' | wc -l
du -sh "${CORPUS_DIR}"
原文运行时得到 1,669 个 Markdown 文件和约 14.7 MB 正文。仓库更新会改变数量;需要复现时,应额外固定提交或版本。
第 6 步:分块、嵌入并写入
配套 ingest.py 依次执行:
- 遍历语料,移除 Hugo front matter,让嵌入主要看到正文而不是头部 YAML。
- 先按
#、##、###Markdown 标题切分,保留章节元数据,再用RecursiveCharacterTextSplitter生成 768 字符、重叠 96 字符的块。 - 每批处理 64 个块,调用 Ollama 生成嵌入。应按实际 Ollama 与集成库区分旧
/api/embeddings单输入接口和支持批量输入的新接口,不能仅凭批次大小假定一次旧接口请求支持 64 条。 - 把 768 维向量与来源路径、h1、h2、h3 等载荷写入 Qdrant。
运行导入:
cd "${RAG_ROOT}/scripts"
python ingest.py
原文 RTX 4090 环境从 1,669 个文件生成 27,316 个块,用时 5 分 1 秒,即每秒约 90.7 块:
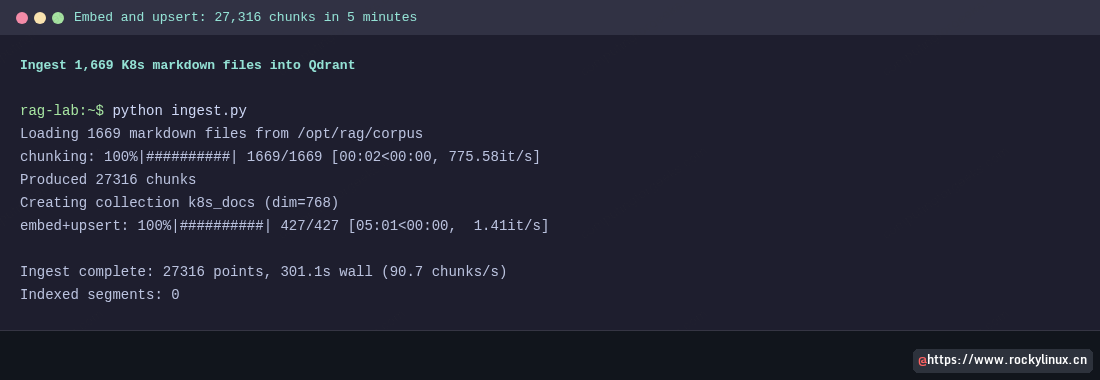
原文观察 GPU 利用率约 36%,认为同步调用的批次开销限制了吞吐。增加批次和异步并发可能改善,但应同时测量模型调度、CPU、网络与显存,不能仅凭利用率确认唯一瓶颈。一次性导入可以先选择简单实现。
indexing_threshold 的单位问题
原文脚本结束时显示 Indexed segments: 0,集合有 27,316 个点,却没有计入 HNSW 的向量。原文把 indexing_threshold 当成向量数量有误:它按每个段的向量数据大小计算,单位为 KB。 对本文 768 维 float32 向量,每个约占 3 KB 原始向量数据;分成八段后每段约 3,414 个点,约 10 MB,可能低于原文旧版本配置的 20000 KB 阈值。
因此,问题要结合维度、段数量与实际阈值解释,不能泛化为“每段少于 20,000 点就不索引”。可降低阈值来促进构建:
curl -s -X PATCH "${QDRANT_URL}/collections/${COLLECTION}" \
  -H "Content-Type: application/json" \
  -d '{"optimizer_config": {"indexing_threshold": 1000}}'
等待优化器处理,再检查索引计数:
curl -s "${QDRANT_URL}/collections/${COLLECTION}" \
  | jq '.result | {status, points_count, indexed_vectors_count, segments_count}'
在本文每点一个稠密向量的集合中,完成后两项计数预期接近 27,316。其他命名向量或多向量集合不能直接照搬这一等式。若长时间仍为 0,应检查 optimizer_status、优化任务和错误日志。
第 7 步:构建 LCEL 检索链
链路采用常见的 retriever | prompt | llm | parser 结构,同时返回命中的块,供调用方展示来源:
from operator import itemgetter
from langchain_core.output_parsers import StrOutputParser
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.runnables import RunnableLambda, RunnableParallel
from langchain_ollama import ChatOllama, OllamaEmbeddings
from langchain_qdrant import QdrantVectorStore
from qdrant_client import QdrantClient

PROMPT = ChatPromptTemplate.from_messages([
    ("system",
     "You are a senior Kubernetes engineer. Use ONLY the context below. "
     "If the context does not answer the question, say so plainly. "
     "Keep answers tight - 4 to 8 sentences - and prefer concrete commands."),
    ("human", "Context:\n{context}\n\nQuestion: {question}\n\nAnswer:"),
])

def format_docs(docs):
    return "\n\n".join(
        f"[{i+1}] {d.metadata['source']}\n{d.page_content}"
        for i, d in enumerate(docs)
    )

client = QdrantClient(url=QDRANT_URL)
emb    = OllamaEmbeddings(model=EMBED_MODEL, base_url=OLLAMA_BASE_URL)
store  = QdrantVectorStore(client=client, collection_name=COLLECTION, embedding=emb)
retriever = store.as_retriever(search_kwargs={"k": 5})
llm    = ChatOllama(model=LLM_MODEL, base_url=OLLAMA_BASE_URL, temperature=0.2)

answer = (
    {"context": itemgetter("docs") | RunnableLambda(format_docs),
     "question": itemgetter("question")}
    | PROMPT
    | llm
    | StrOutputParser()
)

chain = RunnableParallel(
    question=itemgetter("question"),
    docs=itemgetter("question") | retriever,
).assign(answer=answer)
关键是 RunnableParallel:检索器接收问题并返回前 5 篇文档,一路经 format_docs 生成提示中的 context,另一路把相同文档交给调用方展示。这样无需额外回调或手工维护命中块列表。
第 8 步:向文档提问
完整 query.py 把检索链包装为命令行程序,输入问题后返回答案和来源文件列表:
python query.py "How do I drain a node before maintenance?"第一次查询需要装载 llama3.1:8b,原文 RTX 4090 上约增加 4 秒,之后查询通常在 1 至 2 秒内完成。
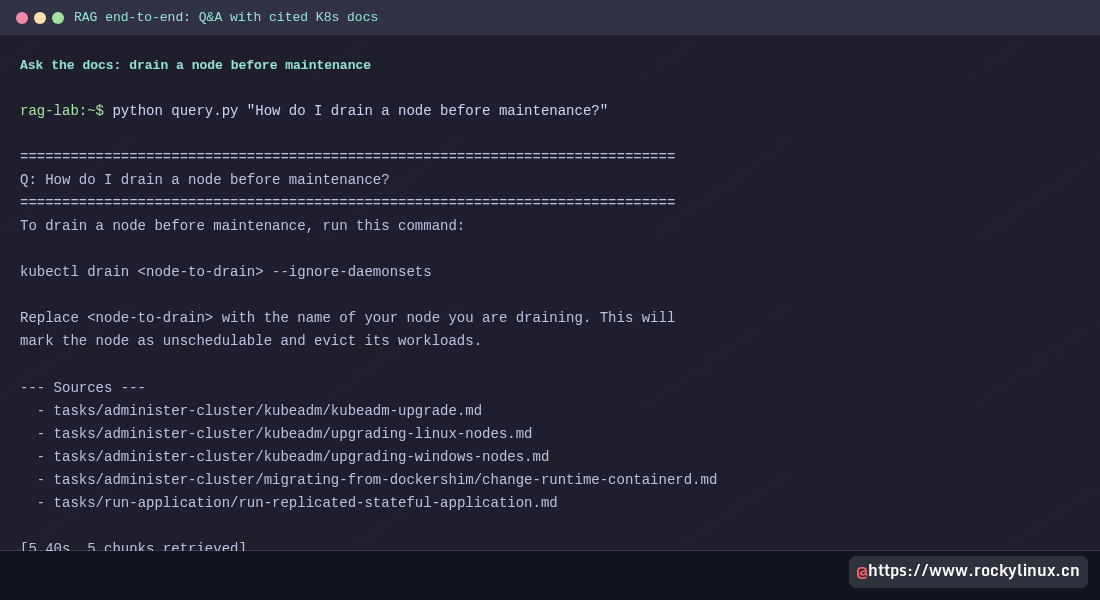
原文案例中,kubectl drain <node> --ignore-daemonsets 出现在引用的五个块中的两个,回答解释也来自附近段落。来源指向 tasks/administer-cluster/ 下的真实文件,可继续核对上下文。另三个不同主题的问题用时约 1.2 至 1.5 秒。
第 9 步:使用 ragas 评估
仅凭“看起来正确”还不够。原文使用三个常见指标:
- Faithfulness(忠实度): 答案中的陈述是否受检索上下文支持。
- Answer relevancy(答案相关性): 答案是否回应问题,不能把它直接当作事实正确率。
- Context precision(上下文精确率): 检索列表前部是否包含真正有用的块,关注相关上下文的排序。
evaluate.py 用 12 个手写 Kubernetes 问题运行检索链,再让本地 llama3.1:8b 参与评分。这样不依赖外部付费评审 API,但会消耗本地算力,而且同一小模型既生成又评审可能存在偏差,不能把结果当成人工标注的准确率。
python evaluate.py原文完整汇总如下:

| 指标 | 均值 | 中位数 | 含义 |
|---|---|---|---|
| Faithfulness | 0.821 | 1.000 | 答案陈述是否受命中块支持 |
| Answer relevancy | 0.875 | 0.879 | 是否回答了所提问题 |
| Context precision | 0.980 | 1.000 | 有用上下文是否排在前列 |
| 查询延迟 | 1.26 秒 | 1.05 秒 | 检索与生成的端到端耗时 |
| p95 查询延迟 | 1.90 秒 | — | 原文有一个异常样本达到 2.4 秒 |
忠实度均值 0.821、中位数 1.000,说明这批评分中多数回答获得高分,少数回答拉低均值。原文把尾部问题归因于额外添加的无依据语句,可通过加强“上下文不足就明确说明”的提示继续检查。样本只有 12 个,应扩大问题集并人工核验后再判断效果。
性能与调优记录
- 显存占用。 原文空闲约 948 MiB;聊天模型已热加载、嵌入模型待命时约 6.8 GB。在该量化与上下文设置下,12 GB 显卡较宽裕;不同上下文与并发会改变需求。
- 嵌入吞吐。 批次 64 的同步导入约 90.7 块/秒。补充实验用
asyncio.gather保持 8 个请求在途,达到约 220 块/秒,但增加了复杂度。 - 查询耗时分布。 平均 1.26 秒中,Qdrant 检索约 25 毫秒,问题嵌入约 80 毫秒,其余主要来自生成。这里检索开销较小,但不能理解为完全没有成本。
- Top-k。 原文以 5 为默认;一个小规模补充测试改为 8 后忠实度增加约 0.04,同时提示长度明显增加;减到 3 时因缺少关键块而下降。应按真实问题集调节。
实现过程中的六个问题
- 二进制与 GLIBC 不兼容。 原文在 Ubuntu 22.04 的 GLIBC 2.35 上遇到
GLIBC_2.38 not found,因此使用 v1.12.6。不能据此断言所有 Qdrant 1.13 之后的所有构建都要求同一 GLIBC;应核对具体发布资产、架构与构建要求,必要时升级系统或使用兼容容器。 - 索引阈值按段、以 KB 计算。 本例段较小时可能不构建 HNSW,降低为 1000 也表示约 1000 KB,不是 1000 个点。导入后观察真实索引与优化状态。
- 同步嵌入循环限制吞吐。 异步调用或
OLLAMA_NUM_PARALLEL可能改善,但并发能力取决于版本、模型、调度与显存,必须实测。 - 冷查询需要装载模型。 若冷启动计入 SLO,可在服务启动时预热;Ollama 的
keep_alive控制保留时长,本文版本默认约 5 分钟。 - 评估依赖可能首次下载 tokenizer。 应在允许联网的准备阶段运行最小导入与评估,填充所需缓存,再验证断网运行,不能忽略代理导致的下载失败。
- Hugo front matter 会引入噪声。 Kubernetes 文档开头的 YAML 元数据应在嵌入前识别并移除,避免无关页面因相似元数据被召回。
与其他方案的关系及扩展
已有 PostgreSQL 平台的团队也可以评估 pgvector,减少单独存储服务的运维。Qdrant 的专用载荷索引、地理条件、稀疏向量与 Web UI 则提供另一组能力,不能把 PostgreSQL 本身的全文或地理扩展能力一概当作不存在。文档 RAG 中,按 Kubernetes 次版本或来源路径限定检索范围,是元数据过滤的典型用途。
本文未展开 FastAPI 对外封装,也未在本篇实现 BM25 与稠密向量混合检索;这些都可在现有链路上增加。当前系列的过滤与索引章节已讨论混合检索,不能把原文“下一篇”误当成另有未采集的章节。
换成自己的语料时,把 Markdown 或文本放到 /opt/rag/corpus,调整加载器后重新运行 ingest.py。原文配套分块器也处理 reStructuredText;若要支持 PDF,可在 load_chunks() 中加入 langchain_community.document_loaders.PyPDFLoader。无论内容主题如何,都要同步核对清洗、分块、嵌入模型维度与集合配置。