过滤器让向量搜索从演示走向实际应用。单纯的近邻查询只会返回“最接近的 10 个向量”,并不关心商品是否有货、是否位于配送范围,或者是否符合预算。Qdrant 的过滤语言与载荷索引负责表达这些约束。本篇聚焦它们的实际用法。
原文在包含 100,000 件商品的 Qdrant 1.18.1 环境中测试了过滤模式,并对比创建索引前后的延迟。其中,品牌与评分组合过滤的向量查询获得约 62 倍加速,索引构建耗时约 5 秒。以下测量均沿用原文记录,并非译稿另行实测。
原文测试环境:2026 年 5 月,Ubuntu 24.04.4 LTS、Qdrant 1.18.1、qdrant-client 1.18.0、fastembed 0.8.0,模型为 BAAI/bge-small-en-v1.5 与 Qdrant/bm25。
为什么过滤字段需要独立索引
HNSW 擅长快速遍历向量空间,但仅靠向量图不能高效回答“只返回 category 为 Laptops 的点”。缺少载荷索引时,服务器需要更多载荷检查或扫描;当符合条件的数据很少时,额外工作会明显影响延迟与召回。
载荷索引为查询规划器提供匹配集合与基数估计,并配合可过滤 HNSW 或直接扫描等执行策略完成查询。它并非简单地先搜索再删除不符结果,而是帮助引擎选择更合适的搜索路径。对选择性高的过滤器,收益尤为明显:在原文的 10 万个点中,一个品牌约匹配 6,700 个,不到总量的 7%;覆盖 80% 商品的价格区间则难以排除大量候选。
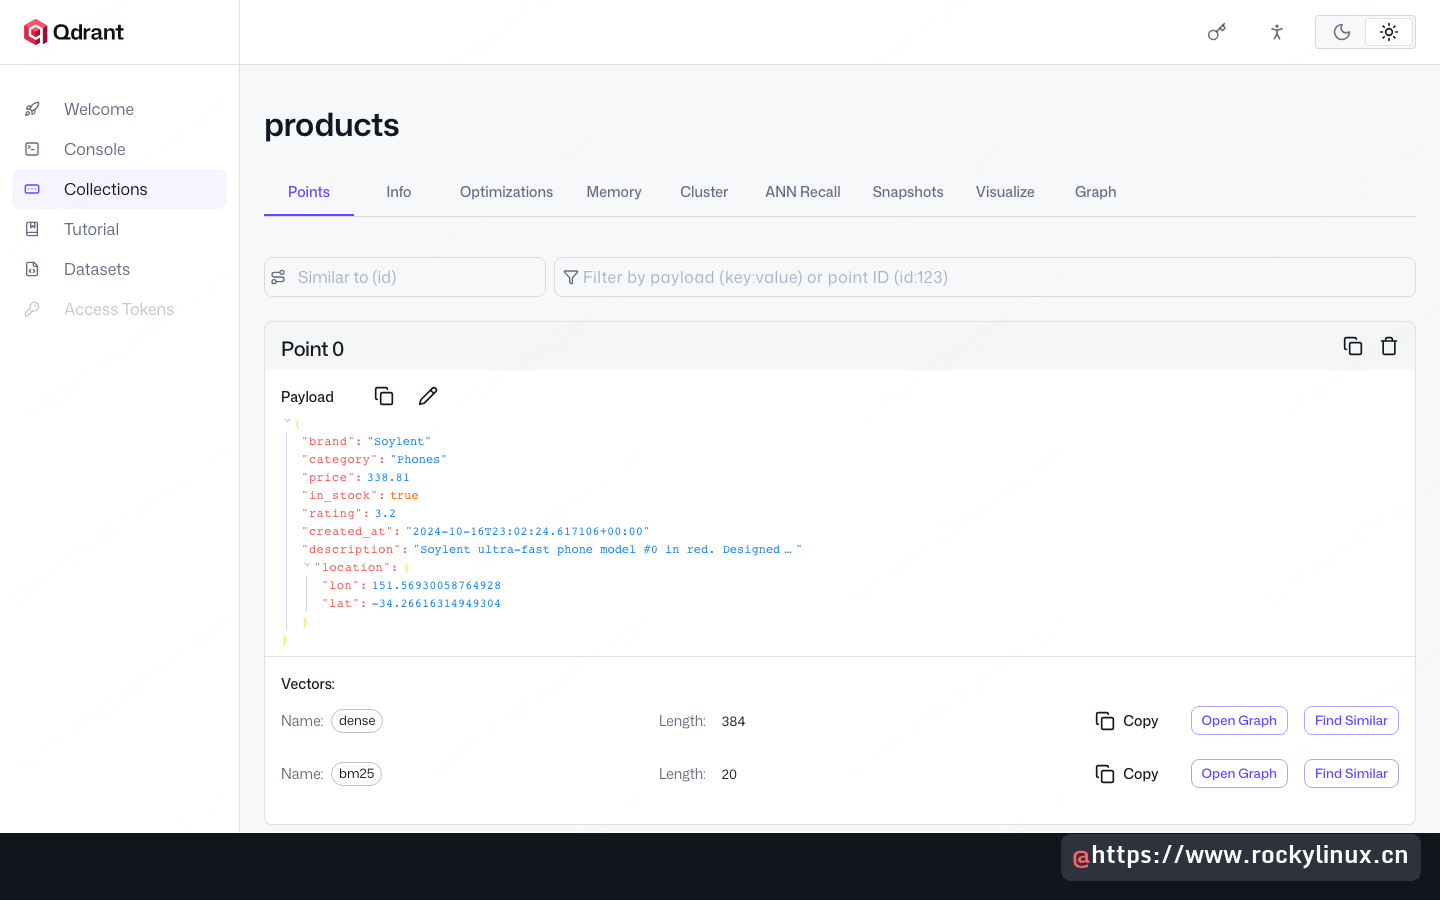
本文使用一个合成电商目录,每件商品含 8 个载荷字段和两种向量:384 维 BGE-small 稠密向量,以及 BM25 稀疏向量。原文通过配套 load_ecommerce.py 脚本加载,两个段中分别索引了约 100,000 个稠密向量和 100,000 个稀疏向量。在 Web UI 中可以直接看到数据结构:
按字段类型创建载荷索引
本文涉及以下七类常用索引。应根据字段类型和查询操作选择,而不是为每个字段机械创建相同索引;这里也不是对所有版本索引类型的穷举。
| 索引类型 | 适用数据 | 过滤操作 |
|---|---|---|
KEYWORD |
分类、品牌、SKU 等精确匹配字符串 | match、match_any、match_except |
INTEGER |
年份、数量等整数及范围 | match、range |
FLOAT |
价格、评分、重量等数值范围 | range |
BOOL |
是否有货、是否归档等布尔标记 | match |
GEO |
半径、矩形范围或多边形地理条件 | geo_radius、geo_bounding_box、geo_polygon |
DATETIME |
RFC3339 时间戳 | 使用时间值的 range |
TEXT |
载荷字符串全文检索 | match_text |
可以在一个 Python 脚本中完成创建。原文的 10 万点集合中,每次调用通常耗时数百毫秒,Qdrant 会按段构建索引:
from qdrant_client import QdrantClient, models

client = QdrantClient(url="http://localhost:6333")

# Keyword with is_tenant: splits the index per category so single-tenant
# queries skip the rest of the collection entirely.
client.create_payload_index(
    collection_name="products", field_name="category",
    field_schema=models.KeywordIndexParams(type="keyword", is_tenant=True),
    wait=True,
)

# Plain enums work for the simpler types
for field, schema in [
    ("brand",      models.PayloadSchemaType.KEYWORD),
    ("price",      models.PayloadSchemaType.FLOAT),
    ("rating",     models.PayloadSchemaType.FLOAT),
    ("in_stock",   models.PayloadSchemaType.BOOL),
    ("created_at", models.PayloadSchemaType.DATETIME),
    ("location",   models.PayloadSchemaType.GEO),
]:
    client.create_payload_index(
        collection_name="products",
        field_name=field, field_schema=schema, wait=True,
    )

# Text index needs an explicit tokenizer
client.create_payload_index(
    collection_name="products", field_name="description",
    field_schema=models.TextIndexParams(
        type="text",
        tokenizer=models.TokenizerType.WORD,
        min_token_len=2, max_token_len=20, lowercase=True,
    ),
    wait=True,
)
原文创建全部 8 个字段索引共耗时 4.7 秒。通过 get_collection 返回的 payload_schema 核对结果:每个已索引字段都应出现在列表中,遗漏字段则不会出现。
组合 must、should 与 must_not
过滤器可以组合三组布尔条件:must 要求全部满足,should 要求至少满足一项,must_not 要求各项均不匹配;不同组之间共同构成约束。
技术修正: should 在这里是“至少满足一个”的硬过滤条件,不是软偏好,也不会按匹配条件数自动提高向量相似度分数。
flt = models.Filter(
    must=[
        models.FieldCondition(key="category",
            match=models.MatchValue(value="Laptops")),
        models.FieldCondition(key="price",
            range=models.Range(gte=200, lte=800)),
    ],
    should=[
        models.FieldCondition(key="brand",
            match=models.MatchValue(value="Stark")),
        models.FieldCondition(key="brand",
            match=models.MatchValue(value="Wayne")),
    ],
    must_not=[
        models.FieldCondition(key="in_stock",
            match=models.MatchValue(value=False)),
    ],
)
该过滤器表示:商品必须是笔记本电脑,价格在 200 至 800 美元之间,当前有货,并且品牌至少匹配 Stark 或 Wayne 中的一项。向量搜索通过 query_filter 传入,纯遍历通过 scroll_filter 传入;两者使用相同的条件结构与索引。
范围、地理位置、日期时间和全文条件
以下四类条件尤其容易用错。要注意操作数类型:有的类型错误会直接报错,而字段结构不符合预期也可能只得到空结果。
# 1. Numeric range: price between 200 and 800
models.FieldCondition(key="price",
    range=models.Range(gte=200, lte=800))

# 2. Datetime range: created in the last 90 days (RFC3339 string)
models.FieldCondition(key="created_at",
    range=models.DatetimeRange(gte="2026-02-25T00:00:00Z"))

# 3. Geo radius: within 50 km of Tokyo, lon/lat order
models.FieldCondition(key="location",
    geo_radius=models.GeoRadius(
        center=models.GeoPoint(lon=139.6917, lat=35.6895),
        radius=50_000,    # meters
    ))

# 4. Geo bounding box: anywhere inside continental Europe
models.FieldCondition(key="location",
    geo_bounding_box=models.GeoBoundingBox(
        top_left=models.GeoPoint(lon=-10.0, lat=72.0),
        bottom_right=models.GeoPoint(lon=40.0, lat=36.0),
    ))

# 5. Full-text match: words found in the description payload
models.FieldCondition(key="description",
    match=models.MatchText(text="wireless travel"))
首先,地理位置示例使用 lon 与 lat 表示经度、纬度。为避免与习惯的“纬度、经度”顺序混淆,应显式使用命名参数;交换数值可能把门店放到错误位置,最终匹配不到商品。
其次,示例的日期时间使用带时区的 RFC3339 字符串,末尾 Z 表示 UTC。应先把来源日期规范化为服务器接受的格式,避免解析失败或时区歧义。
第三,全文匹配应为字段配置文本索引。本文用 TextIndexParams 显式指定分词器,例如 WORD、WHITESPACE、PREFIX 或 MULTILINGUAL。分词方式在建索引时确定,不能在每次查询时任意切换。原文把裸 PayloadSchemaType.TEXT 一概写成不可用过于绝对;需要自定义行为时,使用显式参数最清楚。
创建载荷索引之前的基准结果
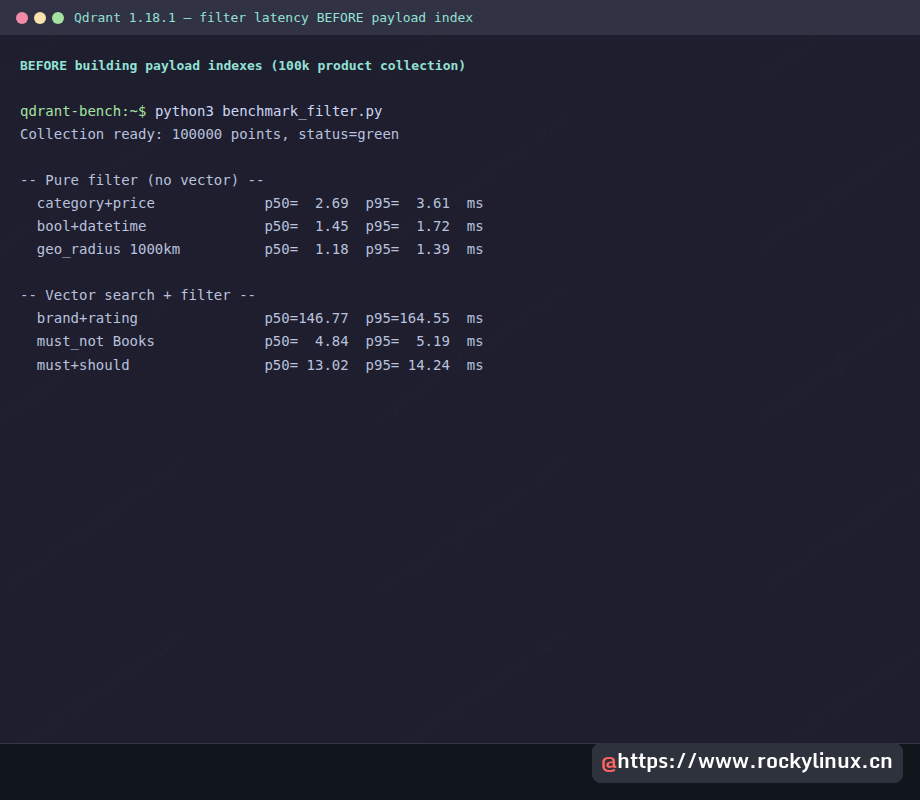
以下基准在没有载荷索引的 10 万点集合上执行 6 种查询,每种重复 50 次:其中三种只做过滤,三种同时执行向量搜索与过滤。延迟单位为毫秒:
BEFORE building payload indexes
======================================================================
  -- Pure filter (no vector) --
  category+price       p50=  2.69  p95=  3.61  ms
  bool+datetime        p50=  1.45  p95=  1.72  ms
  geo_radius 1000km    p50=  1.18  p95=  1.39  ms

  -- Vector search + filter --
  brand+rating         p50=146.77  p95=164.55  ms
  must_not Books       p50=  4.84  p95=  5.19  ms
must+should p50= 13.02 p95= 14.24 ms纯过滤在返回数量较小时仍可提前结束扫描,因此延迟尚可。向量与过滤组合的代价更明显:brand+rating 的中位延迟达到 146 毫秒,载荷检查与候选筛选消耗大量时间。
构建索引 4.7 秒之后再次查询
原文为 8 个字段建立索引,其中包括 description 的全文索引,总计耗时 4.7 秒。对相同的 6 种查询再次各执行 50 次:
AFTER building payload indexes
======================================================================
  -- Pure filter (no vector) --
  category+price       p50=  1.00  p95=  1.18  ms   (2.7x faster)
  bool+datetime        p50=  0.99  p95=  1.10  ms   (1.5x)
  geo_radius 1000km    p50=  0.98  p95=  1.04  ms   (1.2x)

  -- Vector search + filter --
  brand+rating         p50=  2.36  p95=  2.49  ms   (62x faster)
  must_not Books       p50=  1.86  p95=  2.04  ms   (2.6x)
  must+should          p50=  1.70  p95=  1.97  ms   (7.7x)

  -- After: full-text payload match --
  match_text 'wireless travel'  p50=  0.96  p95=  1.11  ms
选择性最高的向量加过滤查询从 146 毫秒降到 2.36 毫秒,约为 62 倍加速。其他向量查询提升约 2 至 8 倍;纯过滤查询提升约 1.2 至 2.7 倍,因为它们在低 limit 下原本已能较早停止扫描。
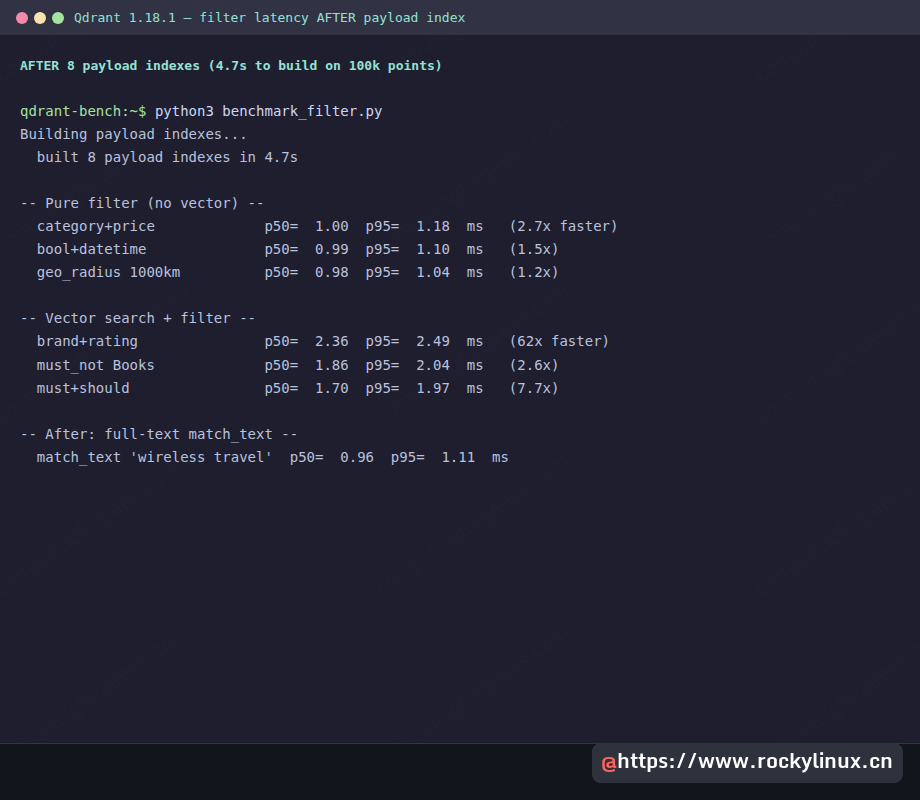
最后一项 match_text 在文本索引建立后可以高效执行,原文测试延迟约为 1 毫秒。它主要利用倒排索引,不必走完整向量搜索路径;数据规模、词项分布与命中数量变化后,耗时仍会变化,不能理解成恒定 1 毫秒。
使用 prefetch 与倒数排名融合进行混合搜索
稠密和稀疏向量反映不同信号。BGE-small 的稠密嵌入侧重语义,例如“轻便无线耳机”可能匹配描述为“便携”“无绳”的商品;BM25 稀疏向量侧重词项匹配,适合找出实际包含查询词的商品。
Qdrant 从 1.10 起支持在一次查询中使用 prefetch 与 FusionQuery 组合多个召回结果。每个预取阶段取得自己的前 N 项,随后进行融合。倒数排名融合(Reciprocal Rank Fusion,RRF)按排名贡献权重,常用表达为 1/(k + rank),再跨检索列表求和:
from qdrant_client import QdrantClient, models
from fastembed import SparseTextEmbedding, TextEmbedding

client = QdrantClient(url="http://localhost:6333")
dense_model = TextEmbedding("BAAI/bge-small-en-v1.5")
sparse_model = SparseTextEmbedding("Qdrant/bm25")

q = "lightweight wireless headphones for travel"
dv = next(dense_model.embed([q])).tolist()
sv = next(sparse_model.embed([q]))
sparse_q = models.SparseVector(
    indices=sv.indices.tolist(),
    values=sv.values.tolist(),
)

res = client.query_points(
    collection_name="products",
    prefetch=[
        models.Prefetch(query=dv,       using="dense", limit=50),
        models.Prefetch(query=sparse_q, using="bm25",  limit=50),
    ],
    query=models.FusionQuery(fusion=models.Fusion.RRF),
    limit=5,
    with_payload=True,
)
每个预取请求的 using= 指向集合中的命名向量。稀疏查询使用 SparseVector,填入 fastembed 生成的 BM25 索引与权重。融合阶段只处理排名列表,无需再次读取原始向量,因此开销较小。
原文在 10 万商品上测试了 5 个电商查询:
Timings (5 queries each)
============================================================
  dense    p50=  2.49  ms
  sparse   p50=  1.85  ms
  hybrid   p50=  4.68  ms
混合查询的耗时大致是两次检索加少量融合开销,原文中位数低于 5 毫秒。收益与成本需要同时考虑:混合搜索经常能改善前 K 项质量,但并非每次都更好,而且必须承担两路召回的成本。
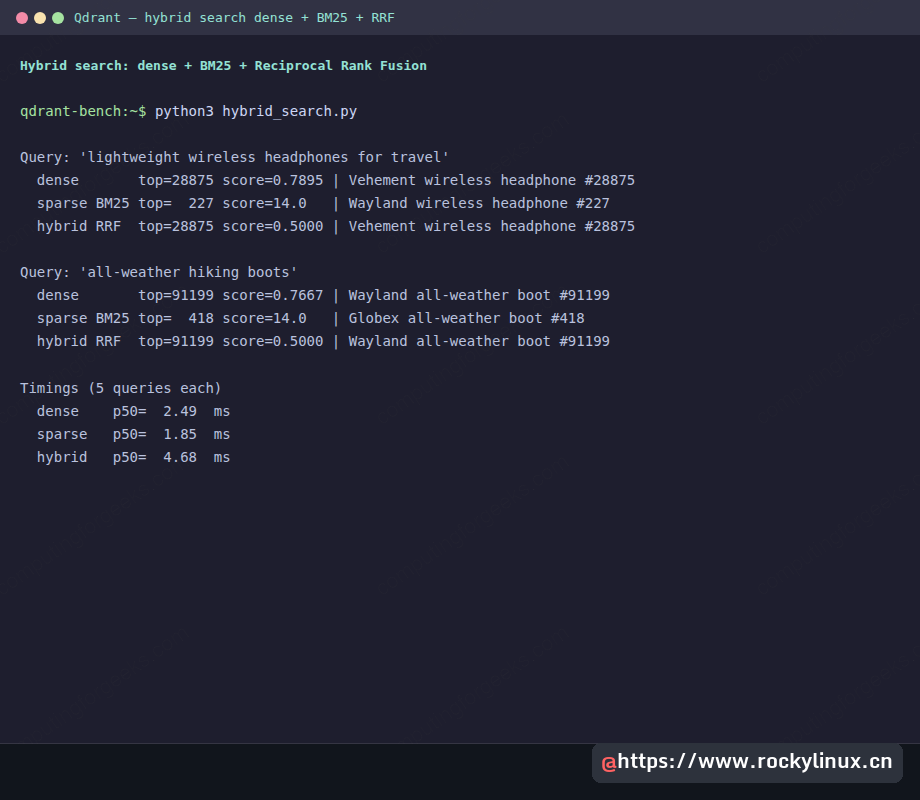
在测试语料中,5 个查询里有 3 个仍由稠密搜索的第一名胜出;“降噪入耳式耳机”则在融合后返回了另一件商品,因为 BM25 把稠密模型排得较后的精确词项匹配结果带了上来。这正是混合搜索在商品目录中的一个价值所在。
多阶段检索:先 BM25,再按稠密向量重排
预取链不限于两路检索或 RRF。常见生产模式是先用 BM25 将候选缩小到约 200 项,再使用稠密向量对这些候选重排。第一阶段便宜且召回面广,第二阶段在较小候选集上计算相似度:
res = client.query_points(
    collection_name="products",
    prefetch=models.Prefetch(
        query=sparse_q, using="bm25", limit=200,
        filter=models.Filter(must=[
            models.FieldCondition(key="in_stock",
                match=models.MatchValue(value=True)),
        ]),
    ),
    query=dv,
    using="dense",
    limit=10,
)
这段查询先找出有货商品中的前 200 个 BM25 结果,再按稠密向量排序,返回前 10 项。过滤器放在预取阶段,因此后续重排只处理有货候选。in_stock 或地理范围等硬约束也可以按同样思路尽早应用。
基数、索引阈值与段数量带来的性能问题
载荷索引的收益与过滤选择性有关。匹配 90% 数据的条件无法排除多少候选,匹配 0.1% 的条件则能跳过绝大多数数据。优先索引实际高频过滤的字段,因为每个索引都会增加内存与写入成本。
另一项要检查的是优化器的 indexing_threshold。原文把它写成默认 20,000 个向量有误:该阈值按每个段的向量数据大小计算,单位是 KB;Qdrant 1.18.1 官方配置默认值为 10000。 是否跨过阈值取决于维度和数据量,不能仅用每段点数判断。集合切成许多小段时,可能有较多数据尚未构建 HNSW。
可在 Info 页检查 indexed_vectors_count,结合 points_count、每点向量数量、命名向量与段配置分析。需要时降低阈值,或适当减少 default_segment_number,让单段更大;不能把向量计数与点计数简单视为永远一一对应。
多租户字段,例如 customer_id 或 organization,可在关键词索引上使用 is_tenant=True。它向优化器提示该字段用于租户划分,有助于相关数据的组织与访问局部性;查询仍必须携带租户过滤器,不能把索引提示当成租户隔离或权限控制。
容易踩到的五个问题
- 经纬度次序混淆。 用
GeoPoint(lon=..., lat=...)显式标注,不依赖位置参数习惯;数值交换可能只表现为空结果。 - 日期时间格式不统一。 示例使用带
Z或明确偏移量的 RFC3339 时间,导入前应规范化并核对时区。 - 全文索引的分词配置。 要自定义分词器,用
TextIndexParams明确指定;选择在建索引时生效,不是在查询时生效。 indexing_threshold按段且以 KB 计量。 不能以“每段不足 20,000 点”直接断定没有索引,应结合向量维度、配置和实际索引计数判断。- 命名向量查询需要选择向量。 本文集合同时包含
dense与bm25,查询要通过using=明确指定相应向量。缺少所需名称可能返回 400,而不会自动选择列表中的第一项。
实用的载荷索引策略
- 优先为向量查询中经常使用、选择性高的硬过滤字段建索引。原文
brand+rating的 62 倍提升是特定数据与查询的测量,并不意味着每个组合都能获得相同加速。 - 偶尔才过滤的字段应权衡成本。90% 查询都使用的 category 通常值得建索引,每周只查询一次的 internal_note 则未必。
- 结合向量维度、数据 KB 数和段数量设置索引阈值,并观察稳定负载下的索引覆盖、优化状态和查询延迟;必要时减少段数量,而不是增大段数。
过滤和载荷索引是 Qdrant 实际使用中的关键。导入数据时就规划常用字段索引,随后在 Web UI 持续观察索引状态。对于不到百万点、向量加过滤却明显偏慢的查询,可以先检查索引与执行条件,再结合硬件、查询维度、过滤复杂度和并发判断原因。