Qdrant 集合承载向量、载荷及用于加速条件检索的索引。集合结构设计正确,后续应用会更容易维护;设计不当,则可能同时增加运行内存与迁移成本。对于已有 PostgreSQL 的系统,也可结合 pgvector 的单表方案比较取舍。
本文通过可运行的 Python 示例和对应 Web UI 配置,介绍常用集合参数,包括稠密与稀疏向量共存、磁盘存储、多租户以及通过原子别名切换替换集合。
原文于 2026 年 5 月使用 Ubuntu 24.04.4 LTS、Qdrant 1.18.1、qdrant-client 1.18.0 测试,11 类集合模式均在实际 Docker 实例中创建并检查,截图来自运行中的服务器。
集合的组成
集合包含数据点。每个点由唯一 ID、一个或多个向量、可选 JSON 载荷组成。集合还配置 HNSW 图、优化阈值、WAL、可选量化和载荷索引。
配套代码位于 c4geeks/qdrant 的 collections 目录。先按本系列对应操作系统教程启动实例,再连接自己的集群。
安装 Python 客户端:
python3 -m venv venv
source venv/bin/activate
pip install "qdrant-client[fastembed]"
后续脚本使用相同的连接代码:
from qdrant_client import QdrantClient, models
client = QdrantClient(url="http://localhost:6333")
启用认证时再传入 api_key="..."。使用 TLS 时改用 HTTPS 地址;如希望优先采用 6334 端口的 gRPC,可设置 prefer_grpc=True。
向量参数:维度与距离度量
稠密向量必须配置 size 与 distance,前者必须匹配嵌入模型维度,后者决定相似度计算方式。最简单的集合每个点只有一个向量:
client.create_collection(
    collection_name="basic_docs",
    vectors_config=models.VectorParams(
        size=384,
        distance=models.Distance.COSINE,
    ),
)
常见模型维度包括:all-MiniLM-L6-v2 为 384,BGE-base 为 768,OpenAI text-embedding-3-small 默认 1536,text-embedding-3-large 默认 3072。若模型支持输出维度配置,应以实际输出为准。集合与写入向量的维度不一致时,upsert 会失败。
| 度量 | Python 枚举 | 常见用途 |
|---|---|---|
| 余弦 | Distance.COSINE |
Sentence Transformers、MiniLM、BGE、MPNet 等文本嵌入 |
| 点积 | Distance.DOT |
模型明确使用点积,或向量长度具有意义的场景 |
| 欧氏距离 | Distance.EUCLID |
部分图像特征、地理向量及绝对尺度有意义的特征 |
| 曼哈顿距离 | Distance.MANHATTAN |
适合 L1 距离的高维特征及相关编码方案 |
不了解模型要求时,可先评估余弦,但应优先遵循模型卡给定的度量。余弦不是省略必填参数的理由;后续切换度量通常需要建立新的向量空间。
下例为每种度量创建独立集合,便于测试:
for dist in [models.Distance.COSINE, models.Distance.DOT,
             models.Distance.EUCLID, models.Distance.MANHATTAN]:
    name = f"dist_{dist.value.lower()}"
    client.create_collection(
        collection_name=name,
        vectors_config=models.VectorParams(size=128, distance=dist),
    )
这些集合各自维护索引,一次普通集合查询不会自动跨集合搜索。
命名向量:一个集合中的多个向量空间
生产数据可能同时需要标题与描述的文本嵌入、商品图片嵌入及关键词稀疏向量。命名向量将它们附加在同一个点上,通过共同 ID 对齐,但分别维护索引。
client.create_collection(
    collection_name="named_vectors",
    vectors_config={
        "text":  models.VectorParams(size=384, distance=models.Distance.COSINE),
        "image": models.VectorParams(size=512, distance=models.Distance.COSINE),
    },
)
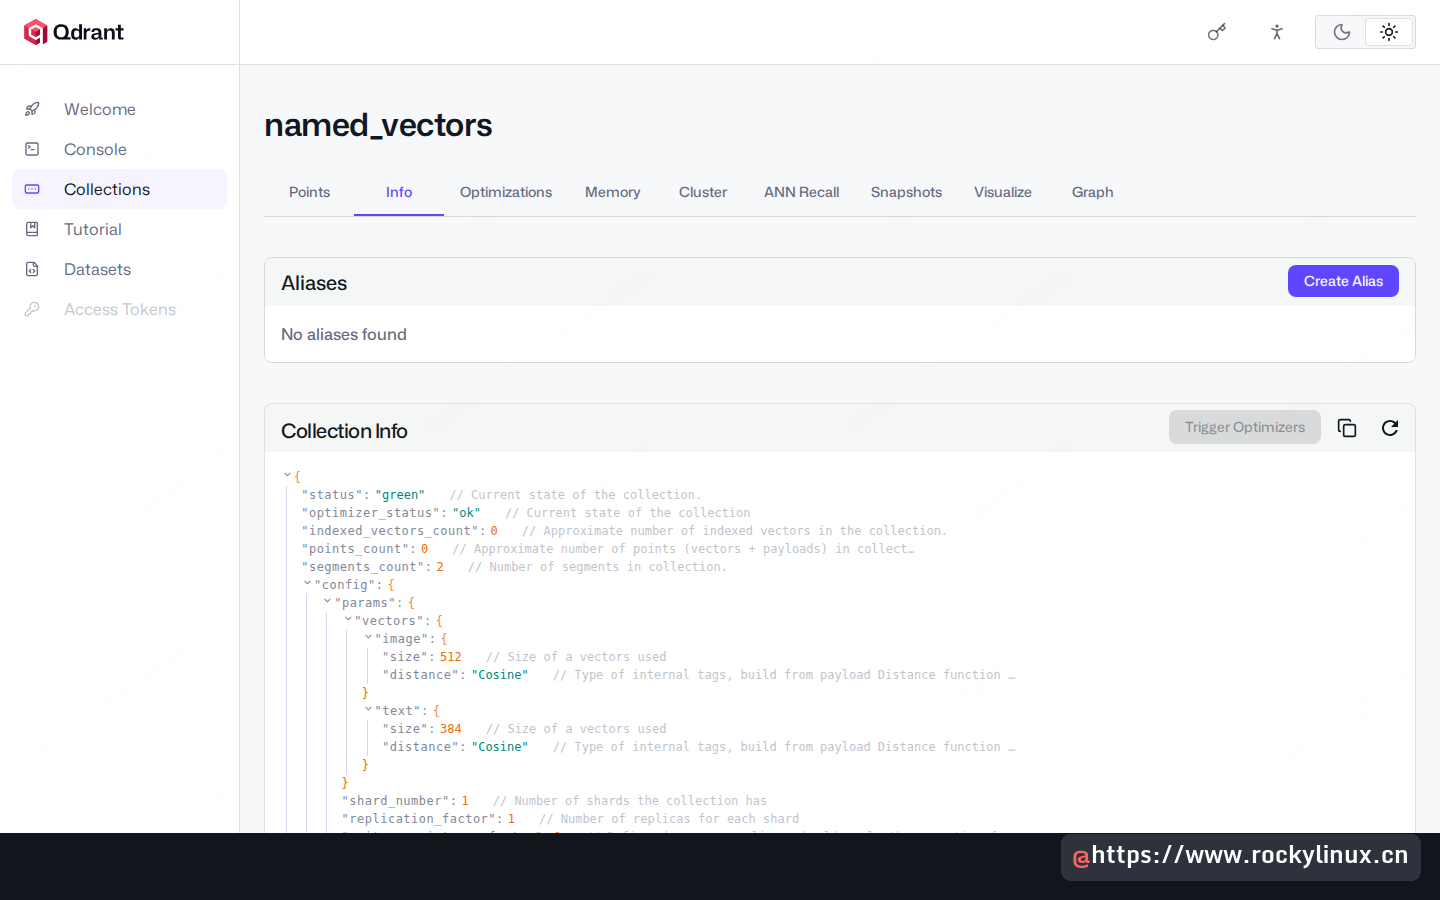
Web UI 的 Info 以嵌套映射显示各向量空间及其独立的 size、distance:
upsert 时按名称提交各向量:
client.upsert(
    collection_name="named_vectors",
    points=[
        models.PointStruct(
            id=1,
            vector={
                "text":  [0.1] * 384,
                "image": [0.2] * 512,
            },
            payload={"sku": "ABC-123"},
        ),
    ],
)
查询时通过 using 指定向量空间:
client.query_points(
    collection_name="named_vectors",
    query=[0.1] * 384,
    using="text",
    limit=10,
)
这样,每次查询可选择所需向量空间;不再需要的命名向量可通过受支持的 schema 更新移除,无须重建其他空间。
用稀疏向量进行关键词式检索
稀疏向量仅存储实际出现的维度及权重,即 (index, value) 对。理论维度可以很大,例如词表约五万维,但每条记录只保存少量非零值。Qdrant 使用倒排索引处理它们,并允许与稠密向量共存。
client.create_collection(
    collection_name="sparse_demo",
    vectors_config={
        "dense": models.VectorParams(
            size=384, distance=models.Distance.COSINE,
        ),
    },
    sparse_vectors_config={
        "sparse_idx": models.SparseVectorParams(
            index=models.SparseIndexParams(on_disk=False),
        ),
    },
)
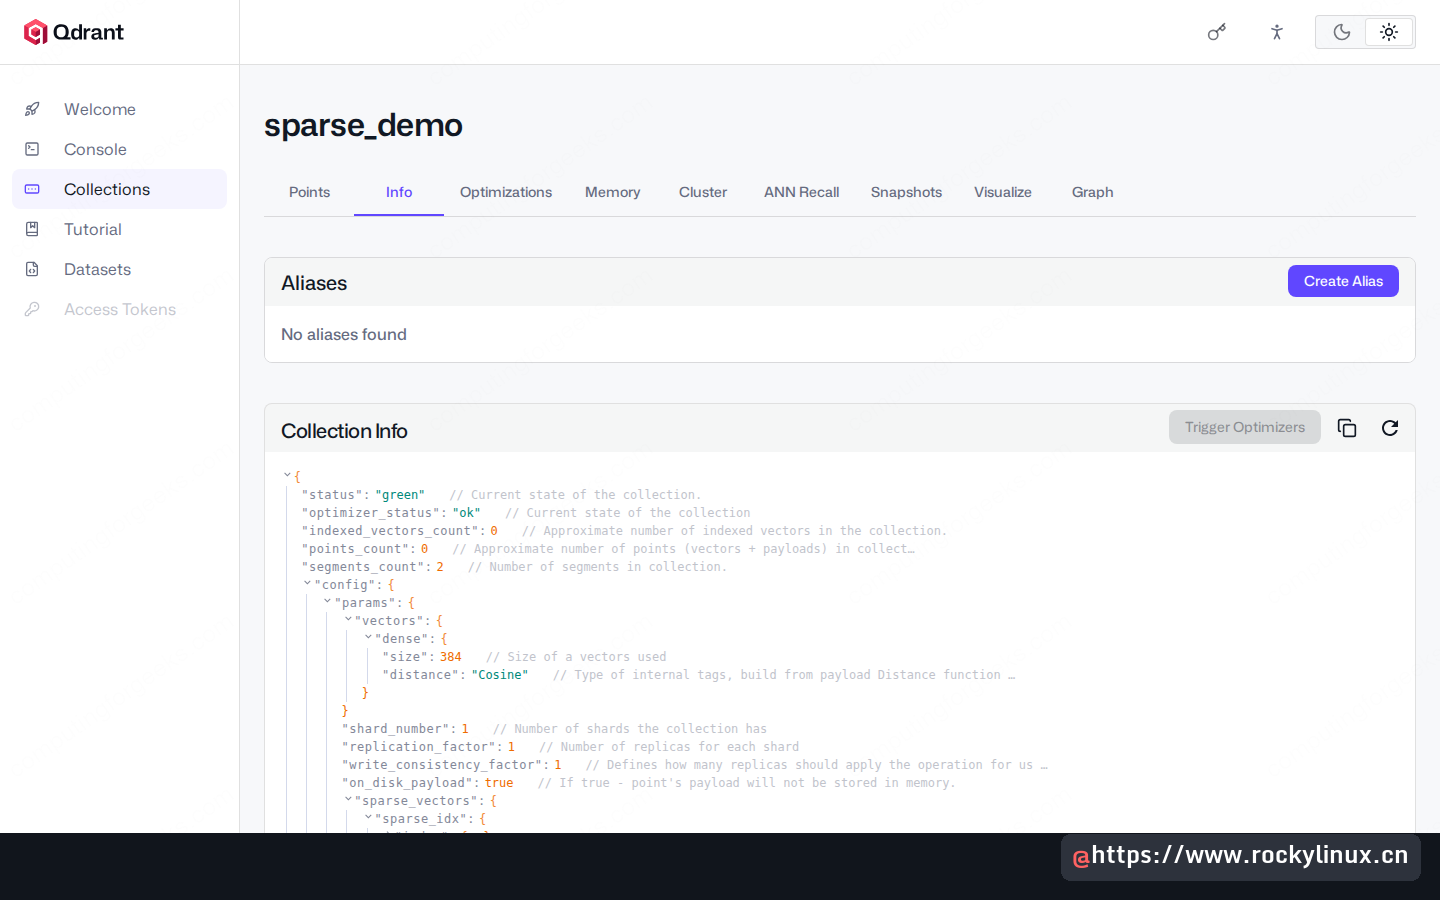
Info 会分别显示两个向量空间:
稀疏向量写入结构与稠密向量不同:
client.upsert(
    collection_name="sparse_demo",
    points=[
        models.PointStruct(
            id=1,
            vector={
                "dense": [0.1] * 384,
                "sparse_idx": models.SparseVector(
                    indices=[42, 1024, 5000],
                    values=[0.7, 0.3, 0.9],
                ),
            },
            payload={"title": "Rust vector database"},
        ),
    ],
)
常见生成器包括 SPLADE、FastEmbed 的 Qdrant/bm25,以及自定义 TF-IDF 流程。混合检索可通过 RRF(倒数排名融合)等方法合并稠密、稀疏结果,过滤篇会展示完整模式。
载荷结构与七类索引
载荷索引让查询规划器利用字段类型对应的索引结构,缩小需要检查的点范围,并配合向量搜索。未建索引的字段过滤可能需要扫描较多数据;建立索引通常可明显改善性能,但具体延迟取决于数据规模与选择性,不能将原文的亚毫秒描述视为保证。
为需要过滤的字段创建索引:
client.create_collection(
    collection_name="payload_indexed",
    vectors_config=models.VectorParams(size=64, distance=models.Distance.COSINE),
)

schemas = {
    "category":     models.PayloadSchemaType.KEYWORD,
    "view_count":   models.PayloadSchemaType.INTEGER,
    "rating":       models.PayloadSchemaType.FLOAT,
    "is_published": models.PayloadSchemaType.BOOL,
    "location":     models.PayloadSchemaType.GEO,
    "published_at": models.PayloadSchemaType.DATETIME,
}
for field, kind in schemas.items():
    client.create_payload_index(
        "payload_indexed", field_name=field, field_schema=kind,
    )

# Text index needs explicit tokenizer params
client.create_payload_index(
    "payload_indexed", field_name="body",
    field_schema=models.TextIndexParams(
        type="text",
        tokenizer=models.TokenizerType.WORD,
        min_token_len=2, max_token_len=20, lowercase=True,
    ),
)
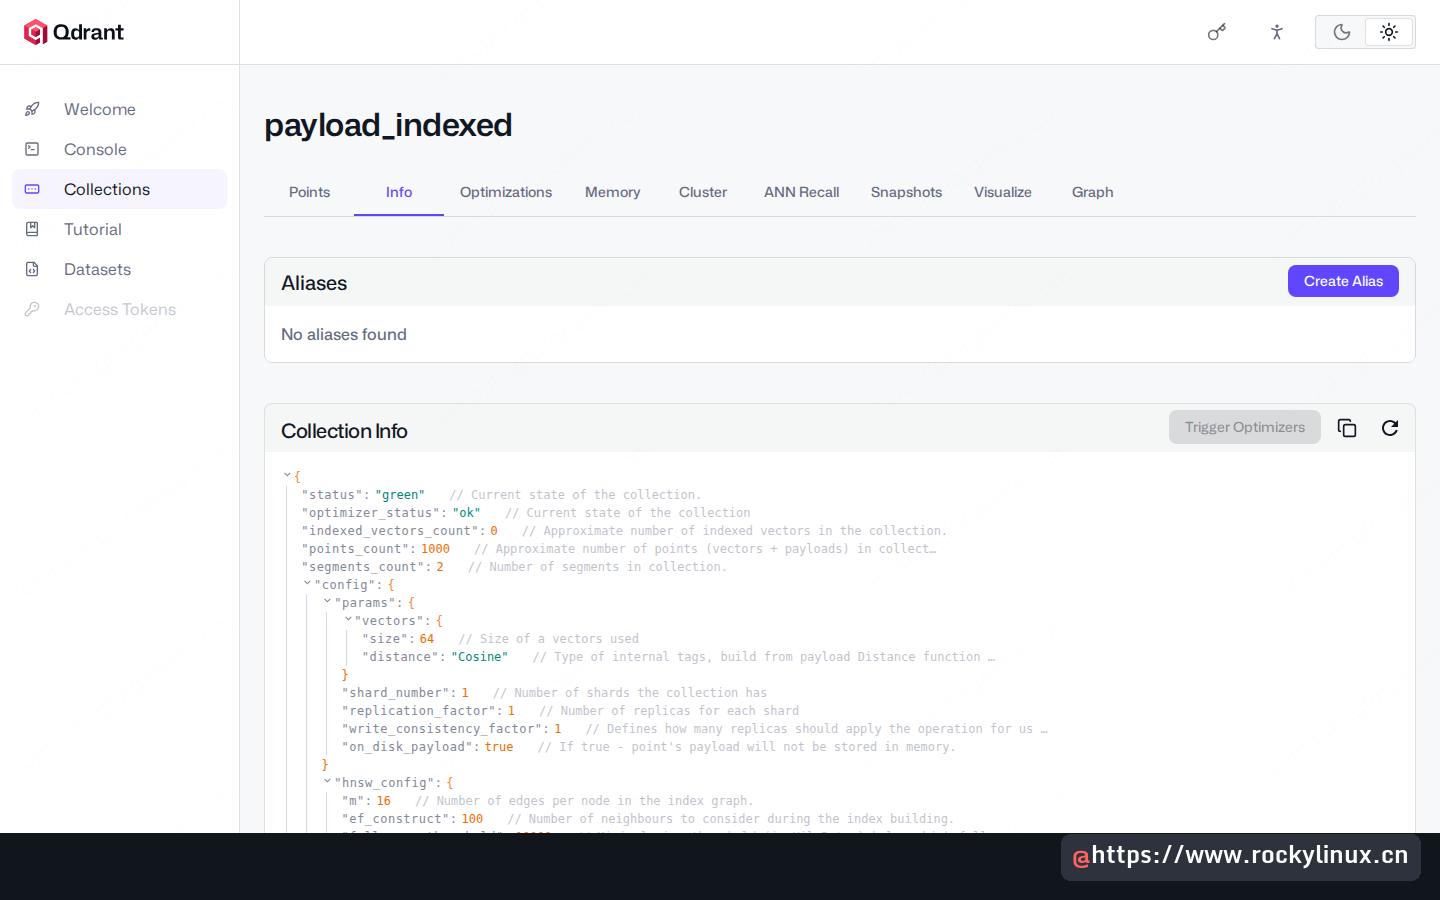
Info 会按声明类型显示索引,便于核对 SDK 写入的配置:
| 类型 | 用途 | 过滤方式 |
|---|---|---|
KEYWORD |
标签、SKU、国家代码等分类字符串 | 精确 match、any、except |
INTEGER |
计数、外部系统 ID | range、精确匹配 |
FLOAT |
分数、价格、小数权重 | range |
BOOL |
发布、归档等布尔开关 | 精确匹配 |
GEO |
经纬度,先经度后纬度 | geo_radius、geo_bounding_box、geo_polygon |
TEXT |
载荷字符串的全文检索 | 采用指定分词方式的 match_text |
DATETIME |
ISO 8601 时间戳 | 时间范围 range |
建立索引后,可用一千个点进行快速验证:
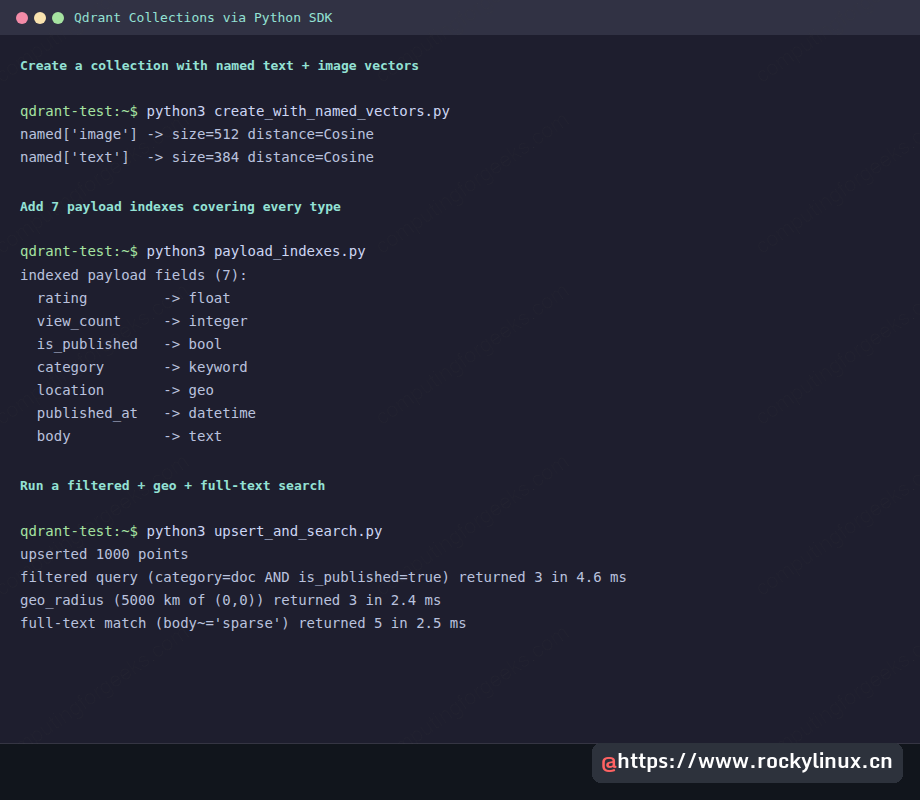
upserted 1000 points

filtered query (category=doc AND is_published=true) returned 3 in 4.6 ms
geo_radius (5000 km of (0,0)) returned 3 in 2.4 ms
full-text match (body~='sparse') returned 5 in 2.5 ms
小数据集可能掩盖扫描成本;到一千万点时,不合理的过滤与索引设计会明显影响查询。
将向量与载荷放到磁盘
默认内存策略提供较低搜索延迟,但也受物理内存限制。十亿条 1536 维 float32 向量,仅原始向量就约需 6.144 TB,另加 HNSW 和载荷开销。原文写为约 6 GB,这是数量级错误,此处已更正。
使用三个选项将对应层移到磁盘:
client.create_collection(
    collection_name="on_disk_collection",
    vectors_config=models.VectorParams(
        size=1536,
        distance=models.Distance.COSINE,
        on_disk=True,                       # vectors on disk (memory-mapped)
    ),
    on_disk_payload=True,                   # payload on disk
    hnsw_config=models.HnswConfigDiff(
        on_disk=True,                       # HNSW graph on disk
    ),
)
Info 可同时显示这些设置:
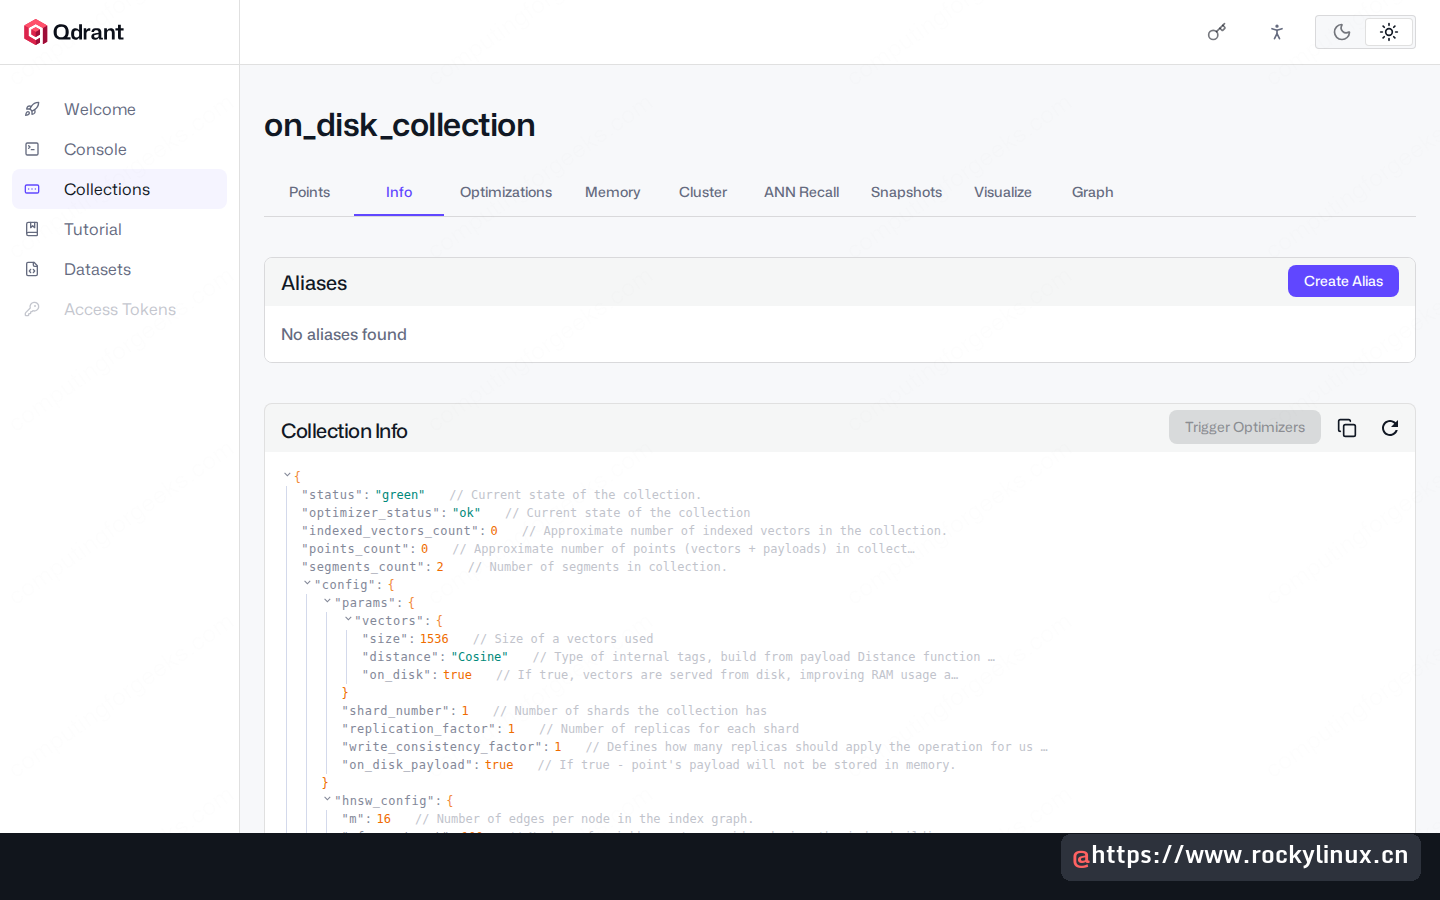
向量参数中的 on_disk=True 将原始向量置于内存映射文件,由操作系统页缓存按需读取;on_disk_payload=True 将载荷放到磁盘,适合 HTML、图像元数据、转录文本等较大字段;hnsw_config.on_disk=True 将 HNSW 图也放到磁盘。
这种方式以一定访问延迟换取容量。原文在 163,000 点、384 维 Prefix Cache 示例上观察到磁盘路径约慢 30%。是否能在 64 GB 主机容纳一亿点,还取决于维度、量化、索引、磁盘容量及工作集,不能仅由 on_disk 推导。
通过租户载荷索引支持多租户
为一千个小租户创建一千个集合,会重复承担 HNSW、段和优化器开销。可考虑共享集合,并建立具备租户语义的载荷索引。
client.create_collection(
    collection_name="tenants",
    vectors_config=models.VectorParams(
        size=384, distance=models.Distance.COSINE,
    ),
)

client.create_payload_index(
    "tenants", field_name="tenant_id",
    field_schema=models.KeywordIndexParams(
        type="keyword",
        is_tenant=True,        # the key flag
    ),
)
is_tenant=True 帮助按字段值组织数据,查询同时固定 tenant_id 时,可改善租户内访问局部性。这是存储优化,不能代替授权隔离。
每次搜索都应包含租户条件:
client.query_points(
    collection_name="tenants",
    query=[0.1] * 384,
    query_filter=models.Filter(
        must=[
            models.FieldCondition(
                key="tenant_id",
                match=models.MatchValue(value="acme-corp"),
            ),
        ],
    ),
    limit=10,
)
若没有过滤,查询仍可能覆盖所有租户。可以利用 JWT claims 固定租户约束,避免完全依赖应用逐次添加条件。
优化器配置:段、索引与内存映射
后台优化器负责合并段和建立 HNSW。大量写入、大集合或低内存主机可能需要调整:
client.create_collection(
    collection_name="tuned",
    vectors_config=models.VectorParams(size=384, distance=models.Distance.COSINE),
    optimizers_config=models.OptimizersConfigDiff(
        default_segment_number=4,
        indexing_threshold=20000,
        memmap_threshold=200000,
        max_optimization_threads=2,
    ),
)
在 Info 中确认配置:
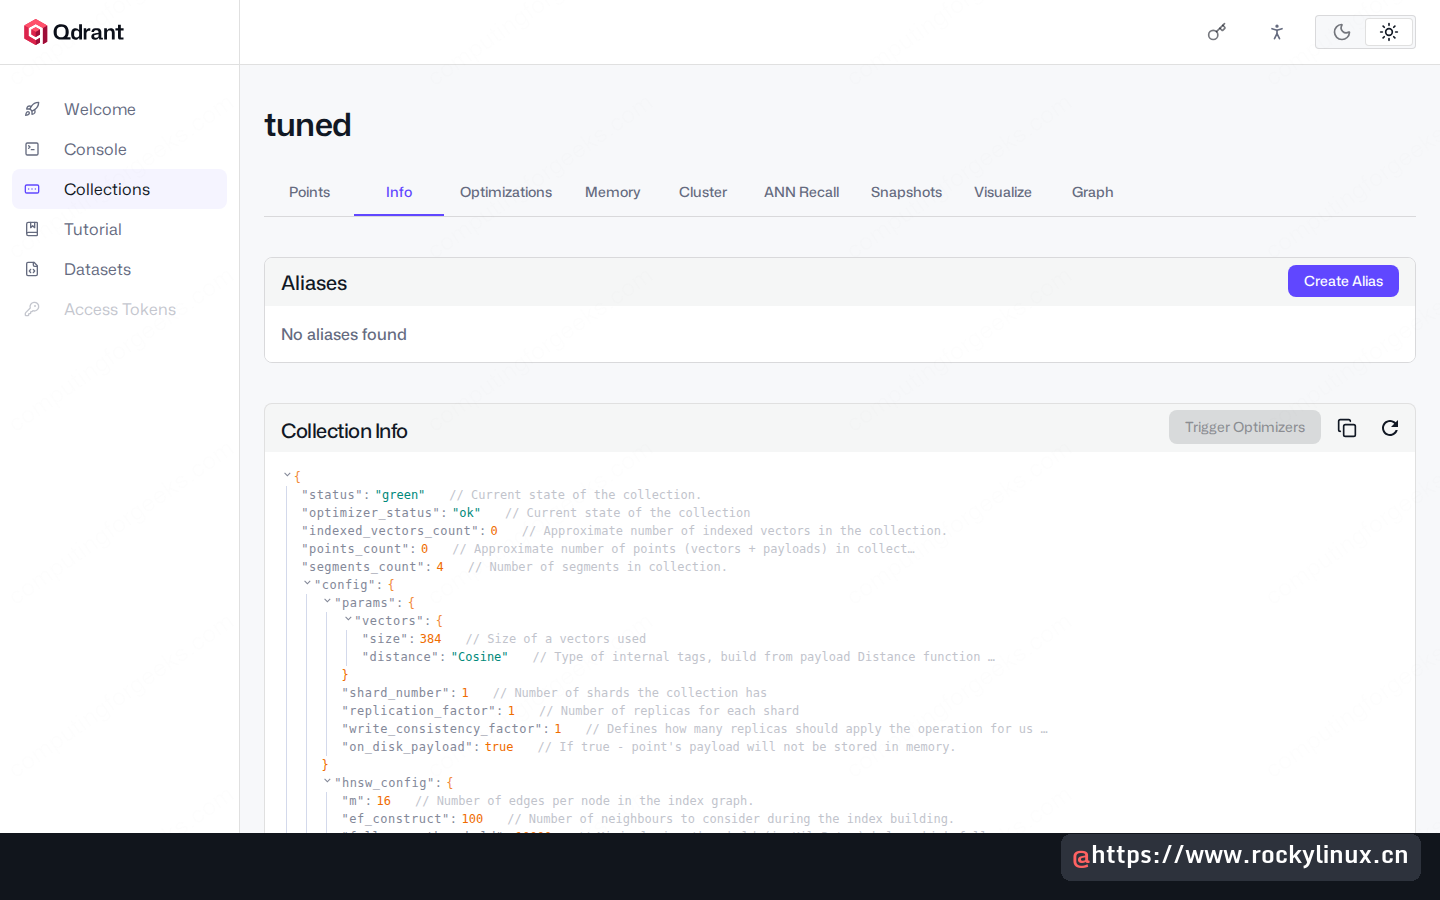
default_segment_number:优化器的目标段数量。写入负载可结合 CPU 并行度评估,低内存环境则需控制数量。indexing_threshold:超过阈值后建立向量索引。Qdrant 1.18.1 按向量数据的 KB 计算,不是点数;示例的 20000 是显式配置,并非该版本默认值。官方配置给出的默认值为 10000 KB。memmap_threshold:旧式内存映射阈值,同样按 KB。该参数从 1.15 起已弃用,应优先使用各层的on_disk设置;这里保留原文示例以便对应旧配置。max_optimization_threads:每个分片允许的并行优化作业数量。1.18.1 中null表示动态选择,0表示关闭优化,原文将 0 解释为自动选择,此处更正。
配置不合适通常表现为写入变慢、长时间黄色状态或搜索与优化争用资源。应先建立基准,再调整并验证。
WAL 容量与预分配
WAL 是持久性机制,upsert 和删除先记录日志,再由段处理与落盘。两个参数控制其行为:
client.create_collection(
    collection_name="wal_tuned",
    vectors_config=models.VectorParams(size=384, distance=models.Distance.COSINE),
    wal_config=models.WalConfigDiff(
        wal_capacity_mb=64,
        wal_segments_ahead=2,
    ),
)
wal_capacity_mb 是单个 WAL 段大小,大载荷突发写入可评估增大,小主机可减小;wal_segments_ahead 指定提前创建的空日志段数。示例使用 2,持续写入时也可测试 4 或 8,以减少分配抖动。Qdrant 1.18.1 官方配置的默认值为 0,原文将 2 写作默认值,此处更正。
日志位于 {storage_dir}/collections/{name}/wal。必要时可规划独立存储以隔离日志写入与搜索读取 IOPS,但应结合性能测试验证。
原地更新集合
许多设置无需重建集合,可通过 update_collection 的差异配置更新:
client.update_collection(
    collection_name="basic_docs",
    hnsw_config=models.HnswConfigDiff(m=32, ef_construct=256),
    optimizers_config=models.OptimizersConfigDiff(indexing_threshold=10000),
)
现有点保留,后台逐步按新参数重建相关索引。示例在 basic_docs 上执行后的输出为:
after update: hnsw.m=32  ef_construct=256
indexing_threshold=10000已有向量的维度、距离度量或稠密/稀疏类型改变,通常需要新向量空间或新集合并重新写入。Qdrant 自 1.18.0 起支持在已有集合中添加、删除命名向量定义,因此不能把“命名向量集合不可修改”当成该版本的限制。
用别名原子切换集合
在旧集合旁构建新集合并写入数据,然后原子调整别名。应用始终使用同一别名,避免切换时出现未指向任何集合的中间状态。
# Two real collections, one with 384-dim vectors, one with 768-dim
client.create_collection("docs_v1", models.VectorParams(size=384, distance=models.Distance.COSINE))
client.create_collection("docs_v2", models.VectorParams(size=768, distance=models.Distance.COSINE))

# Application code reads from "docs_live"
client.update_collection_aliases([
    models.CreateAliasOperation(create_alias=models.CreateAlias(
        collection_name="docs_v1",
        alias_name="docs_live",
    )),
])
应用通过 docs_live 访问 docs_v1。使用新模型将数据写入 docs_v2 后,通过单次原子操作切换:
client.update_collection_aliases([
    models.DeleteAliasOperation(delete_alias=models.DeleteAlias(
        alias_name="docs_live")),
    models.CreateAliasOperation(create_alias=models.CreateAlias(
        collection_name="docs_v2",
        alias_name="docs_live",
    )),
])
两个操作在同一调用中执行。通过 get_aliases 验证:
after swap   -> all aliases:
  alias=docs_live  -> collection=docs_v2
确认新集合稳定服务后再删除 docs_v1。此模式适合模型升级、维度变化及不能原地完成的迁移。
集中核对配置
运行全部示例后,Web UI 中会出现对应的测试集合:
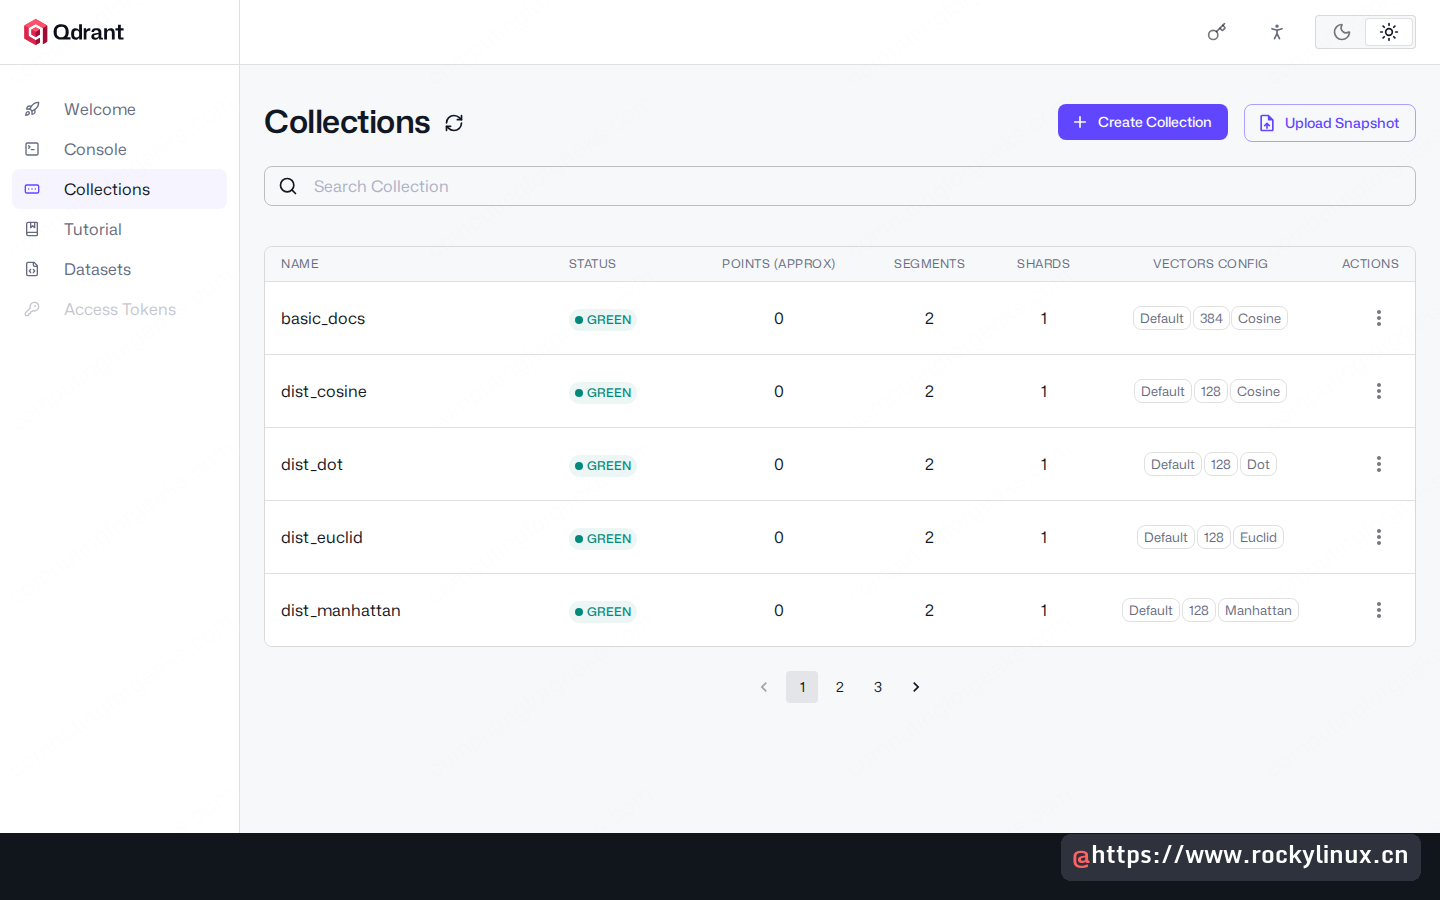
点击集合并打开 Info,可以检查 Python SDK 设置的各项参数。将脚本输出与面板并排比较,便于核对:
绿色状态表示集合健康、可查询;是否满足预期持久性还应结合存储、WAL、写入确认与备份策略判断。
容易忽略的问题
维度与距离度量不能随意修改。 已建的 384 维余弦空间不能直接变成 768 维欧氏空间。可预先规划新空间或新集合及别名切换。
地理坐标先经度后纬度。 与一些地图 API 的习惯相反;写反会把点放到错误位置,使地理过滤返回空结果。
文本字段不会自动获得全文索引。 需要显式创建 TextIndexParams,并选择 WORD、WHITESPACE、PREFIX、MULTILINGUAL 等分词方式。分词器是索引配置,修改时需重建相关索引;无索引时的匹配行为与性能应按实际版本核对。
别名不是独立集合,但可以用于集合请求。 get_collections 列出真实集合,get_aliases 或 get_collection_aliases 查看映射。官方说明集合查询可使用别名,因此原文“不能用 get_collection(alias_name)”的绝对说法不准确,此处更正。
优化阈值按段计算,且不是简单点数。 集合总点数很大,不代表每个段都达到建索引阈值。应结合单段向量数据量和 Info 中的 indexed_vectors_count 判断。
按症状选择参数
| 症状 | 优先考虑 |
|---|---|
| 过滤搜索慢 | 为过滤字段创建类型匹配的载荷索引 |
| 内存不足、目标数据量很大 | 向量 on_disk=True、on_disk_payload=True、HNSW on_disk=True,再核算磁盘与工作集 |
| 上千租户的 SaaS | 共享集合,配合 tenant_id 的 KeywordIndexParams(is_tenant=True) 及访问控制 |
| 同时需要语义与关键词召回 | 同一集合中的命名稠密向量与稀疏向量 |
| 写入停滞、长期黄色 | 检查优化器积压、阈值和并行度,基于测量调整 |
| 升级嵌入模型 | 并行构建 v2,校验后原子切换别名 |
| 不同用途采用不同度量 | 使用独立向量空间;单个命名向量空间的度量保持一致 |
这些模式覆盖集合创建、配置、字段索引、磁盘存储、租户组织、优化及模型迁移。本系列 API 篇将进一步展示对应的 REST 与 gRPC 调用。