在 Rocky Linux 10 上,一条 curl 命令就能安装 K3s,节点甚至会显示 Ready。但在精简版 Rocky 镜像上,这层“就绪”背后往往仍有一个无法正常工作的集群:缺少 kernel-modules-extra 时不会有 br_netfilter,CoreDNS 四分钟后仍未就绪;如果 firewalld 保持开启却未放行端口,agent 也无法加入。SELinux 大部分配置会由安装器自动处理,因为安装器会拉取 k3s-selinux。
本文将按照真实服务器的部署方式构建一个两节点集群,保持 SELinux 为 enforcing、firewalld 启用,并通过先制造故障再修复的方式验证每个 Rocky Linux 特有步骤。所有命令均于 2026 年 11 月在两台 Proxmox 虚拟机上、以 Rocky Linux 10.2 和 stable 通道的 K3s v1.36.5+k3s1 实测。
规划 Rocky Linux 上的 K3s 集群
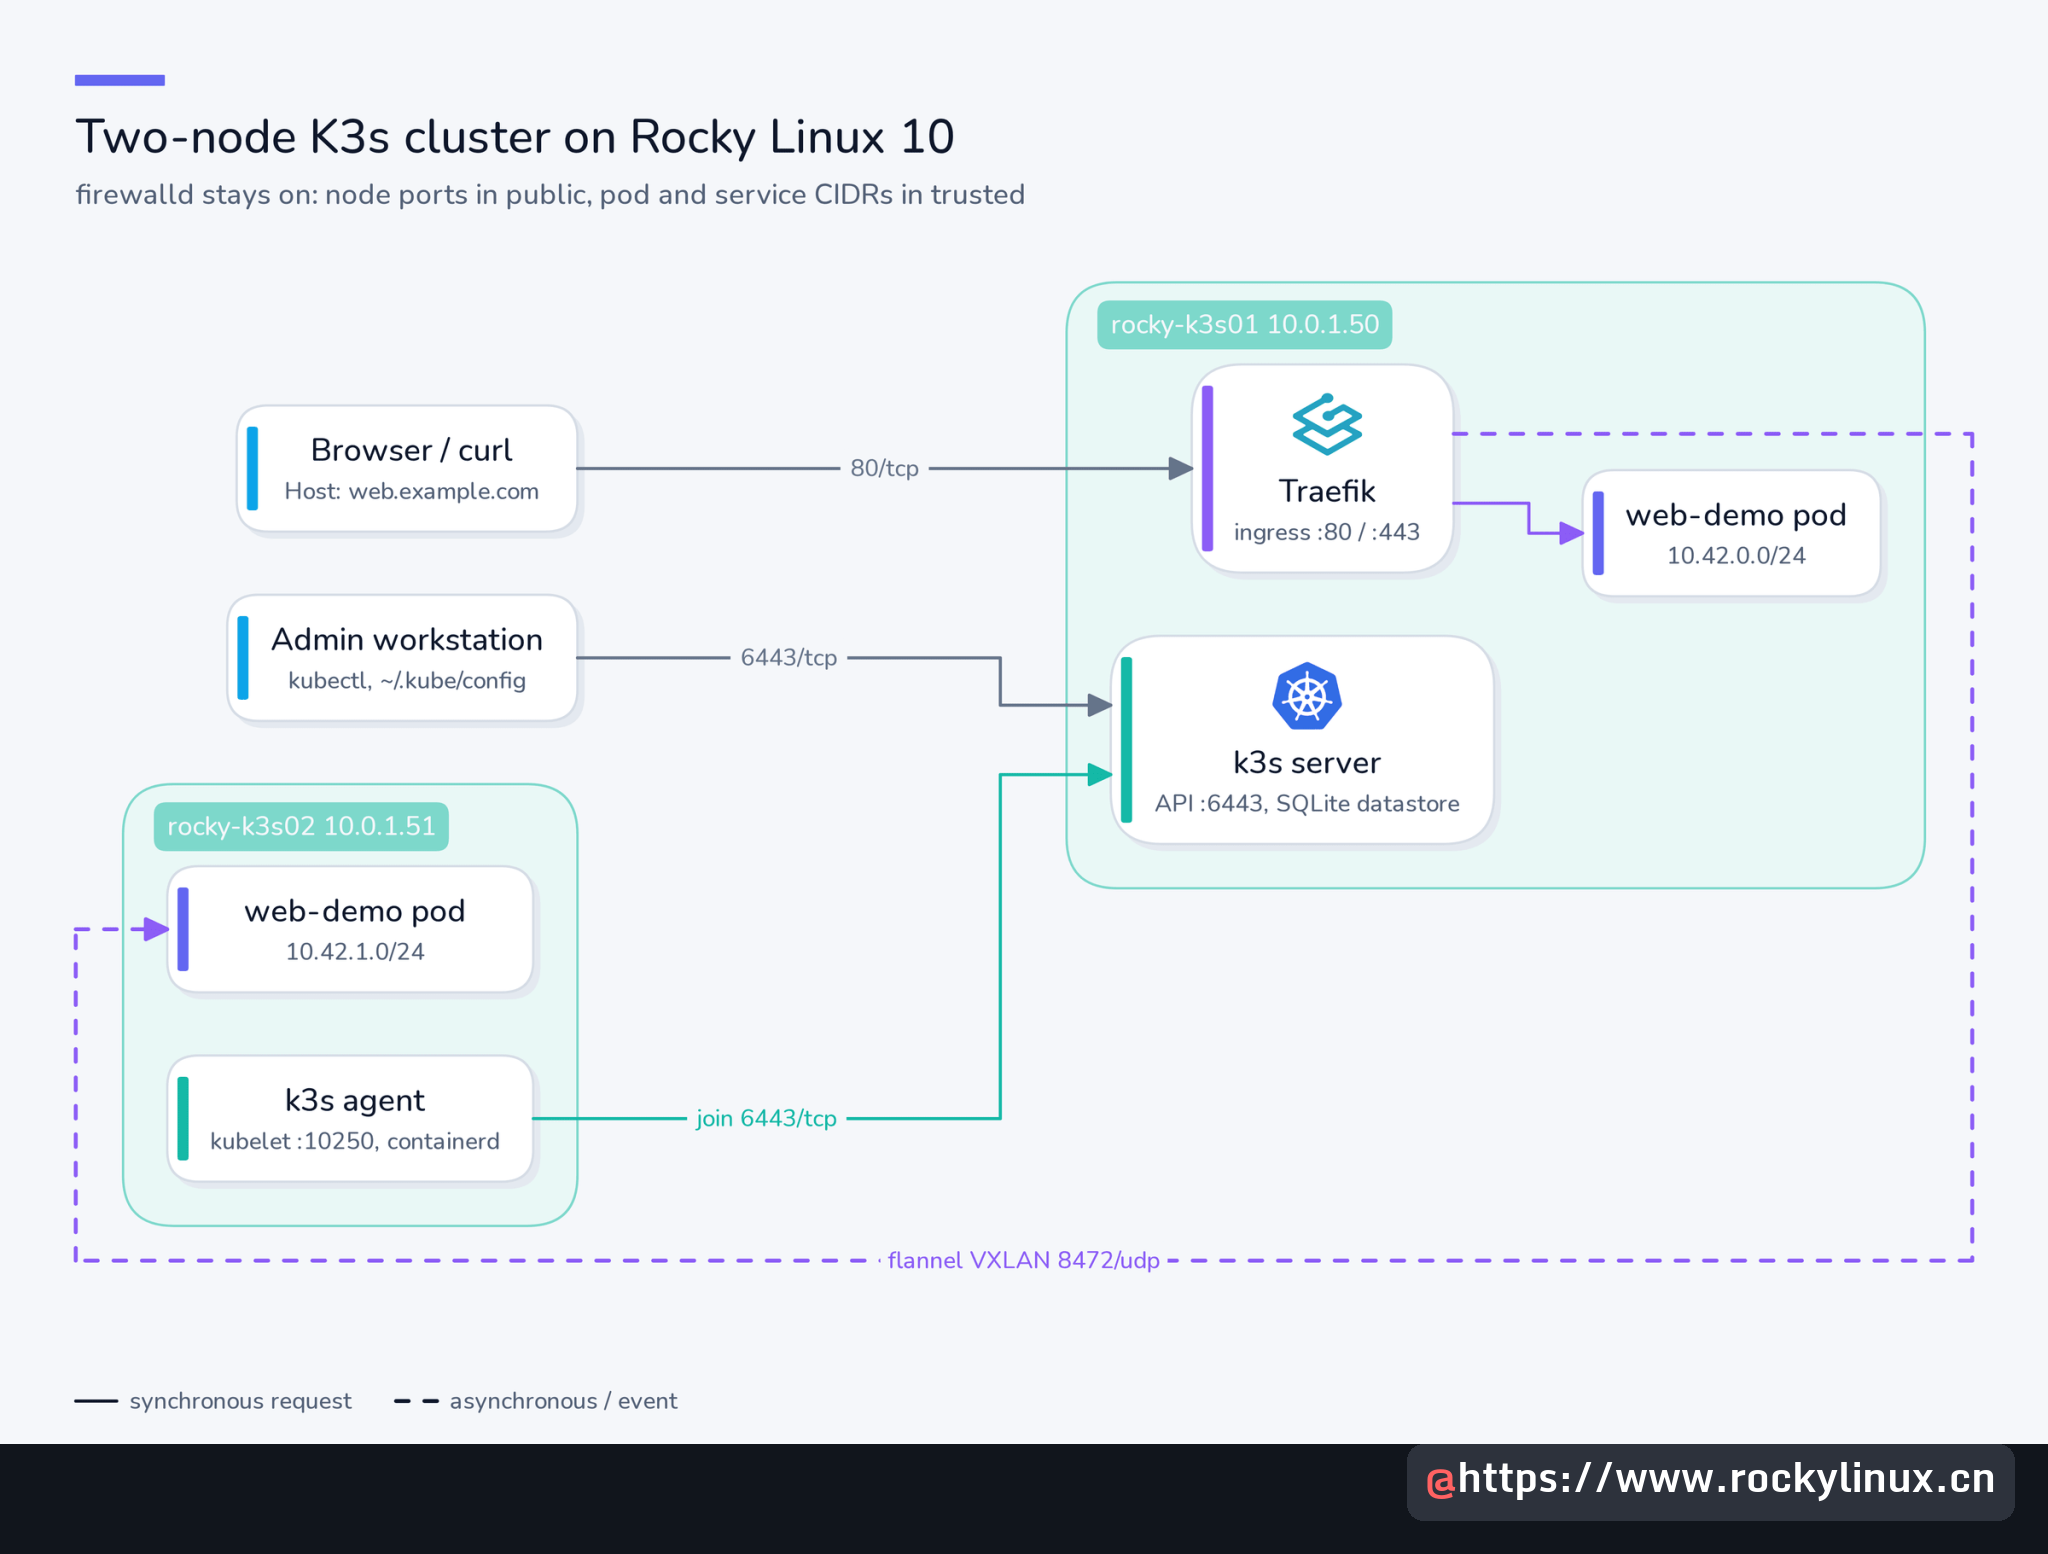
K3s server 在单个进程中运行 API server、调度器、控制器管理器和数据存储;除非主动设置污点,它也会承载工作负载。agent 主动与 server 建立并保持出站连接,不同节点上的 Pod 通过 flannel 的 VXLAN 覆盖网络通信,metrics-server 则直接抓取每个 kubelet。因此 firewalld 必须放行以下流量:
- server 上的
6443/tcp:API 服务与 agent 加入; - 节点之间的
8472/udp:flannel VXLAN; - 节点之间的
10250/tcp:kubelet 指标; 80/tcp与443/tcp:内置 Traefik Ingress。
下图展示这些组件在两台实验节点上的关系,以及通过 Traefik 进入的流量如何被转发到任意节点上的 Pod。
实验使用同一子网内的两台 Rocky Linux 10.2 虚拟机,并已完成 Rocky Linux 10 的常规安装后配置。实际部署时请替换为你的主机名和地址。
rocky-k3s01,10.0.1.50:server,2 vCPU、4 GB 内存;rocky-k3s02,10.0.1.51:agent,2 vCPU、2 GB 内存;- 两台主机均启用 SELinux enforcing、firewalld,并具有可执行 sudo 的用户。
K3s 官方最低要求为 server 2 核 2 GB、agent 1 核 512 MB,但应把它视为实验环境下限。运行 Traefik、CoreDNS、metrics-server 和两个 nginx Pod 时,实验 server 进程常驻内存约 897 MB,整机使用约 1,571 MB;agent 整机使用约 498 MB。生产工作负载建议从 2 vCPU、4 GB 的 server 起步,K3s 的容量指南将该配置标为最多支持 350 个 agent;agent 规模则取决于你将调度到其上的工作负载。
在每台节点安装 kernel-modules-extra
在 RHEL 10 上,K3s 文档额外要求安装 kernel-modules-extra。它看起来像可选组件,而且即使缺失,K3s 也不会拒绝启动,这正是最容易漏掉它的原因。在 Rocky 10 上,这个包提供 kube-proxy 和 flannel 写入规则所需的 netfilter 模块,而实验所用的云镜像一个都没有:
br_netfilter;iptable_nat和iptable_filter;xt_comment、xt_conntrack、xt_MASQUERADE。
先更新系统。该包会为已安装的最新内核提供模块,而不一定是当前正在运行的内核;如果内核升级已经暂存但尚未重启,模块就会与 uname -r 不匹配。实验克隆机启动的是 6.12.0-211.16.1,但首次启动时的升级已暂存 211.72.1,因此必须先重启。
sudo dnf -y upgrade
sudo dnf -y install kernel-modules-extra
sudo systemctl reboot
节点恢复后,确认包版本与运行内核一致。两条输出中的构建字符串必须相同。
uname -r; rpm -q kernel-modules-extra实验 server 重启后,两者一致:
6.12.0-211.72.1.el10_2.x86_64
kernel-modules-extra-6.12.0-211.72.1.el10_2.x86_64
如果要查看 K3s 加载的模块由哪个包提供,可以对每个模块运行 modinfo 查找文件,再用 rpm 查询归属:
for m in xt_comment xt_conntrack xt_MASQUERADE br_netfilter iptable_nat; do echo "$m -> $(rpm -qf $(modinfo -n $m))"; done它们全部来自 kernel-modules-extra,而不是基础内核包:
xt_comment -> kernel-modules-extra-6.12.0-211.72.1.el10_2.x86_64
xt_conntrack -> kernel-modules-extra-6.12.0-211.72.1.el10_2.x86_64
xt_MASQUERADE -> kernel-modules-extra-6.12.0-211.72.1.el10_2.x86_64
br_netfilter -> kernel-modules-extra-6.12.0-211.72.1.el10_2.x86_64
iptable_nat -> kernel-modules-extra-6.12.0-211.72.1.el10_2.x86_64
实验中还有一个意外现象:在裸云镜像上安装 firewalld 时,iptables-nft 和 ipset 会以弱依赖方式顺带拉入 kernel-modules-extra。因此已安装 firewalld 的主机可能碰巧具备这些模块,但不要依赖这种结果;设置 install_weak_deps=False 或使用精简 kickstart 时,它们不会被安装。两台节点都应明确按包名安装。
错误:“Module br_netfilter not found in directory /lib/modules”
为了展示跳过该包的代价,我们从 server 移除了它,然后照常安装 K3s。服务仍然启动,节点也显示 Ready,但日志中充满模块和 iptables 故障。四分钟后,CoreDNS 为 0/1,local-path-provisioner 处于 Error,metrics-server 因就绪探针失败而反复崩溃:
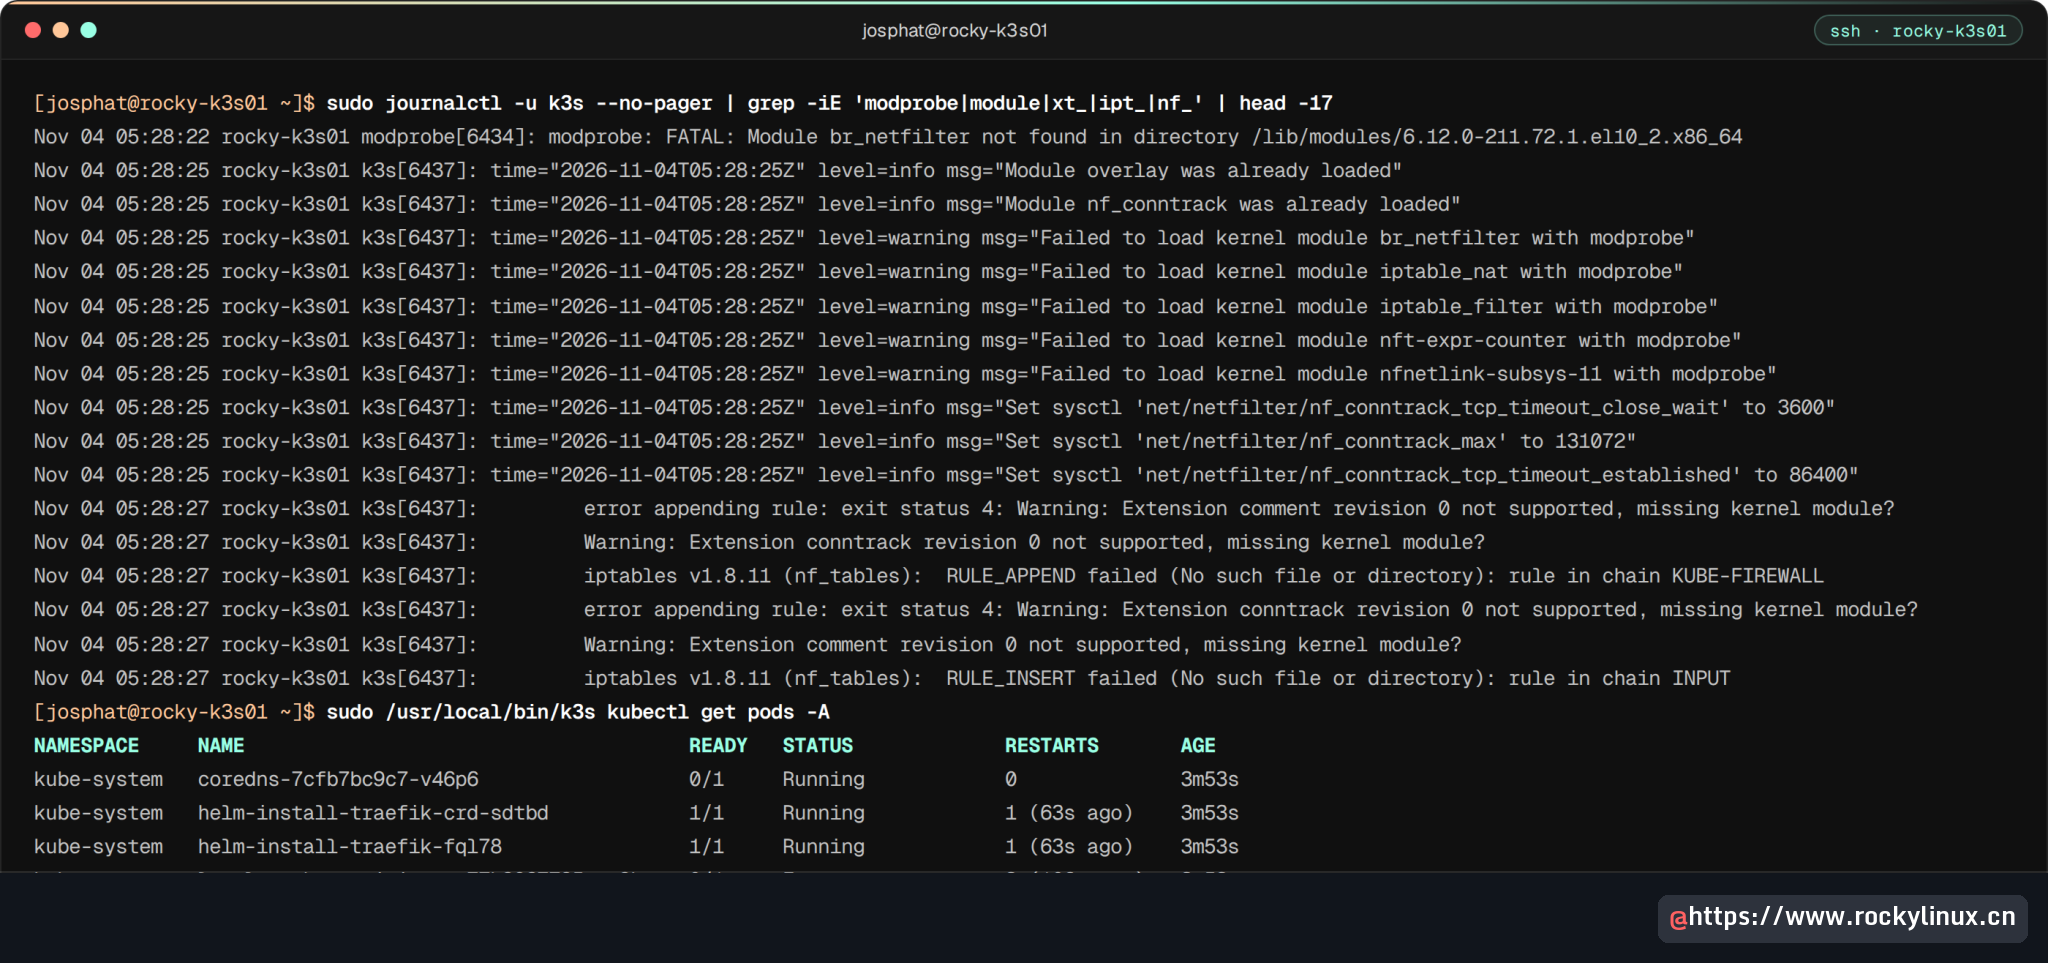
重点观察 Extension conntrack revision 0 not supported, missing kernel module? 以及紧随其后的 Failed to bootstrap IPTables。如果显示 Ready 的节点持续记录这些信息,它并不是可用节点。安装 kernel-modules-extra,确认版本与运行内核匹配,然后运行 sudo systemctl restart k3s。修复后日志中出现 Module br_netfilter was already loaded,iptables 错误消失,三个系统 Pod 无需其他操作便恢复健康。
修复后仍会保留一条警告:Failed to load kernel module nft-expr-counter with modprobe。该内核中 modinfo 找不到 nft_counter 模块,但规则仍能正常应用,因此可以忽略。
为 K3s 配置 firewalld
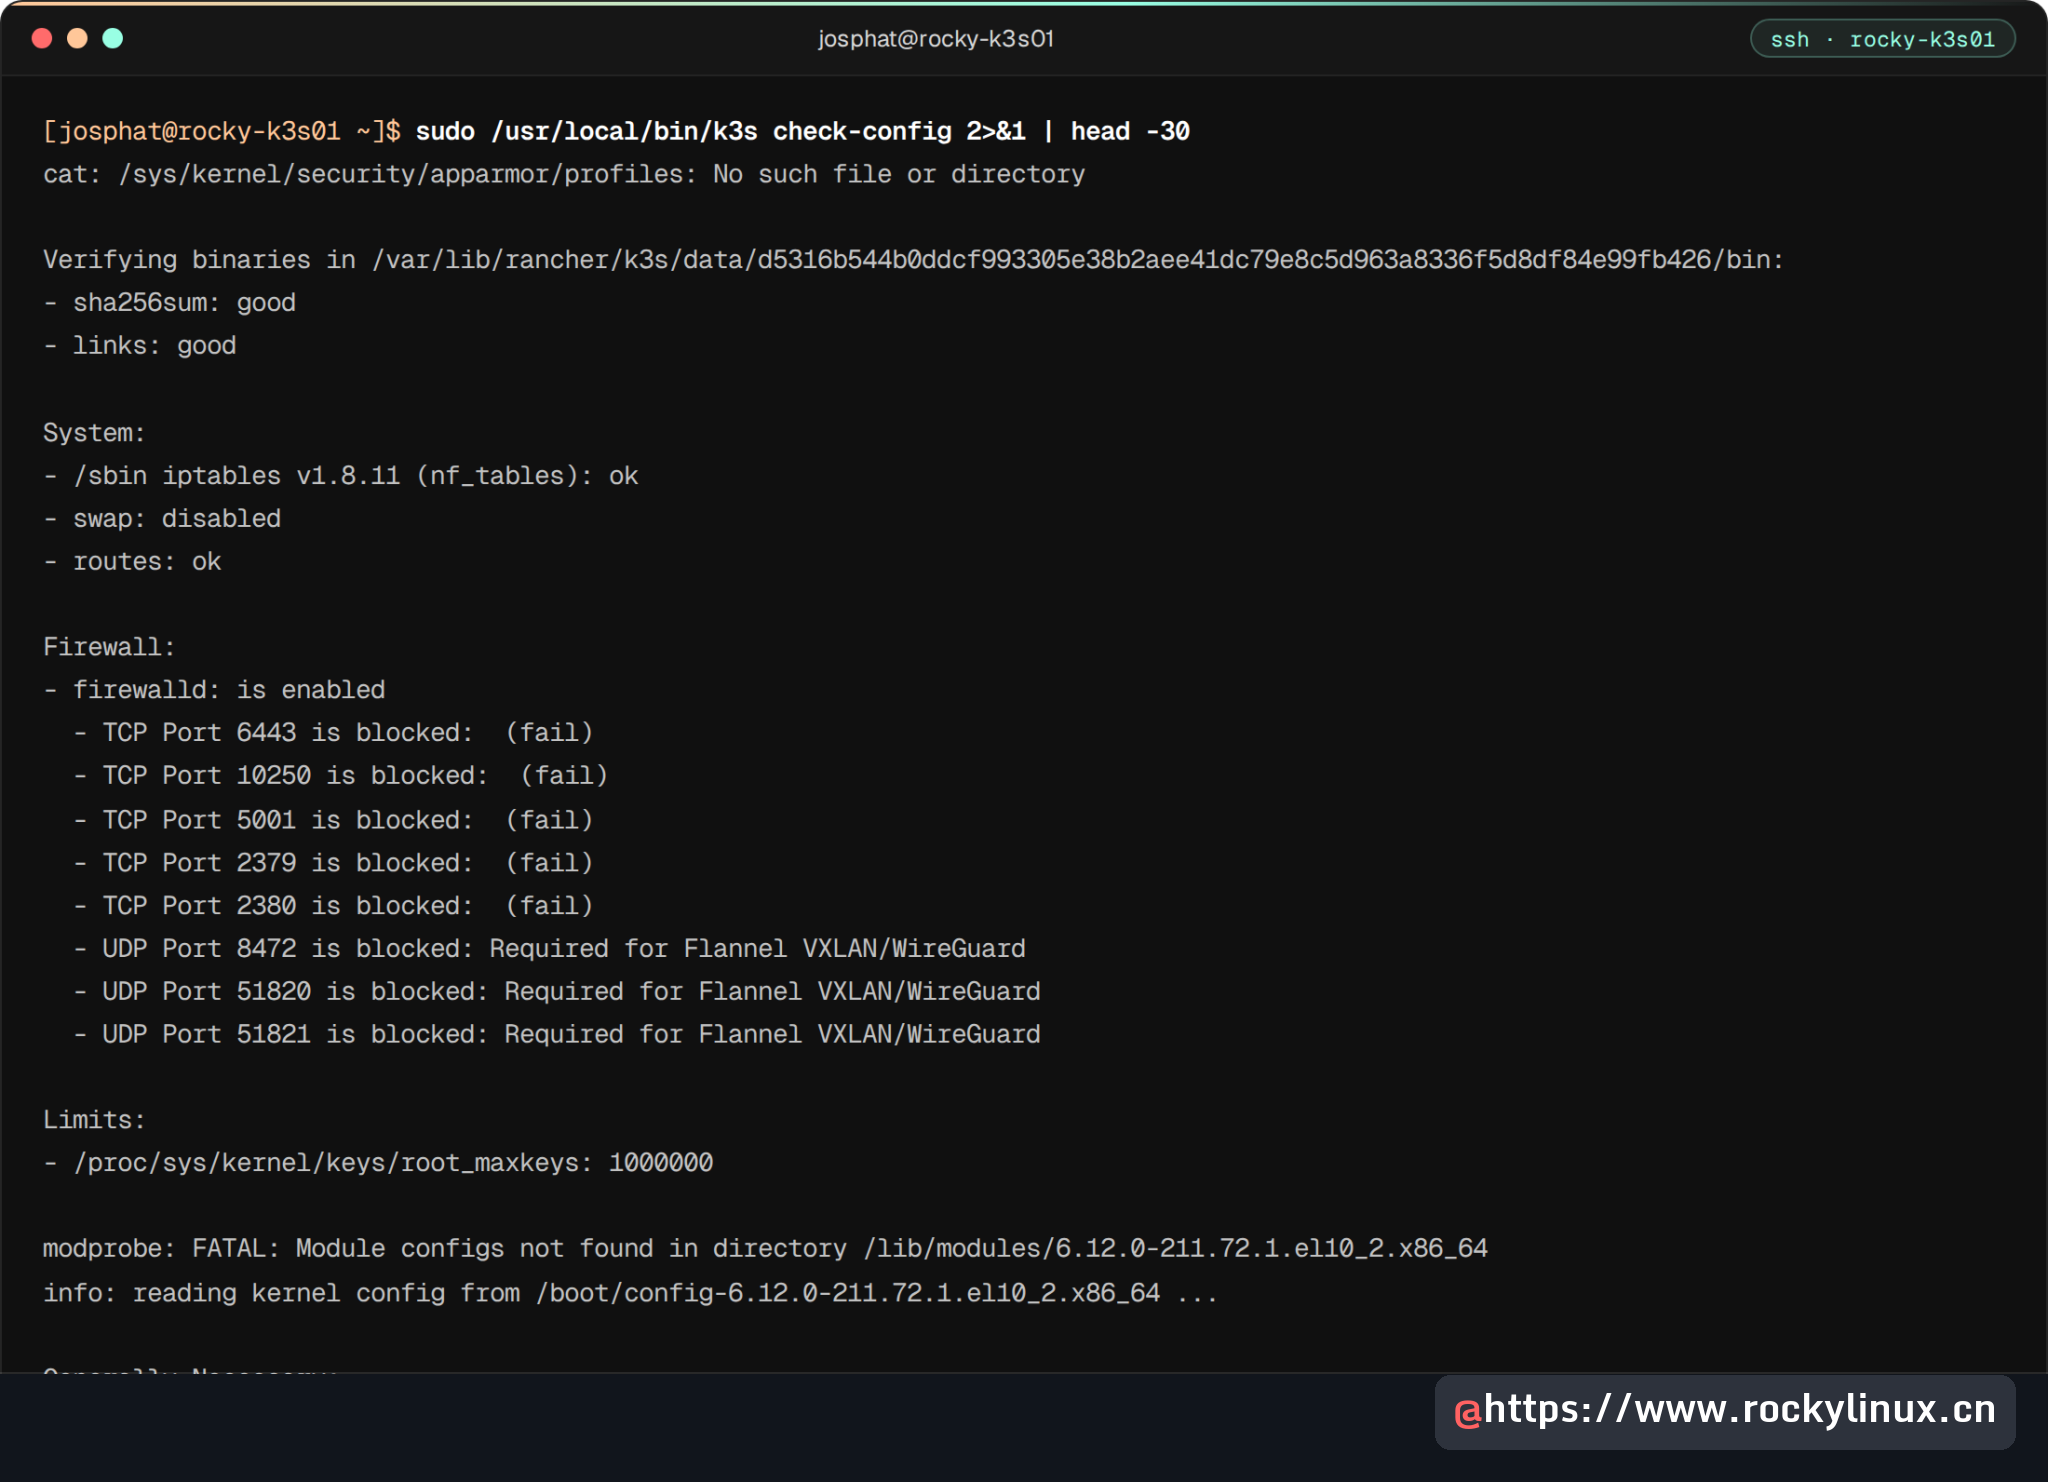
K3s 文档建议关闭 firewalld。若 Rocky server 不只连接实验交换机,应保持 firewalld 开启并通过规则放行。默认 public zone 只允许 ssh、cockpit 和 dhcpv6-client。K3s 自带 k3s check-config 检查器;在未添加任何规则时,它的 Firewall 部分会列出 K3s 可能使用的所有端口,并将它们全部标记为阻塞。安装 K3s 后可运行 sudo /usr/local/bin/k3s check-config 复核。
本集群需要 6443、10250 和 8472。5001 仅用于内置 Spegel registry,2379 和 2380 仅用于内置 etcd 高可用,51820/51821 仅用于 WireGuard flannel 后端。
在 server 上放行 API、kubelet、VXLAN 及 Traefik 的 Web 流量。后两条规则把 Pod CIDR(10.42.0.0/16)和 Service CIDR(10.43.0.0/16)加入 trusted zone,因为 Pod 流量到达宿主机时会携带这些源地址,否则 firewalld 会拒绝:
sudo firewall-cmd --permanent --add-port=6443/tcp
sudo firewall-cmd --permanent --add-port=10250/tcp
sudo firewall-cmd --permanent --add-port=8472/udp
sudo firewall-cmd --permanent --add-service=http --add-service=https
sudo firewall-cmd --permanent --zone=trusted --add-source=10.42.0.0/16
sudo firewall-cmd --permanent --zone=trusted --add-source=10.43.0.0/16
sudo firewall-cmd --reload
agent 不需放行 6443,因为没有任何客户端连接 agent 的 API 端口,其余规则相同。
sudo firewall-cmd --permanent --add-port=10250/tcp
sudo firewall-cmd --permanent --add-port=8472/udp
sudo firewall-cmd --permanent --add-service=http --add-service=https
sudo firewall-cmd --permanent --zone=trusted --add-source=10.42.0.0/16
sudo firewall-cmd --permanent --zone=trusted --add-source=10.43.0.0/16
sudo firewall-cmd --reload
用 sudo firewall-cmd --list-all 和 sudo firewall-cmd --zone=trusted --list-all 检查两个 zone。server 的 public zone 应包含三个端口和两个服务,trusted zone 应包含两个 CIDR 源:
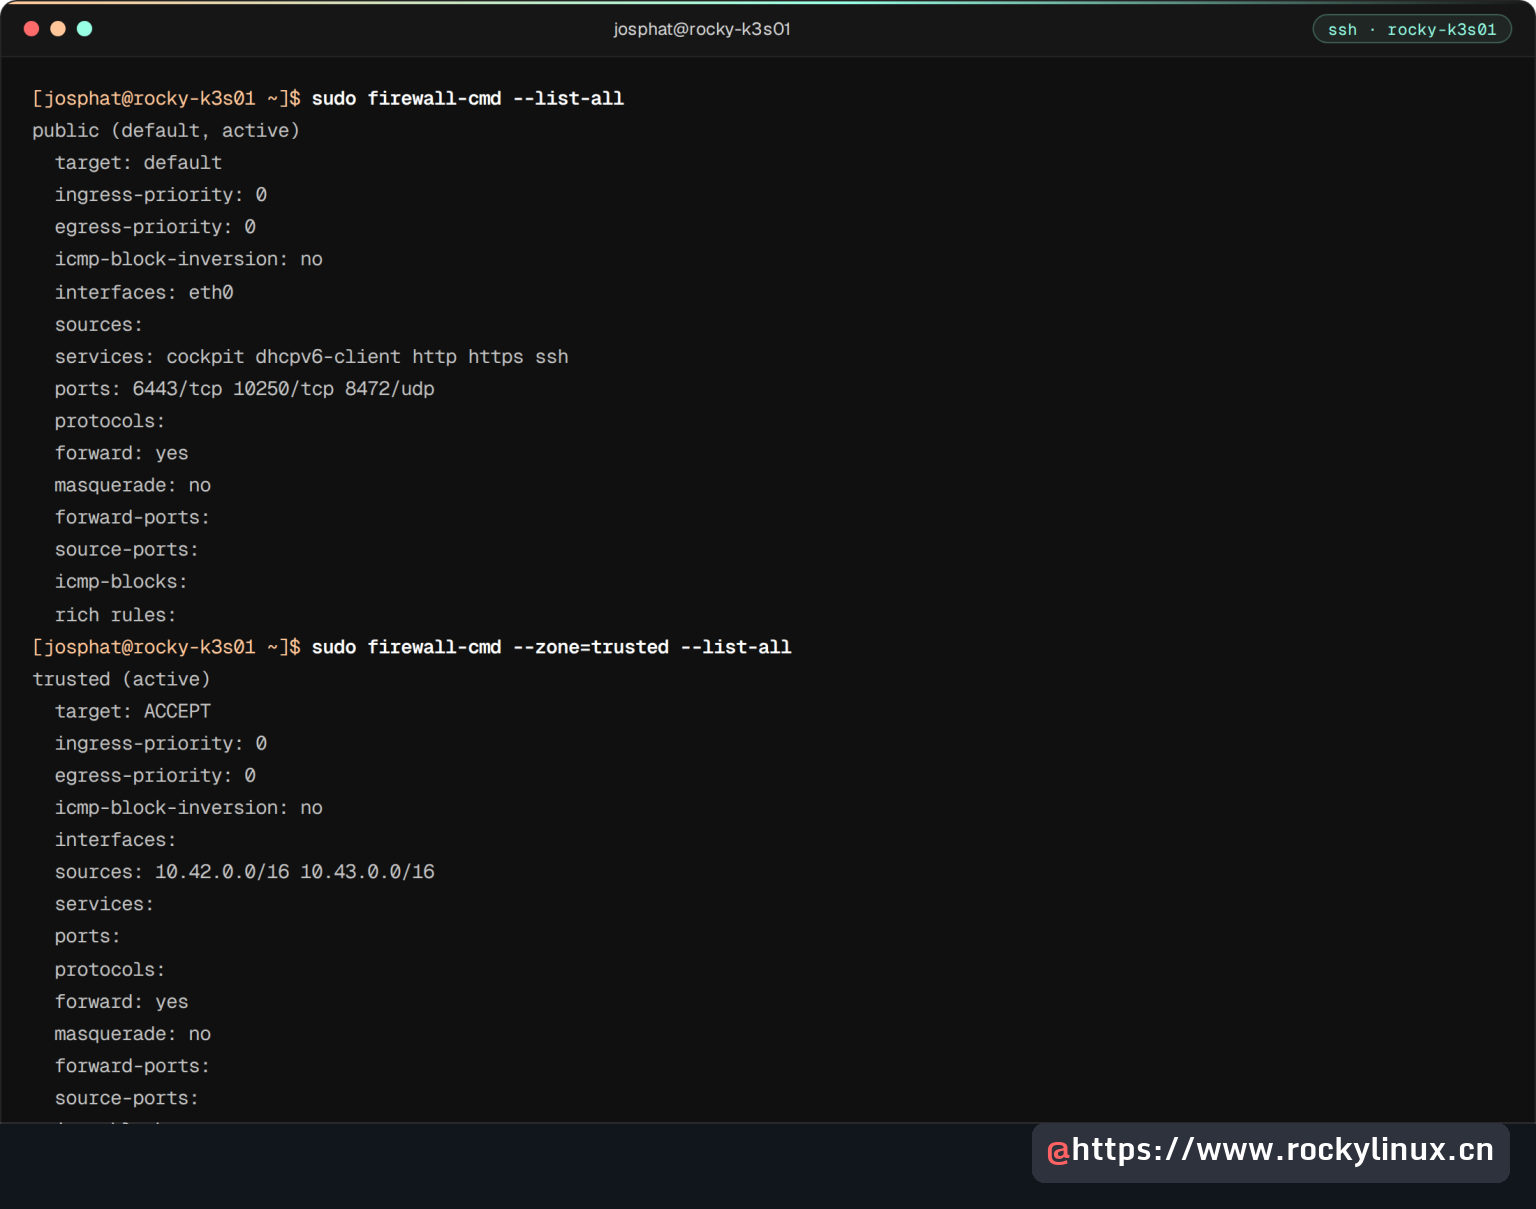
8472 上的 VXLAN 传输未加密的 Pod 流量,因此只应允许其他节点访问。在扁平实验网络中,public zone 规则可以接受;在共享网络中,应使用 rich rule 或绑定集群网段的专用 zone 限制源地址。修改 cluster-cidr 或 service-cidr 后,也要同步修改 trusted 源。
在 SELinux enforcing 模式下安装 K3s server
保持 SELinux 为 enforcing。K3s 安装器会在 Rocky 上识别 SELinux,添加 Rancher rancher-k3s-common-stable 仓库,并在启动服务前从 AppStream 安装 k3s-selinux 和 container-selinux。但它不会通知 containerd 给容器打标签;这需要在 K3s 配置中设置 selinux: true,因此应在运行安装器前先写配置:
sudo mkdir -p /etc/rancher/k3s
sudo vim /etc/rancher/k3s/config.yaml加入以下配置。tls-san 会给 API server 证书添加额外名称;节点自身 IP 已在证书中,因此这里真正重要的是主机名,也可用同样方式加入 DNS 名或 VIP。node-ip 则固定多网卡主机上 flannel 与 kubelet 使用的地址:
write-kubeconfig-mode: "0600"
selinux: true
tls-san:
  - rocky-k3s01
  - 10.0.1.50
node-ip: 10.0.1.50
现在通过 stable 通道运行安装器。显式设置 INSTALL_K3S_CHANNEL=stable,可确保安装 K3s 标记为稳定的版本,而不是当天 latest 指向的版本:
curl -sfL https://get.k3s.io | INSTALL_K3S_CHANNEL=stable sh -安装过程中可以看到 stable 通道解析到当前版本、导入 Rancher 仓库 GPG 密钥,并在写入二进制和 systemd unit 前由 dnf 安装两个 SELinux 包。
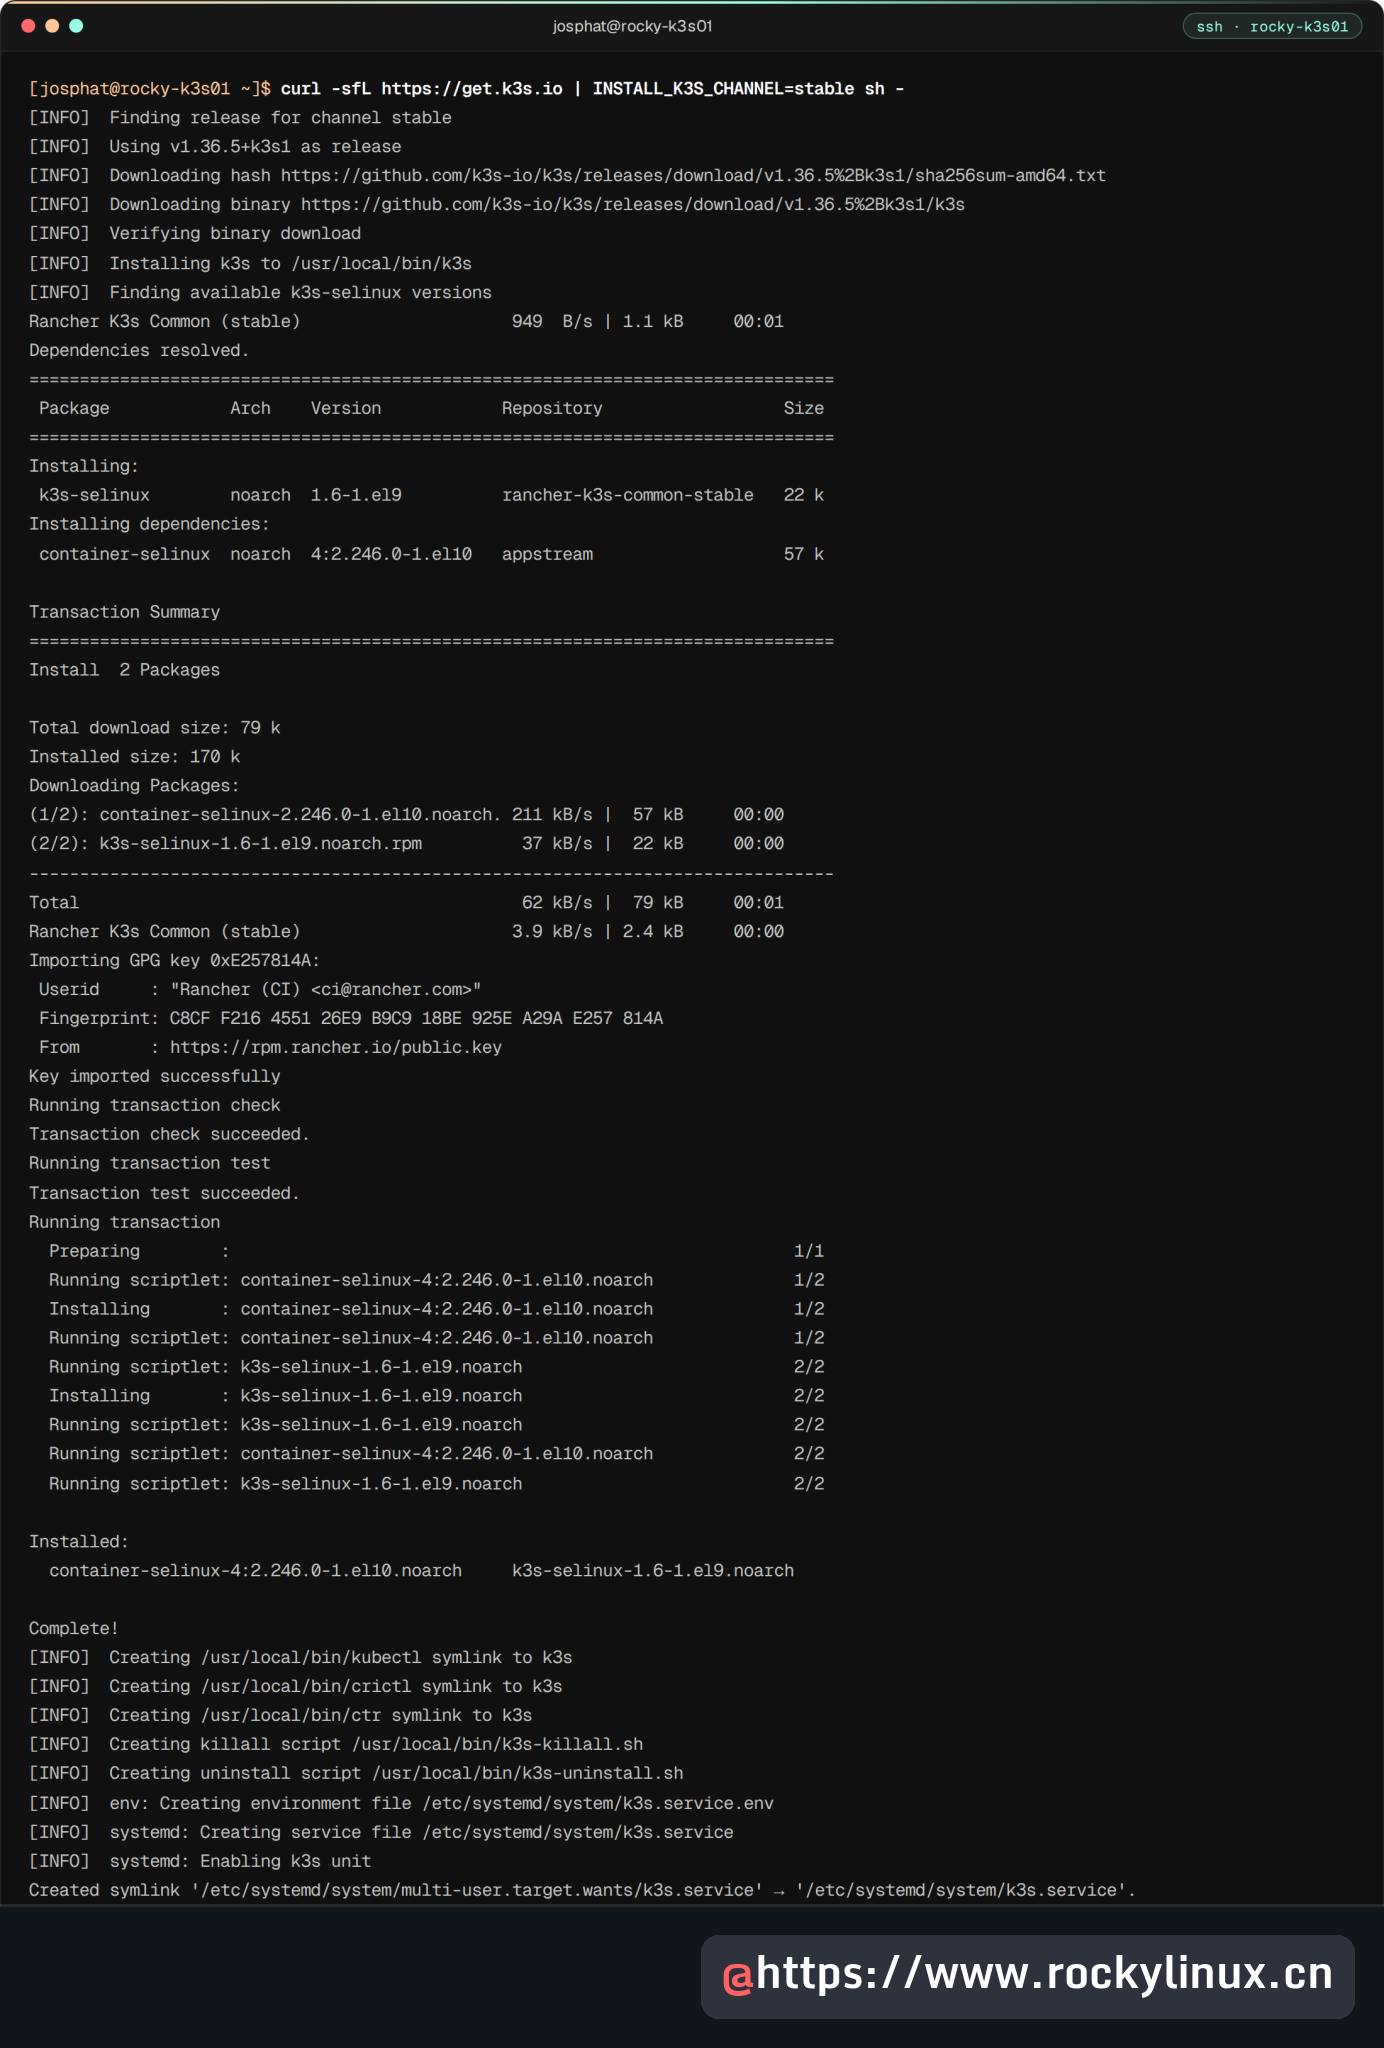
注意 k3s-selinux-1.6-1.el9 是为 EL9 构建的,而 container-selinux 来自 Rocky 10 自己的 AppStream。安装器写入的仓库 URL 以 centos/9/noarch 结尾。该策略在 Rocky 10.2 上可正常加载并执行,模块也出现在 semodule -l 的 container 旁边;但审计已安装包时应预期看到这个 EL9 版本字符串。
确认 Pod 在受限域中运行
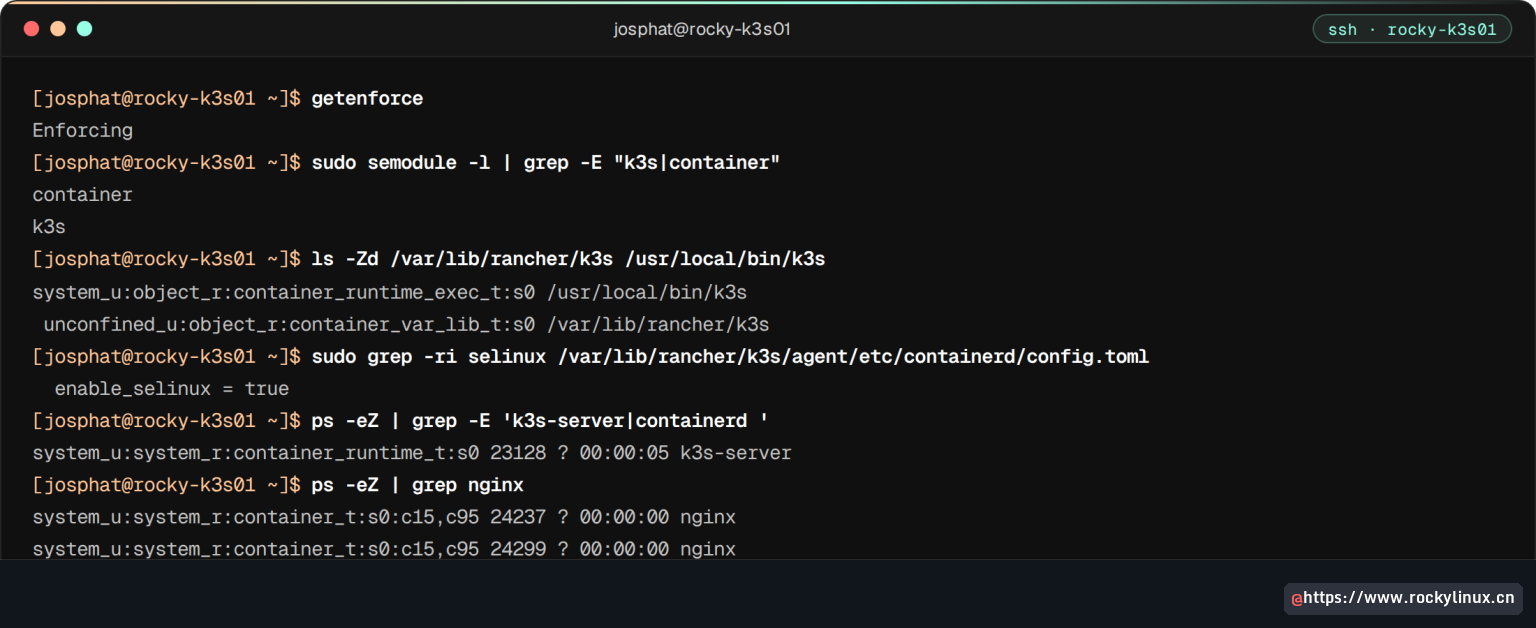
读取运行中容器的标签即可证明 SELinux 正在发挥作用。先部署任意工作负载,例如 sudo /usr/local/bin/k3s kubectl create deployment selinux-test --image=nginx:alpine,随后检查策略、文件上下文和进程标签。查看完毕后运行 sudo /usr/local/bin/k3s kubectl delete deploy selinux-test。
getenforce
sudo semodule -l | grep -E "k3s|container"
ls -Zd /var/lib/rancher/k3s /usr/local/bin/k3s
sudo grep -ri selinux /var/lib/rancher/k3s/agent/etc/containerd/config.toml
ps -eZ | grep -E 'k3s-server|containerd '
ps -eZ | grep nginx
启用 selinux: true 后,containerd 生成的配置包含 enable_selinux = true,K3s 二进制以 container_runtime_t 运行,每个 nginx 进程以 container_t 及其独立的 MCS 类别运行:
随后我们从配置中移除 selinux: true,重启 K3s 并启动另一个 nginx Deployment。containerd 配置变为 enable_selinux = false,新 Pod 以 spc_t 启动;这是 SELinux 不会限制的超级特权容器域:
system_u:system_r:spc_t:s0        39086 ?        00:00:00 nginx
system_u:system_r:spc_t:s0        39144 ?        00:00:00 nginx
system_u:system_r:spc_t:s0        39145 ?        00:00:00 nginx
因此,仅有 getenforce 显示 Enforcing、且已安装 k3s-selinux 还不够。没有该标志时,工作负载会在 enforcing 主机上以不受限方式运行,这与保留 SELinux 的初衷完全相反。所有 server 和 agent 都应在配置中写入 selinux: true。
为当前用户配置 kubectl
Rocky 的 sudoers 设置 secure_path = /sbin:/bin:/usr/sbin:/usr/bin,不包含 K3s 二进制及 kubectl 符号链接所在的 /usr/local/bin。因此在 Rocky 上运行 sudo k3s kubectl get nodes 会报 sudo: k3s: command not found,而 Ubuntu 通常不会。可以在 sudo 下使用完整路径;更好的做法是为普通用户配置 kubeconfig,让 kubectl 完全不再依赖 sudo:
mkdir -p ~/.kube
sudo cp /etc/rancher/k3s/k3s.yaml ~/.kube/config
sudo chown $USER:$USER ~/.kube/config
chmod 600 ~/.kube/config
echo 'export KUBECONFIG=~/.kube/config' >> ~/.bashrc
source ~/.bashrc
不要省略 KUBECONFIG。K3s 内置的 kubectl 默认仍读取 /etc/rancher/k3s/k3s.yaml,而不是 ~/.kube/config;如果只复制文件,第一次运行 kubectl get nodes 会报 error loading config file "/etc/rancher/k3s/k3s.yaml": open /etc/rancher/k3s/k3s.yaml: permission denied。保持系统文件权限为 0600 并导出变量,比放宽为 0644、让所有本地用户获得 cluster-admin 权限安全得多。检查客户端与服务端版本:
kubectl version两端都应显示 K3s 构建版本:
Client Version: v1.36.5+k3s1
Kustomize Version: v5.8.1
Server Version: v1.36.5+k3s1
若要从工作站管理集群,可复制同一文件,并将 server: https://127.0.0.1:6443 改为 https://10.0.1.50:6443。节点 IP 已在证书中;如果改用主机名或负载均衡地址,该名称必须包含在 tls-san 内。
将 worker 节点加入集群
agent 使用 server 的 node token 认证。应在 server 上读取并避免它出现在 shell 历史或截图中,因为任何持有该 token 的人都能向集群加入节点:
sudo cat /var/lib/rancher/k3s/server/node-token在 agent 上,确认已安装 kernel-modules-extra 并配置前述防火墙规则,然后先创建 agent 配置,确保它同样启用 SELinux 标签:
sudo mkdir -p /etc/rancher/k3s
sudo vim /etc/rancher/k3s/config.yaml
agent 只需两行配置:
selinux: true
node-ip: 10.0.1.51
随后使用 server URL 和 token 运行安装器。read -rs 会提示输入 token,但不会回显,也不会写入 shell 历史;设置 K3S_URL 后,脚本会安装 agent 而非 server,并把 unit 命名为 k3s-agent:
read -rs -p "Node token: " K3S_TOKEN; echo
curl -sfL https://get.k3s.io | INSTALL_K3S_CHANNEL=stable K3S_URL=https://10.0.1.50:6443 K3S_TOKEN="${K3S_TOKEN}" sh -
agent 会像 server 一样拉取 k3s-selinux。回到 server 后,安装器返回数秒内两台节点都应进入 Ready:
kubectl get nodes -o wide
kubectl get pods -A -o wide
实验截图中 agent 已 Ready 35 秒,运行与 server 相同的 containerd 构建,并已承载 Traefik 的 Service 负载均衡 Pod(svclb-traefik),因此 Ingress 也能通过 agent IP 响应。metrics-server 和 local-path-provisioner 的重启次数来自前文缺少模块的测试,不是节点加入造成的:
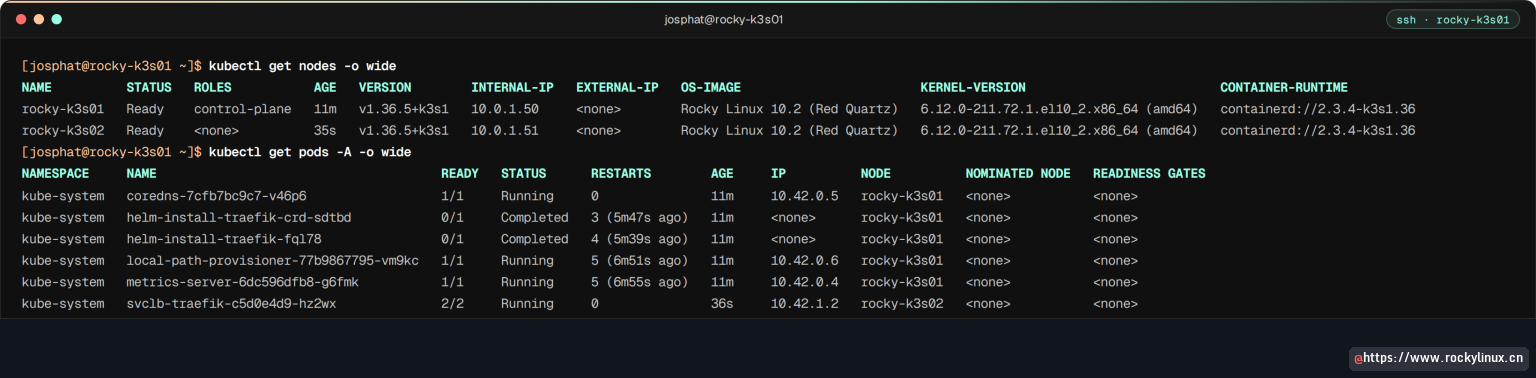
ROLES 列中,agent 显示 <none>,server 仅显示 control-plane。若 node selector 需要 worker 标签,可运行 kubectl label node rocky-k3s02 node-role.kubernetes.io/worker=true。
错误:agent 加入时出现“failed to get CA certs”
第一次加入尝试发生在 server 防火墙规则建立之前。安装器停在 systemd: Starting k3s-agent 并不返回,因为该 unit 会一直等待 agent 连接 server。agent 日志每两秒重复同一错误:
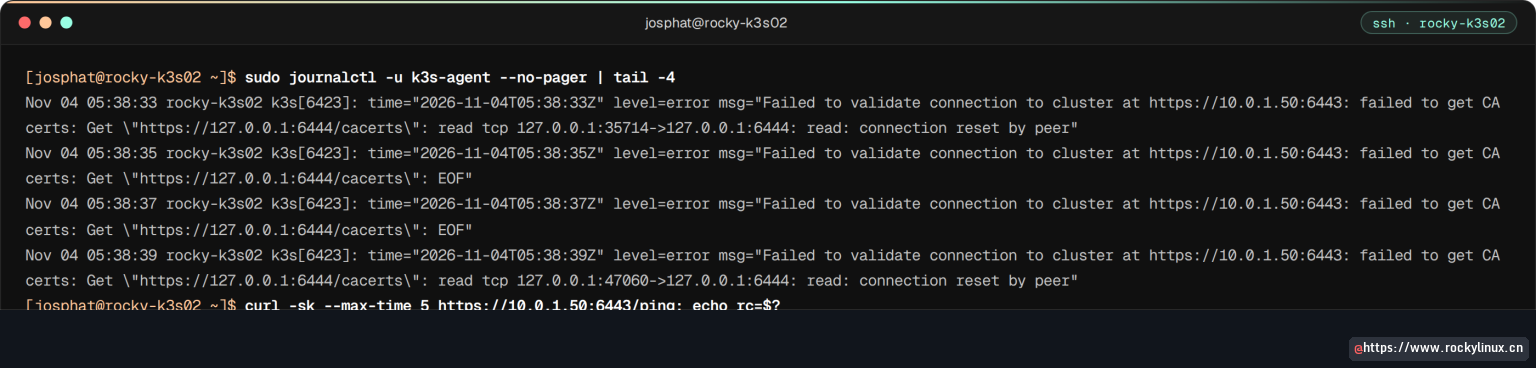
消息中的地址是 127.0.0.1:6444,即 agent 的本地负载均衡器,因此掩盖了真实原因。从 agent 直接运行 curl -sk https://10.0.1.50:6443/ping 返回退出码 7,表示 curl 完全无法连接。在 server 上开放端口,并在 agent 上运行 sudo systemctl restart k3s-agent 即可修复。无需重新运行安装器,节点会在一分钟内进入 Ready。
通过 Traefik 部署测试应用
让 Deployment 分布在两台节点上,可一次验证刚刚配置的全部环节:agent 调度、VXLAN 覆盖网络、集群 DNS,以及 Traefik 通过 firewalld 在 80 端口响应。创建清单:
vim ~/web-demo.yaml粘贴以下内容。拓扑分布约束要求调度器在每台节点放置一个副本,Ingress 则通过内置 traefik ingress class 路由 web.example.com:
apiVersion: apps/v1
kind: Deployment
metadata:
  name: web-demo
spec:
  replicas: 2
  selector:
    matchLabels:
      app: web-demo
  template:
    metadata:
      labels:
        app: web-demo
    spec:
      topologySpreadConstraints:
        - maxSkew: 1
          topologyKey: kubernetes.io/hostname
          whenUnsatisfiable: ScheduleAnyway
          labelSelector:
            matchLabels:
              app: web-demo
      containers:
        - name: nginx
          image: nginx:alpine
          ports:
            - containerPort: 80
---
apiVersion: v1
kind: Service
metadata:
  name: web-demo
spec:
  selector:
    app: web-demo
  ports:
    - port: 80
      targetPort: 80
---
apiVersion: networking.k8s.io/v1
kind: Ingress
metadata:
  name: web-demo
spec:
  ingressClassName: traefik
  rules:
    - host: web.example.com
      http:
        paths:
          - path: /
            pathType: Prefix
            backend:
              service:
                name: web-demo
                port:
                  number: 80
应用清单,然后分别使用正确的 Host 头访问两个节点 IP,并运行一个临时 busybox Pod,解析 Service 名称并通过它获取页面:
kubectl apply -f ~/web-demo.yaml
kubectl get pods -o wide -l app=web-demo
kubectl get ingress
curl -s -H 'Host: web.example.com' http://10.0.1.50/ | grep title
curl -s -H 'Host: web.example.com' http://10.0.1.51/ | grep title
kubectl run nettest --rm -i --restart=Never --image=busybox:1.36 -- sh -c 'nslookup web-demo.default.svc.cluster.local; wget -qO- http://web-demo | grep title'
两个节点各落一个副本,Ingress 列出两个节点地址,三条路径都返回 nginx 欢迎页标题。busybox Pod 通过 10.43.0.10 上的 CoreDNS 解析 web-demo,证明 Pod 到 Service 的流量能够正确穿过 firewalld:
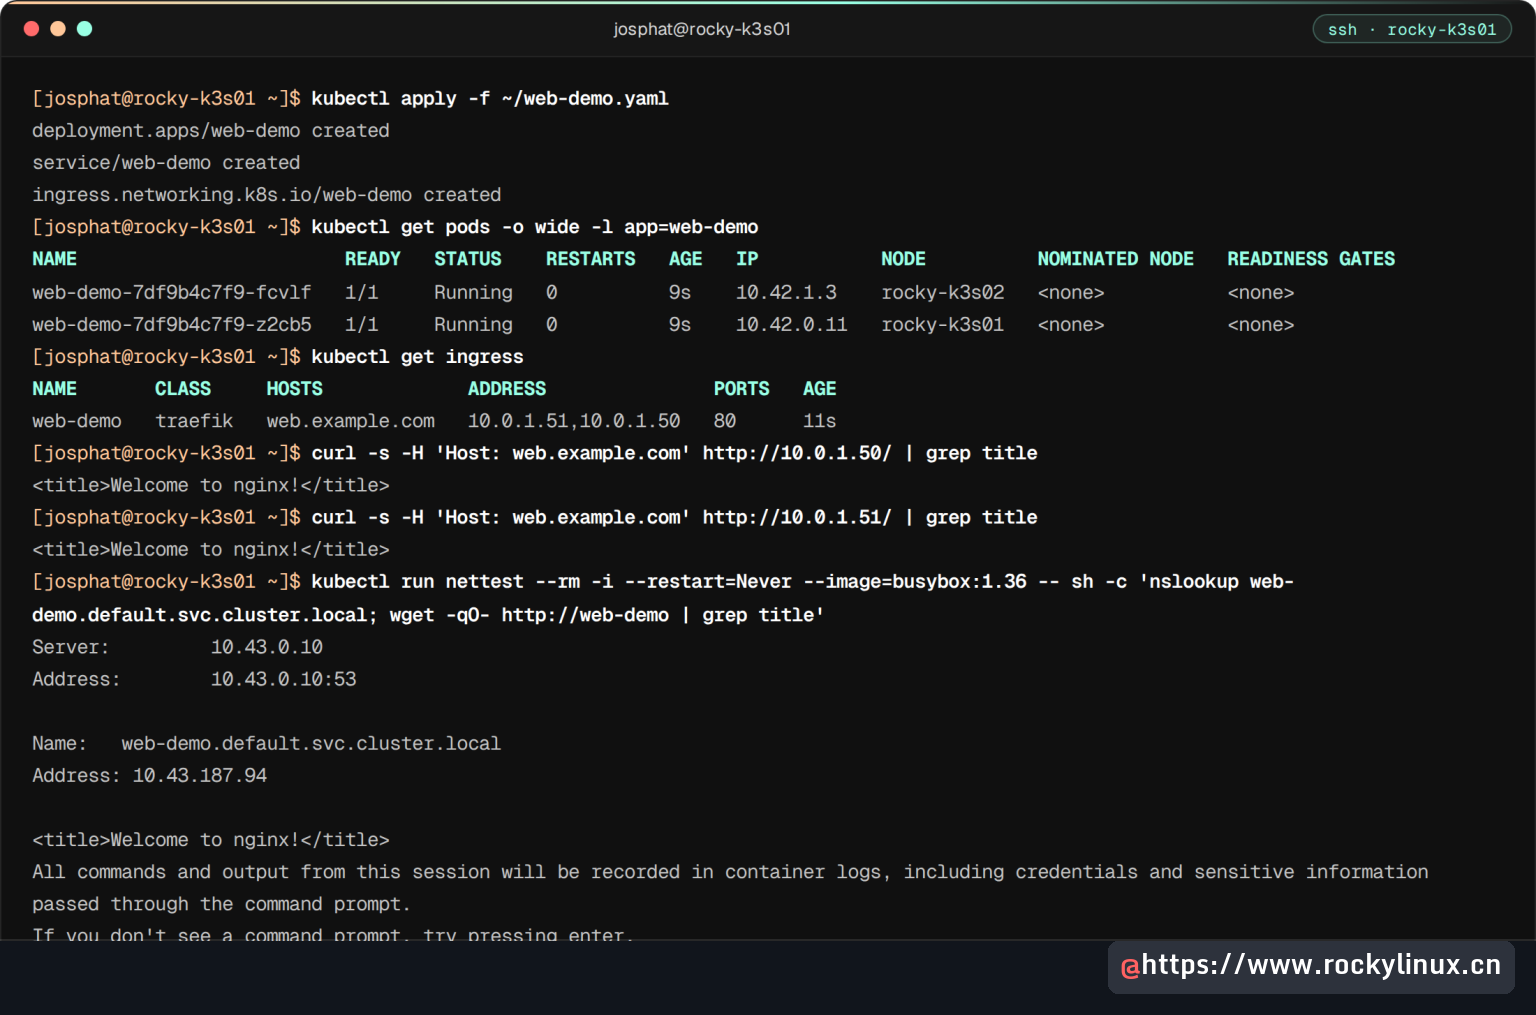
将真实 DNS 名称指向任意节点,Traefik 都会以同样方式提供服务。若还要公开 Traefik Dashboard,可另外配置其 Ingress;生产环境应同时加上认证与 TLS。
错误:Pod 内出现“nslookup: read: No route to host”
缺少 trusted zone 规则时会表现为该错误,而且很容易被误判为 CoreDNS 故障,因为 CoreDNS 本身仍保持 Running。为复现问题,我们在 server 运行时移除两个 CIDR,再运行同一个测试 Pod:
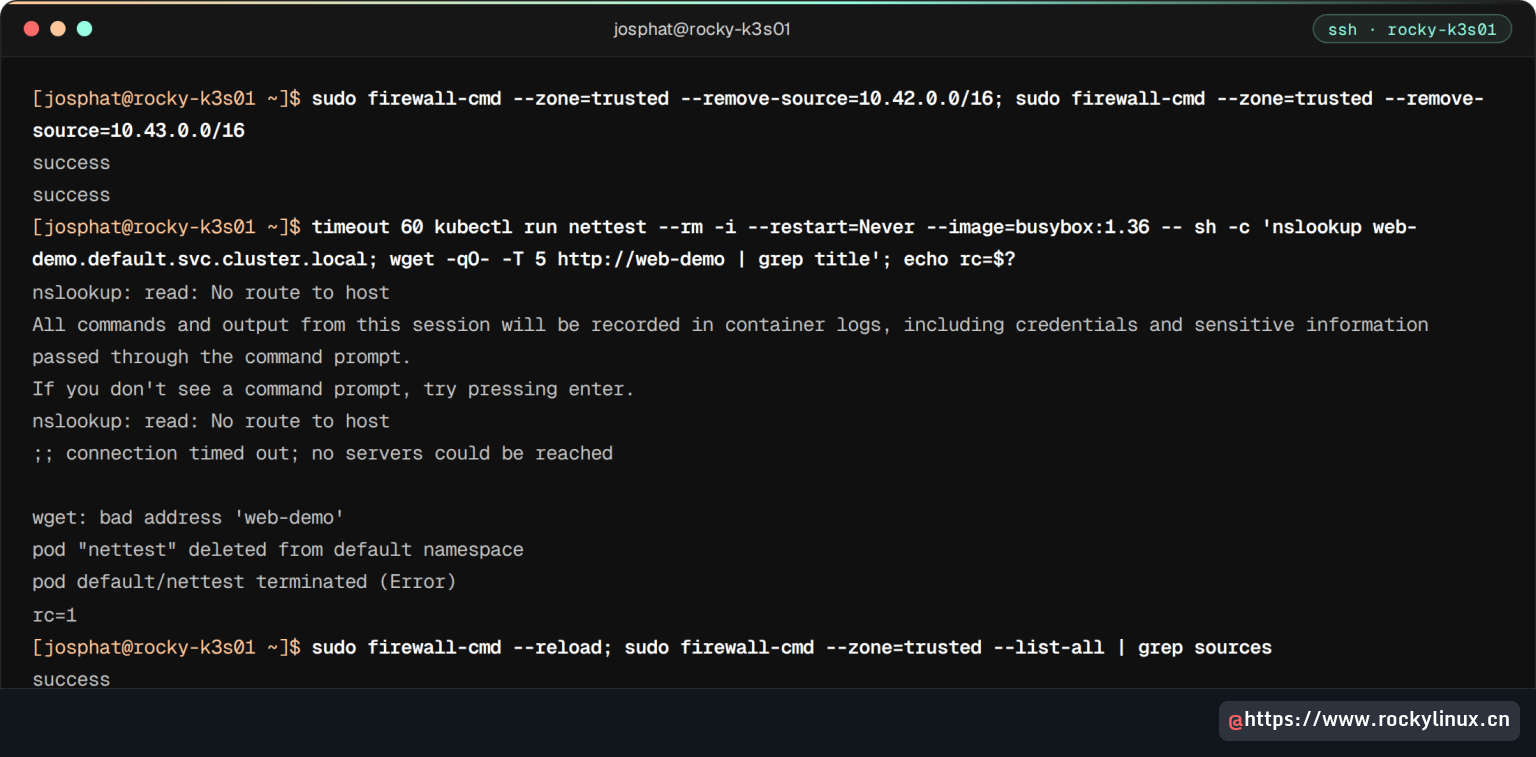
两个节点上的 Pod 都出现 No route to host,包括固定到 agent 的 Pod;wget 也无法解析 Service。同时 kubectl top nodes 仍正常,因为 metrics-server 通过仍然开放的 10250 访问 kubelet。执行 firewall-cmd --reload 恢复永久规则后,下一次测试通过。如果集群中的 Pod 无法解析任何名称,应先运行 sudo firewall-cmd --zone=trusted --list-sources,不要直接修改 CoreDNS。
K3s 1.30 之后发生了哪些变化
安装命令与旧指南相同,1.36 系列没有增删安装参数,但 1.36.3 开始接受 --tls-san=*.example.com 这类通配符。真正变化的是安装后得到的组件版本。下表前几行来自实验 server,其余来自 K3s v1.36 发布说明:
| 项目 | v1.36.5+k3s1 的行为 | 来源 |
|---|---|---|
| containerd | v2.3.4-k3s1.36 | 实验 |
| Traefik | 镜像 3.7.13,chart traefik-40.1.5+up40.1.0 | 实验 |
| CoreDNS / metrics-server / local-path | 1.14.7 / v0.9.0 / v0.0.37 | 实验 |
| 单 server 数据存储 | 通过 kine 使用 SQLite(state.db),不使用 etcd |
实验 |
| server 节点角色 | 仅 control-plane,不再有 master 标签 |
实验 |
| supervisor 指标与 pprof | 匿名请求返回 403 | 实验 |
| Traefik chart v40(1.36.2 起;1.35 系列为 1.35.6) | ingress-nginx provider 键名改为 kubernetesIngressNGINX |
发布说明 |
| Flannel | --flannel-cni-conf 现在会传递给内置 flannel(修复 #14598) |
发布说明 |
最可能破坏监控的是 supervisor 变化。从 v1.34.12、v1.35.9、v1.36.5 和 v1.37.1 补丁版本开始,K3s 会拒绝匿名访问 6443 端口上的 supervisor metrics、pprof 和内置 registry 路由。这些端点默认关闭;我们向 server 配置加入 supervisor-metrics: true 和 enable-pprof: true,重启 K3s 后分别以匿名方式和管理员客户端证书调用:
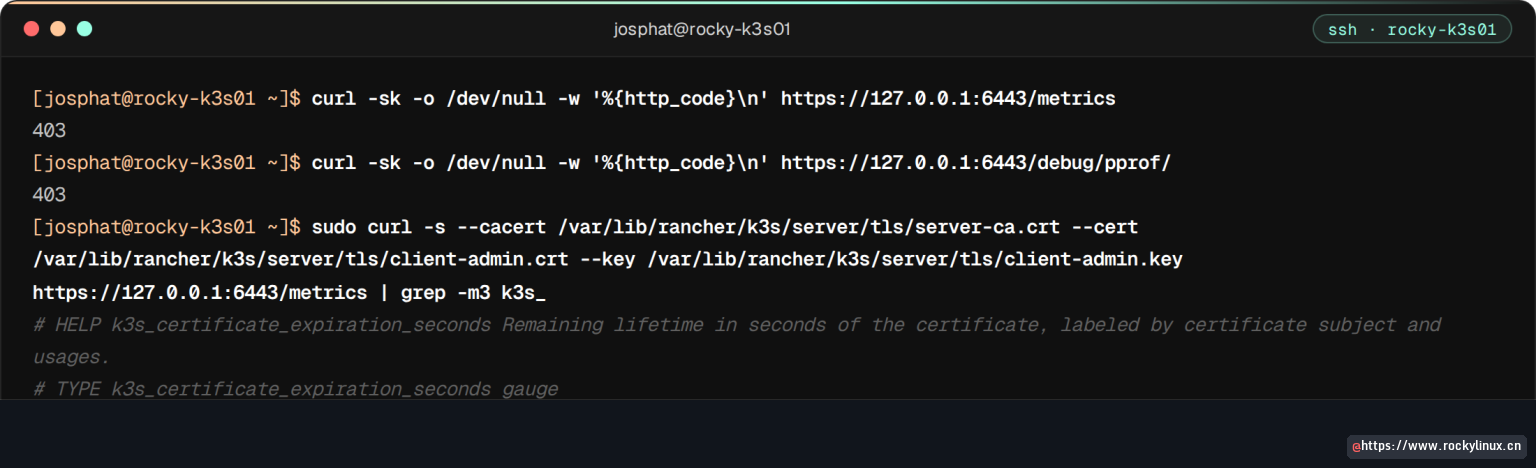
两次匿名请求均返回 403,使用证书则取得 k3s_certificate_expiration_seconds 指标。若旧版集群中有未携带凭据的 Prometheus 任务抓取 supervisor,升级后需要客户端证书或 bearer token。测试后我们再次移除两个设置,因为不进行性能分析时不应开启它们。
只有携带启用 ingress-nginx 兼容 provider 的 HelmChartConfig 时,才会受 Traefik 键名变化影响。旧的 kubernetesIngressNginx 拼写会被静默忽略。同日 latest 通道指向 v1.37.1+k3s1,1.37 系列增加了 --write-kubeconfig-name,并把 --advertise-address 写入 API server 证书。本指南不需要这些新功能,因此应留在 stable 通道。运行中集群现在也可以启用 Secrets 加密;相关步骤在 Ubuntu 和 Rocky 上的 K3s 版本中相同。
卸载 K3s 并清理 Rocky 节点
先从 server 端将 agent 移出集群,使其 Pod 在节点消失前干净地重新调度:
kubectl drain rocky-k3s02 --ignore-daemonsets --delete-emptydir-data
kubectl delete node rocky-k3s02
然后在 agent 本机运行卸载脚本。若卸载 server,则脚本为 /usr/local/bin/k3s-uninstall.sh。
sudo /usr/local/bin/k3s-agent-uninstall.sh在 Rocky 上,该脚本不只是停止服务。它会运行 dnf 删除安装器添加的 SELinux 包,再删除 Rancher 仓库文件:
Removed:
  container-selinux-4:2.246.0-1.el10.noarch     k3s-selinux-1.6-1.el9.noarch

Complete!
+ '[' -d /etc/zypp/repos.d ']'
+ '[' -d /etc/yum.repos.d ']'
+ rm -f /etc/yum.repos.d/rancher-k3s-common.repo
dnf 只删除 container-selinux,因为节点上没有其他组件依赖它;若安装了 Podman,该包会保留。脚本不会改动 firewalld 规则和 kernel-modules-extra。若节点将改用其他用途,应自行删除 K3s 端口和 trusted 源。对于全新 Rocky 10 主机,正确顺序是:先安装内核模块,再配置防火墙,在运行安装器前写入 selinux: true;在 agent 上的 Pod 能解析 Service 名称之前,不应把集群判定为健康。