Qdrant 通过两种协议提供相同的操作。REST 默认监听 6333 端口,浏览器、curl 命令和监控面板通常使用它;gRPC 默认监听 6334 端口,适用于延迟要求较高的生产服务。二者使用同一套存储、查询语义和认证机制,选择的关键在于调用场景与连接方式。Python 客户端只需先准备较新的 Python 环境,其余依赖由 SDK 安装。
本文介绍启用 API 密钥认证的 Qdrant 1.18.1 环境,依次演示 curl REST 请求、Python 异步客户端、原生 Python gRPC 存根和 Go 客户端如何操作相同数据。文中的执行结果与延迟均为原文测试记录,不代表译稿另行进行了环境测试。
原文测试环境:2026 年 5 月,Ubuntu 24.04.4 LTS、Qdrant 1.18.1、qdrant-client 1.18.0、Go 1.22.2、grpcio 1.80。
何时选择 REST,何时选择 gRPC
两种协议的性能特性不同。这里的 REST 使用 HTTP/1.1 与 JSON;每次请求需要建立或复用 TCP/TLS 连接,并完成 JSON 编解码。gRPC 使用 HTTP/2 和二进制 protobuf 消息,可在同一连接上多路复用调用,省去 JSON 转换。
| 比较项 | REST | gRPC |
|---|---|---|
| 传输格式 | HTTP/1.1 上的 JSON | HTTP/2 上的 protobuf |
| 默认端口 | 6333 | 6334 |
| 连接开销 | 不使用连接池时可能反复建连 | 同一连接复用多个 RPC 流 |
| 浏览器支持 | 支持,Web UI 使用 REST | 通常需要 gRPC-Web 代理 |
| 工具 | curl、Postman、各种 HTTP 库 | 生成的存根或对应 SDK |
| 单次读取延迟 | 可能受 JSON 与连接往返开销影响 | 二进制消息与热连接通常开销较低 |
| 并发吞吐 | 使用 keep-alive 时表现良好 | 多路复用适合大量并发调用 |
临时探索、仪表板、Shell 调试以及希望直接使用通用 HTTP 工具的服务,适合 REST。批量写入数百万个点、延迟敏感的推理链路,以及偏好强类型客户端的 Go、Rust 服务,可以考虑 gRPC。具体差异仍应以自身工作负载的测量为准。
启用 API 密钥认证的测试环境
原文在一台 Ubuntu 24.04 主机上用 Docker 运行 Qdrant 1.18.1,同时开放两种协议,并启用 API 密钥。在自己的测试环境中可按下面的命令准备:
mkdir -p /opt/qdrant/storage /opt/qdrant/snapshots
sudo chown -R 1000:1000 /opt/qdrant

sudo docker run -d --name qdrant --restart=always \
  -p 6333:6333 -p 6334:6334 \
  -e QDRANT__SERVICE__API_KEY=mySecretApiKey-2026 \
  -v /opt/qdrant/storage:/qdrant/storage \
  -v /opt/qdrant/snapshots:/qdrant/snapshots \
  qdrant/qdrant:v1.18.1
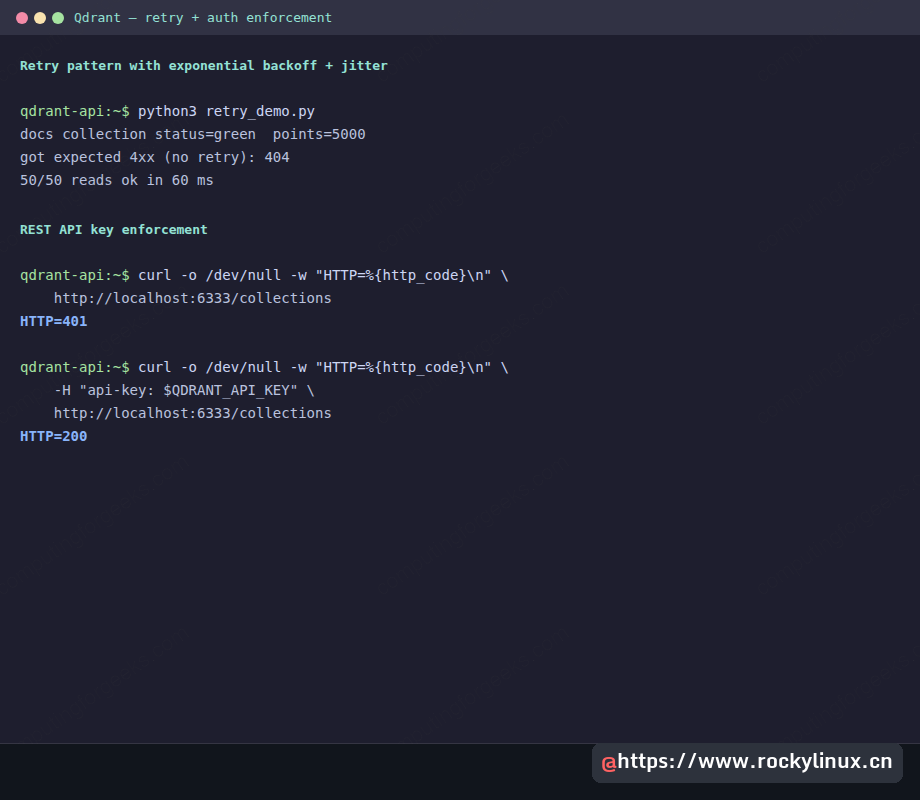
容器启动后,验证密钥检查确实生效:不携带请求头的请求应被拒绝,携带密钥后应正常返回。
curl -o /dev/null -w "HTTP=%{http_code}\n" \
    http://localhost:6333/collections
# HTTP=401

curl -o /dev/null -w "HTTP=%{http_code}\n" \
    -H "api-key: mySecretApiKey-2026" \
    http://localhost:6333/collections
# HTTP=200
两种协议使用相同密钥。REST 将密钥放在 HTTP 的 api-key 请求头中,gRPC 则放在同名元数据中,不需要另一套密码文件或令牌签发服务。
使用 REST 创建、列出、查看和删除集合
先把重复使用的值保存为 Shell 变量,之后只需在一处修改:
export API="http://localhost:6333"
export KEY="mySecretApiKey-2026"
export H_AUTH="-H api-key: ${KEY}"
export H_JSON="-H Content-Type: application/json"
创建使用 384 维向量和余弦距离的集合:
curl -sS -X PUT "${API}/collections/docs" \
  -H "api-key: ${KEY}" -H "Content-Type: application/json" \
  -d '{"vectors": {"size": 384, "distance": "Cosine"}}' | jq
响应包含创建结果及操作耗时。这里的时间由服务器测量,不包含完整客户端往返:
{
  "result": true,
  "status": "ok",
  "time": 0.267212598
}列出集合,再读取新集合详情。get_collection 返回完整配置,包括分片数量与载荷是否存储在磁盘上;接手已有集群时,这些信息尤其有用。
curl -sS -H "api-key: ${KEY}" "${API}/collections" | jq
curl -sS -H "api-key: ${KEY}" "${API}/collections/docs" \
| jq '{status:.result.status, points_count:.result.points_count, config:.result.config.params}'详情请求可以同时回答三个问题:集合是否健康(status)、包含多少点(points_count),以及向量维度、距离度量、分片数如何配置。监控脚本也可以读取这些字段。
使用 REST 写入、批处理、读取和删除点
Upsert 可在一次请求中插入或更新多个点。每个点包含 ID、向量和可选载荷。需要等待更新操作完成时使用 wait=true;大批量流式写入则可以选择异步提交。
curl -sS -X PUT "${API}/collections/docs/points?wait=true" \
  -H "api-key: ${KEY}" -H "Content-Type: application/json" \
  -d '{
    "points": [
      {"id": 1, "vector": [0.13, 0.84, ... 384 floats ...],
       "payload": {"title": "Intro to vectors", "category": "basics", "price": 0}},
      {"id": 2, "vector": [...],
       "payload": {"title": "HNSW deep dive", "category": "index", "price": 29}},
      {"id": 3, "vector": [...],
       "payload": {"title": "Filter cookbook", "category": "filters", "price": 19}}
    ]
  }' | jq
Qdrant 返回操作 ID。wait=true 表示等待更新操作应用完成,不能据此断言后台 HNSW 索引构建也已全部完成:
{
  "result": {"operation_id": 1, "status": "completed"},
  "status": "ok",
  "time": 0.019022392
}
原文测试环境的 REST 请求体上限为 32 MiB。5,000 个 384 维浮点向量加上载荷,被序列化为约 37 MB JSON 后,会触发 JSON payload (37314329 bytes) is larger than allowed (limit: 33554432 bytes)。可先改为每批 1,000 个点,并根据载荷大小控制批次与背压。32 MiB 是该配置下的限制,不是不可调整的协议上限。
按 ID 读取点,再精确统计数量:
curl -sS -X POST "${API}/collections/docs/points" \
  -H "api-key: ${KEY}" -H "Content-Type: application/json" \
  -d '{"ids": [1, 2, 3], "with_payload": true, "with_vector": false}' | jq

curl -sS -X POST "${API}/collections/docs/points/count" \
  -H "api-key: ${KEY}" -H "Content-Type: application/json" \
  -d '{"exact": true}' | jq
按过滤器删除时,无需自行枚举 ID,直接把载荷条件交给服务器。以下示例删除价格低于 20 的所有点:
curl -sS -X POST "${API}/collections/docs/points/delete?wait=true" \
  -H "api-key: ${KEY}" -H "Content-Type: application/json" \
  -d '{"filter": {"must": [{"key": "price", "range": {"lt": 20}}]}}' | jq
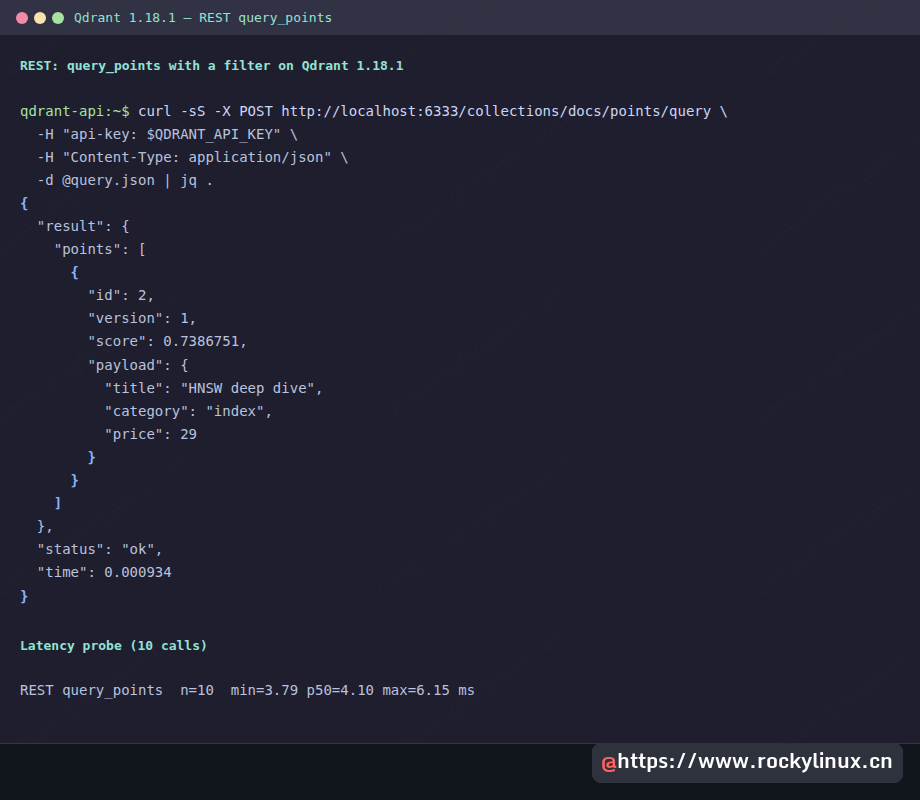
下面的终端截图展示了相同环境中的查询响应:只返回载荷,并对连续 10 次调用进行延迟测量。
使用现代 query_points API 搜索
query_points 是替代旧 /search 接口的统一查询方式,支持向量、过滤器、返回数量以及是否包含载荷和向量。结果位于 .result.points[],而非旧接口常见的 .result[],编写 jq 过滤表达式时要留意:
curl -sS -X POST "${API}/collections/docs/points/query" \
  -H "api-key: ${KEY}" -H "Content-Type: application/json" \
  -d '{
    "query": [... 384 floats ...],
    "limit": 3,
    "with_payload": true,
    "filter": {"must": [{"key": "category", "match": {"value": "index"}}]}
  }' | jq '.result.points[] | {id, score, payload}'
Web UI 的 Console 使用相同端点和请求体。在实例的 /dashboard/#/console 页面输入 API 密钥,粘贴请求并点击 RUN,即可在浏览器中排查过滤器为什么没有返回结果。
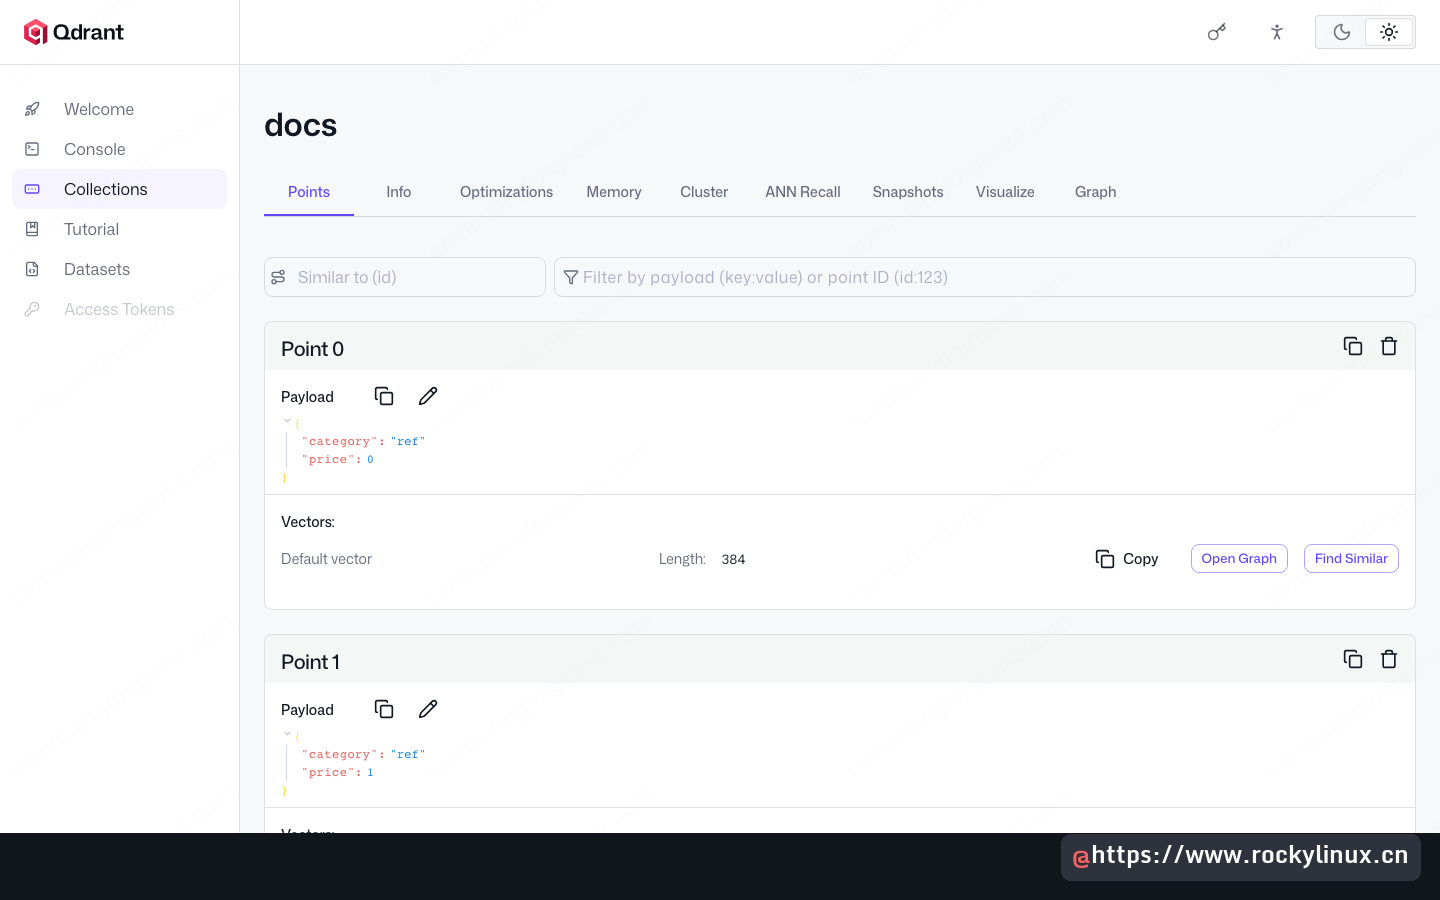
另一个读取接口 scroll 不需要查询向量,可以按页遍历集合。导出数据、回填字段或抽取测试样本时都很实用。limit 控制页大小,响应中的 next_page_offset 作为下一页的起点:
curl -sS -X POST "${API}/collections/docs/points/scroll" \
  -H "api-key: ${KEY}" -H "Content-Type: application/json" \
  -d '{"limit": 10, "with_payload": true, "with_vector": false}' | jq
通过 REST 管理快照和查看集群状态
先为集合创建快照,再列出现有快照。名称由服务器生成并包含时间戳,后续若要下载,应保存创建响应中的名称:
SNAP=$(curl -sS -X POST "${API}/collections/docs/snapshots" \
  -H "api-key: ${KEY}" | jq -r '.result.name')
echo "snapshot=$SNAP"

curl -sS -H "api-key: ${KEY}" "${API}/collections/docs/snapshots" | jq
集群端点会报告分布式模式是否启用。单节点部署返回 "status": "disabled" 属于正常结果;多节点部署则会显示节点 ID 与共识状态。
curl -sS -H "api-key: ${KEY}" "${API}/cluster" | jq
{
  "result": {"status": "disabled"},
  "status": "ok",
  "time": 0.000002499
}
Python 异步 REST 客户端与耗时测量
Python 客户端封装了两种协议。AsyncQdrantClient 的 REST 路径基于 HTTPX,支持 async/await,也能通过 asyncio.gather 并发调用。安装包含 gRPC 支持的依赖,便于切换协议:
python3 -m venv venv && source venv/bin/activate
pip install "qdrant-client>=1.18.0"
下面的基准脚本先插入 5,000 个随机点,每批 1,000 个,避免超过上述 JSON 限制;随后对同一批数据分别执行 100 次顺序 REST 异步查询与 100 次 gRPC 同步查询。
import asyncio, random, statistics, time
from qdrant_client import AsyncQdrantClient, QdrantClient, models

API_KEY = "mySecretApiKey-2026"
random.seed(7)
QUERY = [round(random.random(), 4) for _ in range(384)]

async def bench_rest_async():
    c = AsyncQdrantClient(url="http://localhost:6333", api_key=API_KEY)
    times = []
    for _ in range(100):
        t0 = time.perf_counter()
        await c.query_points(collection_name="docs", query=QUERY, limit=5)
        times.append((time.perf_counter() - t0) * 1000)
    await c.close()
    return times

def bench_grpc_sync():
    c = QdrantClient(host="localhost", grpc_port=6334,
                     prefer_grpc=True, https=False, api_key=API_KEY)
    times = []
    for _ in range(100):
        t0 = time.perf_counter()
        c.query_points(collection_name="docs", query=QUERY, limit=5)
        times.append((time.perf_counter() - t0) * 1000)
    c.close()
    return times
当 Qdrant 没有启用 TLS 时,需要显式传入 https=False。设置 api_key 后客户端可能默认使用 HTTPS,对明文 HTTP/2 监听器连接会出现 Tls handshake failed: SSL_ERROR_SSL: WRONG_VERSION_NUMBER。这属于客户端与服务器传输配置不一致。
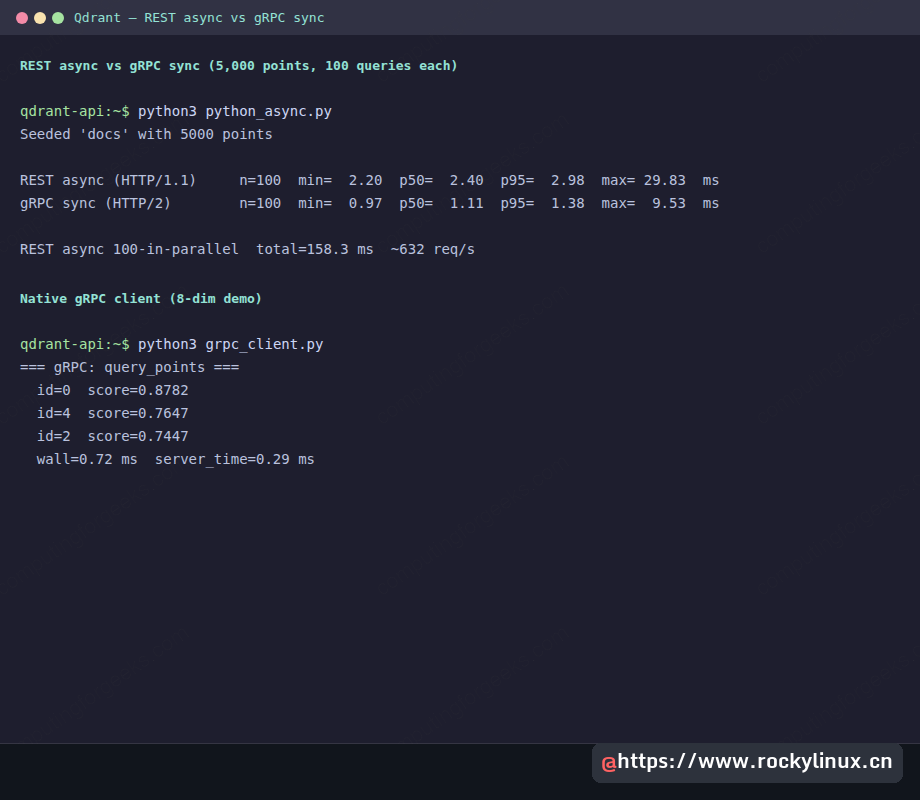
原文测试中,gRPC 单次读取的 p50 延迟约为 REST 的一半,p95 差距更大:
Seeded 'docs' with 5000 points

REST async (HTTP/1.1)     n=100  min=  2.20  p50=  2.40  p95=  2.98  max= 29.83  ms
gRPC sync (HTTP/2)        n=100  min=  0.97  p50=  1.11  p95=  1.38  max=  9.53  ms

REST async 100-in-parallel  total=158.3 ms  ~632 req/s
可以得到两点认识。首先,REST 单次查询的中位延迟约 2.4 毫秒,对多数 Web 请求已足够低。其次,启用 HTTP/1.1 keep-alive 并采用异步并发后,原文中一个 Python 进程仍实现了每秒 632 次纯搜索请求。该结果取决于测试环境,不能直接当作生产容量承诺。
直接使用原生 Python gRPC 存根
qdrant-client 包附带生成的 protobuf 存根。直接导入后可绕过高层封装,自行控制通道选项、截止时间,或接入已有 gRPC 服务体系。
import grpc
from qdrant_client.grpc import (
    CollectionsStub, ListCollectionsRequest, CreateCollection,
    DeleteCollection, VectorsConfig, VectorParams, Distance,
    PointsStub, UpsertPoints, PointStruct, PointId, Vectors, Vector,
    QueryPoints, Query, VectorInput, DenseVector, Value,
)

API_KEY = "mySecretApiKey-2026"
META = [("api-key", API_KEY)]

channel = grpc.insecure_channel("localhost:6334")
collections = CollectionsStub(channel)
points = PointsStub(channel)

collections.Create(
    CreateCollection(
        collection_name="grpc_demo",
        vectors_config=VectorsConfig(
            params=VectorParams(size=8, distance=Distance.Cosine),
        ),
    ),
    metadata=META,
)
查询必须遵循 protobuf 的嵌套消息结构。特别注意 VectorInput(dense=DenseVector(data=q_vec)):这里需要 DenseVector,不能传入普通 Vector。类型混用会在运行时触发 TypeError: Parameter to initialize message field must be dict or instance of same class: expected DenseVector got Vector。
q_vec = [0.33, 0.95, 0.04, 0.41, 0.55, 0.82, 0.16, 0.71]
qr = points.Query(
    QueryPoints(
        collection_name="grpc_demo",
        query=Query(nearest=VectorInput(dense=DenseVector(data=q_vec))),
        limit=3,
    ),
    metadata=META,
)
for r in qr.result:
    print(f"  id={r.id.num}  score={r.score:.4f}")
print(f"server_time={qr.time*1000:.2f} ms")
原文结果中,服务器处理耗时为 0.29 毫秒,客户端测得总耗时为 0.72 毫秒,差值来自回环链路上的调用与协议开销。跨机器部署后还会加入网络延迟,REST 与 gRPC 的比例需要重新测量。
使用官方 Go SDK 调用 gRPC
Go SDK 在生成的存根之上提供更易用的接口。先初始化模块并安装依赖:
mkdir qdrant-go && cd qdrant-go
go mod init qdrant-go-demo
go get github.com/qdrant/go-client/qdrant@latest
下面的完整客户端创建集合,写入 5 个包含字符串和浮点载荷的点,再查询并返回载荷。UseTLS: false 对应 Python 中的 https=False。
package main

import (
    "context"
    "fmt"
    "math/rand"
    "time"

    "github.com/qdrant/go-client/qdrant"
)

func main() {
    ctx, cancel := context.WithTimeout(context.Background(), 15*time.Second)
    defer cancel()

    client, _ := qdrant.NewClient(&qdrant.Config{
        Host: "localhost", Port: 6334,
        APIKey: "mySecretApiKey-2026", UseTLS: false,
    })
    defer client.Close()

    _ = client.DeleteCollection(ctx, "go_demo")
    client.CreateCollection(ctx, &qdrant.CreateCollection{
        CollectionName: "go_demo",
        VectorsConfig: qdrant.NewVectorsConfig(&qdrant.VectorParams{
            Size: 8, Distance: qdrant.Distance_Cosine,
        }),
    })

    rng := rand.New(rand.NewSource(42))
    pts := make([]*qdrant.PointStruct, 5)
    for i := range pts {
        v := make([]float32, 8)
        for j := range v { v[j] = rng.Float32() }
        pts[i] = &qdrant.PointStruct{
            Id:      qdrant.NewIDNum(uint64(i)),
            Vectors: qdrant.NewVectors(v...),
            Payload: qdrant.NewValueMap(map[string]any{
                "category": fmt.Sprintf("c%d", i%3),
                "price":    float64(i) * 9.99,
            }),
        }
    }
    wait := true
    client.Upsert(ctx, &qdrant.UpsertPoints{
        CollectionName: "go_demo", Points: pts, Wait: &wait,
    })

    qVec := []float32{0.61, 0.12, 0.95, 0.37, 0.55, 0.07, 0.82, 0.23}
    t0 := time.Now()
    res, _ := client.Query(ctx, &qdrant.QueryPoints{
        CollectionName: "go_demo",
        Query:          qdrant.NewQuery(qVec...),
        Limit:          qdrant.PtrOf(uint64(3)),
        WithPayload:    qdrant.NewWithPayload(true),
    })
    for _, r := range res {
        fmt.Printf("  id=%v score=%.4f payload=%v\n",
            r.GetId().GetNum(), r.GetScore(), r.GetPayload())
    }
    fmt.Printf("wall=%.2f ms\n", float64(time.Since(t0).Microseconds())/1000.0)
}
运行 go run main.go 后,可以看到每个结果的 ID、分数、载荷和本次调用的总延迟:
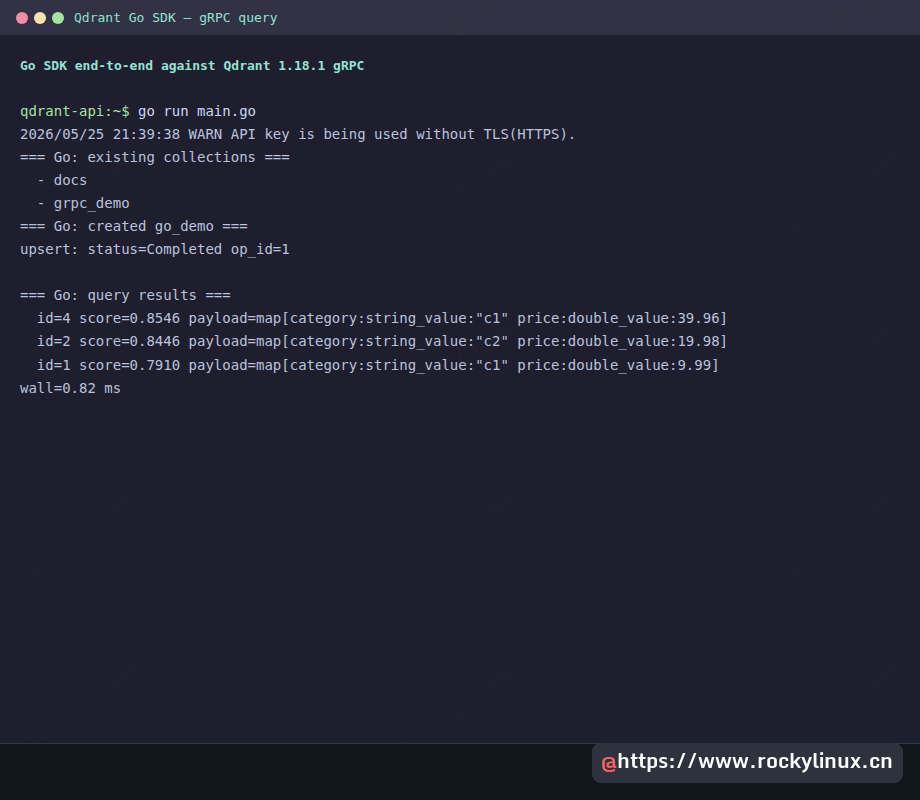
Go SDK 在无 TLS 连接上使用 API 密钥时会给出警告。本地回环测试时可以识别其原因;生产网络应同时使用 TLS,避免密钥与业务数据以明文传输。
重试与背压
网络调用难免失败。常用模式是针对暂时性故障,采用次数有限、带抖动的指数退避;请求格式错误或集合不存在等问题,应先修正请求,不能反复重试。
import random, time
from qdrant_client import QdrantClient
from qdrant_client.http.exceptions import ResponseHandlingException, UnexpectedResponse

def with_retry(fn, *, attempts=5, base_delay=0.1, max_delay=5.0):
    transient = (ResponseHandlingException, ConnectionError)
    for i in range(attempts):
        try:
            return fn()
        except UnexpectedResponse as exc:
            if exc.status_code < 500:
                raise   # 4xx are client errors, do not retry
            if i == attempts - 1:
                raise
        except transient:
            if i == attempts - 1:
                raise
        sleep = min(max_delay, base_delay * (2 ** i))
        sleep += random.uniform(0, sleep * 0.25)  # jitter
        time.sleep(sleep)
该封装覆盖了计划重启时的 503、负载下的临时连接重置,以及 Kubernetes 驱逐 Pod 时的 TCP RST,并避免重复提交确定失败的 400、404 请求。原文把所有 4xx 都归为不可重试过于绝对;遇到 429 等暂时性响应,应按服务端提示和限流策略单独处理。
需要按密钥执行配额时,可在前端放置 L7 代理,例如 Envoy 或 Nginx 的 limit_req,也可限制客户端并发。一个简单起点是使用 asyncio.Semaphore,把并发数设为集群 CPU 数的约两倍,再根据实际延迟、CPU 与排队情况调整。
容易踩到的五个问题
- REST 请求体大小限制。 原文环境的 32 MiB 限制使 5,000 个 384 维点的 JSON 批次失败。可减小到每批 1,000 个,或评估 gRPC;实际批次应按字节大小控制。
- 设置密钥后客户端可能默认启用 TLS。 明文监听器需要 Python 的
https=False或 Go 的UseTLS: false。无 TLS 认证警告不能直接忽略于生产网络。 VectorInput需要DenseVector。 原生 gRPC 查询使用VectorInput(dense=DenseVector(data=...));Upsert 中的Vector不能直接用于这个字段。- 查询结果位于
.result.points[]。 从旧/search迁移时需要同步修改 jq 路径。 - Console 的基础路径与 Shell 不同。 原文所测 Web UI 的基础地址包含
/dashboard/。把完整 curl 原样粘贴进 Console 可能导致路径错误,应使用 Console 接受的请求格式,并检查最终请求路径。
根据调用场景逐步决定协议
多数团队会同时使用两种协议:REST 用于运行手册里的 curl、监控面板与浏览器调试,gRPC 用于对延迟敏感的服务链路。可参考以下原则:
- 浏览器与 Shell 脚本优先使用 REST,工具支持最直接。
- Go 或 Rust 服务若在关键路径中频繁查询 Qdrant,可评估 gRPC。一次请求扇出多次查询时,每次调用的差异会累积。
- Python 或 Node.js 服务可先使用 REST。只有性能分析确认 Qdrant 调用显著影响尾延迟时,再评估切换成本与收益;中位数节省约 1 毫秒未必值得额外维护。
两种协议共享存储、安全机制与查询语义,可以按每个调用方的需要选择,无需为此改动服务器端数据。