Qdrant 中的向量虽然属于派生数据,重新生成它们所需的模型与语料却未必始终可得,计算成本也可能很高。为 1,000 万篇文档重新运行 BGE-small 需要大量时间,而恢复快照通常更快。因此,备份流程应包含离机保存和恢复验证。需要自建对象存储时,也可以使用兼容 S3 的 MinIO 作为目标。
本文介绍快照的完整生命周期:集合级与完整存储快照、三种恢复方式、基于实例 IAM 角色的 S3 备份,以及删除测试集合后从 S3 恢复的演练。命令输出与耗时来自原文测试,并非译稿另行执行。
原文测试环境:2026 年 5 月,Ubuntu 24.04.4 LTS、Qdrant 1.18.1、qdrant-client 1.18.0、fastembed 0.8.0、AWS CLI 2.34,以及 eu-west-1 区域的 S3 存储桶。
快照与直接复制存储目录的区别
直接在 Qdrant 运行时用 rsync 复制 /qdrant/storage,只能得到复制过程中各文件的状态。写入仍在进行,段文件、WAL 和元数据可能在不同时间发生变化,无法据此保证一致恢复。
快照接口则由数据库协调,生成包含相应数据、载荷与索引状态的归档,可在继续提供服务的同时取得可恢复副本。不要把普通运行中目录复制当成等价替代,也不应把创建快照理解为让整个集群停止写入。
| 端点 | 范围 | 输出位置 |
|---|---|---|
POST /collections/{name}/snapshots |
指定集合在当前节点上的快照 | /qdrant/snapshots/{name}/ 中的归档 |
POST /snapshots |
单节点完整存储快照,含集合和别名 | /qdrant/snapshots/ 中的归档 |
技术修正: 原文称第二种为“整个集群快照”并暗示能原子恢复分布式集群,这不准确。完整存储快照适用于单节点部署;分布式部署需要按节点与分片规划集合快照及恢复,不能用一个 /snapshots 归档代替全局备份。
日常备份和轻量迁移通常选择集合快照;单节点完整恢复可以使用完整存储快照,并事先验证相应恢复方式。
通过 API 创建快照
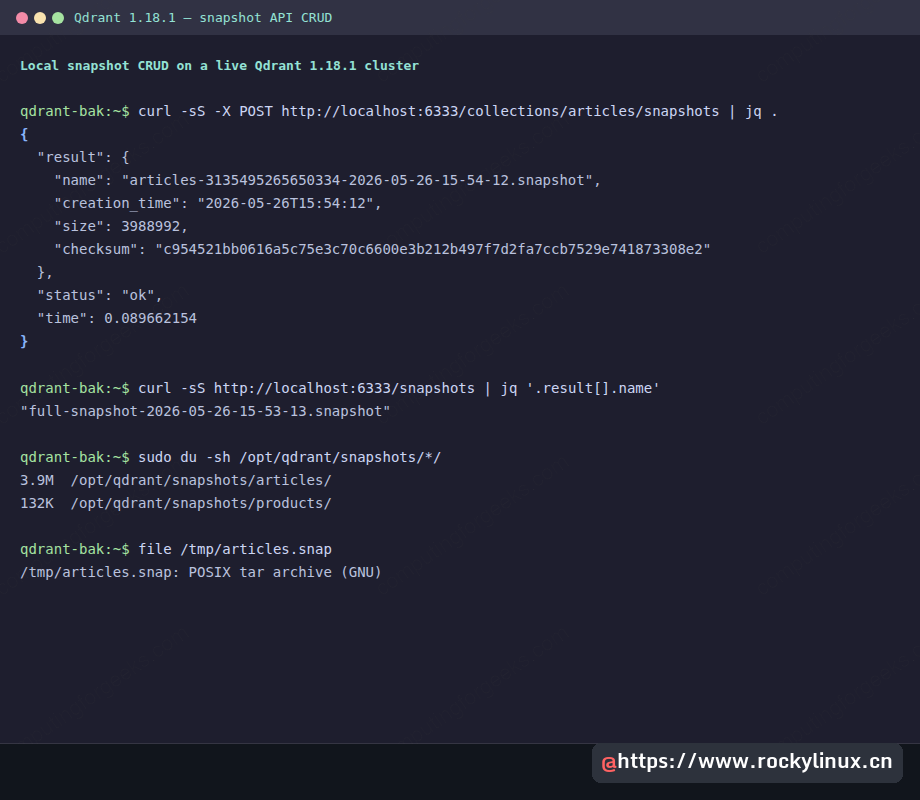
先创建一个集合的快照。响应包含文件名、字节大小、创建时间和 SHA-256 校验和:
curl -sS -X POST http://localhost:6333/collections/articles/snapshots | jq .
{
  "result": {
    "name": "articles-3135495265650334-2026-05-26-15-54-12.snapshot",
    "creation_time": "2026-05-26T15:54:12",
    "size": 3988992,
    "checksum": "c954521bb0616a5c75e3c70c6600e3b212b497f7d2fa7ccb7529e741873308e2"
  },
  "status": "ok",
  "time": 0.089662154
}
文件名结合集合名、节点标识和时间戳。原文中,1,000 个 384 维 BGE-small 向量的集合生成约 3.9 MB 快照,耗时 90 毫秒;另一个含 200 个 8 维向量的 products 集合约为 132 KB,耗时 56 毫秒。体积受点数、维度、载荷和索引等因素共同影响,载荷较大时也可能占主要部分。
下面分别列出集合快照和完整存储快照,并查看本地大小。注意 /snapshots 列表不是“列出每个集合的全部快照”的替代接口。
curl -sS http://localhost:6333/collections/articles/snapshots | jq .
curl -sS http://localhost:6333/snapshots | jq .

sudo du -sh /opt/qdrant/snapshots/*/
# 3.9M  /opt/qdrant/snapshots/articles/
# 132K  /opt/qdrant/snapshots/products/
完整存储快照使用独立端点。在原文单节点测试机上,两个集合及相关元数据合计约 4.1 MB,耗时约 200 毫秒:
curl -sS -X POST http://localhost:6333/snapshots | jq .
# {
#   "result": {
#     "name": "full-snapshot-2026-05-26-15-53-13.snapshot",
#     "creation_time": "2026-05-26T15:53:14",
#     "size": 4118528,
#     "checksum": "6edce854d154e7cb740c3ea4a9156b8791538f3b5cb1adfae431456c802e505d"
#   },
#   "status": "ok",
#   "time": 0.186404091
# }
文件采用 tar 归档格式,旁边可能还有 .checksum 文件。可以解包到独立检查目录进行排查,但恢复时应使用 Qdrant 提供的恢复机制,不要直接解包覆盖运行中的存储目录。
将快照下载到其他机器
快照默认仍在服务器的 /qdrant/snapshots 下,若磁盘损坏,本地快照也会丢失。创建完成后,应通过 HTTP 下载接口,或使用 scp、rsync 将已完成文件复制到其他位置。
SNAP=articles-3135495265650334-2026-05-26-15-54-12.snapshot
curl -sS -o /tmp/articles.snapshot \
    "http://localhost:6333/collections/articles/snapshots/${SNAP}"

ls -lh /tmp/articles.snapshot
# -rw-rw-r-- 1 ubuntu ubuntu 3.9M  /tmp/articles.snapshot
file /tmp/articles.snapshot
# /tmp/articles.snapshot: POSIX tar archive (GNU)
HTTP 下载可以流式传输大文件,无需一次把整个归档装入客户端内存。对于数十 GB 的快照,应优先考虑流式工具,避免误用会把文件全部读入内存的客户端方式。
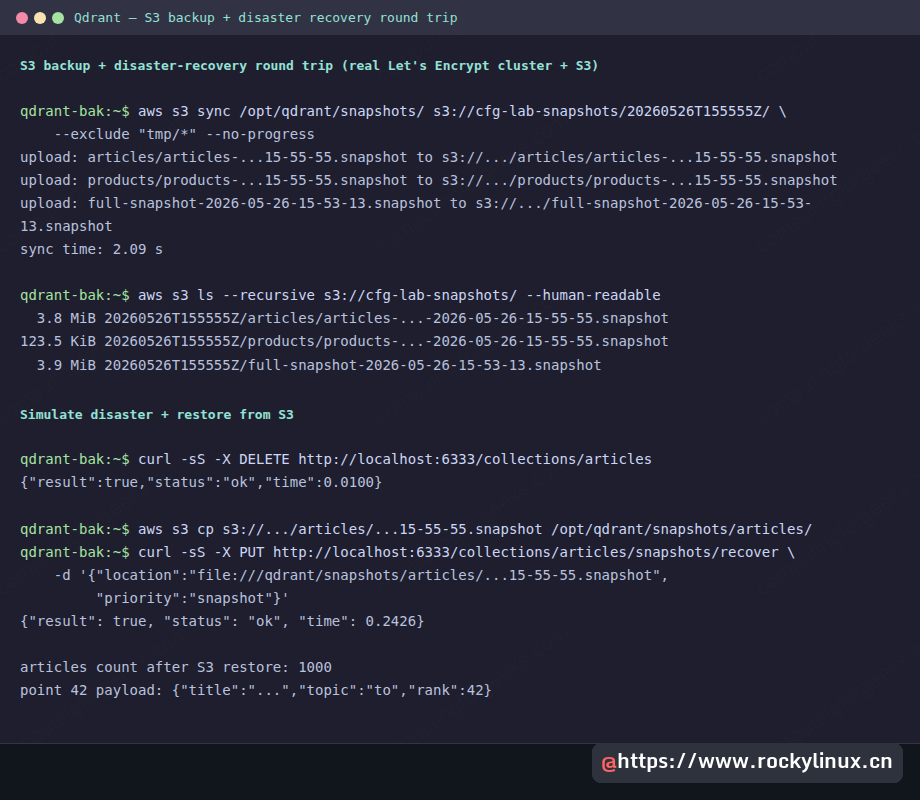
持续离机备份可以使用 aws s3 sync 同步快照目录:Qdrant 负责生成文件,外部工具负责上传。下面介绍这种模式。
三种恢复路径
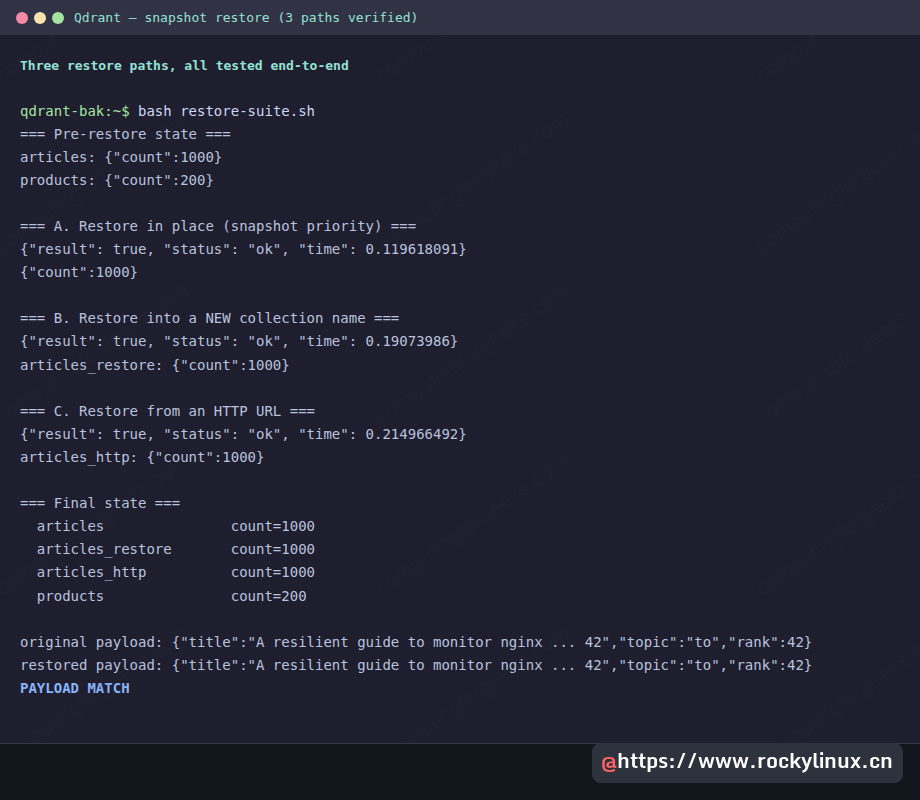
集合恢复接口接收快照位置与目标集合名。常用方式包括:
- 使用当前节点可见的本地文件 URL,原位恢复。
- 使用 HTTP 地址,由 Qdrant 下载文件,实现跨节点迁移。
- 使用相同快照和一个新的集合名,先恢复副本验证,避免覆盖现有集合。
# A. Restore in place (overwrites the collection)
curl -sS -X PUT http://localhost:6333/collections/articles/snapshots/recover \
  -H "Content-Type: application/json" \
  -d '{
        "location": "file:///qdrant/snapshots/articles/articles-...-15-54-12.snapshot",
        "priority": "snapshot"
      }'
# {"result": true, "status": "ok", "time": 0.119618091}

# B. Restore into a NEW collection (clone)
curl -sS -X PUT http://localhost:6333/collections/articles_restore/snapshots/recover \
  -H "Content-Type: application/json" \
  -d '{
        "location": "file:///qdrant/snapshots/articles/articles-...-15-54-12.snapshot"
      }'
# {"result": true, "status": "ok", "time": 0.19073986}

# C. Restore from an HTTP URL (Qdrant fetches the snapshot itself)
curl -sS -X PUT http://localhost:6333/collections/articles_http/snapshots/recover \
  -H "Content-Type: application/json" \
  -d '{
        "location": "http://localhost:6333/collections/articles/snapshots/articles-...-15-54-12.snapshot"
      }'
# {"result": true, "status": "ok", "time": 0.214966492}
priority 决定快照与现有副本发生冲突时的优先级。"snapshot" 以快照数据为准;默认的 "replica" 优先现有副本。后者不能简单理解为把任意缺失记录合并回去,具体行为与部署方式有关。恢复到新集合时也应明确加入 "priority":"snapshot";上面原文 B、C 两个示例省略了它,需要补上,避免默认偏好空集合而得到空数据。灾难恢复时还应确认目标集合与副本状态。
验证恢复时先比较点数,再检查已知 ID 的载荷与向量:
=== Final state ===
  articles               count=1000
  articles_restore       count=1000
  articles_http          count=1000
  products               count=200

original payload: {"title":"A resilient guide to monitor nginx ... 42","topic":"to","rank":42}
restored payload: {"title":"A resilient guide to monitor nginx ... 42","topic":"to","rank":42}
PAYLOAD MATCH
原文三次恢复得到相同数据与载荷,并保留了索引状态。实际环境仍应检查索引、配置、版本兼容性和健康状态,不要仅以接口返回成功作为验收。
使用 IAM 角色执行 S3 备份
生产中可以通过 cron 或 systemd timer,把快照目录同步到 S3。EC2 实例关联 IAM 角色后,AWS CLI 可获取临时凭据,避免在主机长期保存静态访问密钥。下面创建存储桶,并配置仅限该桶的 ListBucket、GetObject、PutObject 和 DeleteObject 权限;若流程不需要删除远端对象,可以进一步移除删除权限。
aws s3api create-bucket --region eu-west-1 \
  --bucket cfg-snapshots-1779810367 \
  --create-bucket-configuration LocationConstraint=eu-west-1

cat > s3pol.json <<'EOF'
{"Version":"2012-10-17","Statement":[
  {"Effect":"Allow","Action":["s3:ListBucket"],
   "Resource":"arn:aws:s3:::cfg-snapshots-1779810367"},
  {"Effect":"Allow","Action":["s3:GetObject","s3:PutObject","s3:DeleteObject"],
   "Resource":"arn:aws:s3:::cfg-snapshots-1779810367/*"}
]}
EOF
aws iam put-role-policy --role-name cfg-qdrant-ec2-role \
  --policy-name s3-snapshots --policy-document file://s3pol.json
在实例内核对当前身份与角色是否生效:
aws sts get-caller-identity
# {
#   "UserId": "AROAR...:i-04fe11cae5b715773",
#   "Account": "075502422778",
#   "Arn": "arn:aws:sts::075502422778:assumed-role/cfg-qdrant-ec2-role/i-04fe11cae5b715773"
# }
同步快照目录时,排除尚未完成的临时文件。示例跳过顶层 tmp/* 与 *.tmp;还应核对当前版本真实的临时目录位置,确保不会复制正在生成的归档。
TS=$(date -u +%Y%m%dT%H%M%SZ)
aws s3 sync /opt/qdrant/snapshots/ \
    s3://cfg-snapshots-1779810367/${TS}/ \
    --exclude "tmp/*" --exclude "*.tmp" --no-progress
此示例每次使用新的时间戳前缀,因此会把本地仍保留的快照再次上传到新目录,而不是对所有历史批次做全局去重。容量预算应按实际上传集合计算。
将“创建快照、等待完成、同步、校验结果”写入 /usr/local/bin/qdrant-backup.sh,再按可接受的数据丢失窗口(RPO)配置 timer。下面只提供 unit 示例,脚本本身仍需实现。每小时或每六小时只是不同需求下的示例,不等于统一生产标准。
# /etc/systemd/system/qdrant-backup.service
[Unit]
Description=Snapshot Qdrant collections and sync to S3

[Service]
Type=oneshot
ExecStart=/usr/local/bin/qdrant-backup.sh

# /etc/systemd/system/qdrant-backup.timer
[Unit]
Description=Hourly Qdrant snapshot + S3 backup

[Timer]
OnCalendar=hourly
Persistent=true

[Install]
WantedBy=timers.target
端到端灾难恢复演练
备份必须经过恢复验证。以下命令包含删除集合,应只在明确用于演练的数据或隔离环境中执行。原文按下面顺序删除测试集合,再仅使用 S3 中的快照恢复:
# 1. Disaster: drop the articles collection
curl -sS -X DELETE http://localhost:6333/collections/articles
# {"result":true,"status":"ok","time":0.010}

# Confirm the collection is gone
curl -sS http://localhost:6333/collections | jq -c '.result.collections'
# [{"name":"products"}]

# 2. Pull the latest snapshot from S3
SNAP=$(aws s3 ls "s3://cfg-snapshots-1779810367/${TS}/articles/" \
       | awk '$NF ~ /\.snapshot$/ {print $NF}' | tail -1)
aws s3 cp "s3://cfg-snapshots-1779810367/${TS}/articles/${SNAP}" \
    /opt/qdrant/snapshots/articles/${SNAP}

# 3. Restore in place from the local file
curl -sS -X PUT http://localhost:6333/collections/articles/snapshots/recover \
  -H "Content-Type: application/json" \
  -d "{\"location\": \"file:///qdrant/snapshots/articles/${SNAP}\",
       \"priority\": \"snapshot\"}"
# {"result": true, "status": "ok", "time": 0.2426}

# 4. Verify
curl -sS -X POST http://localhost:6333/collections/articles/points/count \
    -H "Content-Type: application/json" -d '{"exact": true}'
# {"result": {"count": 1000}, "status": "ok"}
原文 4 MB 快照的完整演练少于 3 秒。真实多 GB 快照的耗时还取决于下载带宽、磁盘与恢复处理。原文在 t3.small 上记录过约 50 MB/s 的下载速度,该数字不能直接套用于其他环境。
命令修正: 原文提到的 --cli-write-timeout 不是标准 AWS CLI 通用参数。遇到网络超时时,应核对实际版本支持的 --cli-connect-timeout、--cli-read-timeout 与 S3 传输配置,不要直接复制该错误参数。大文件传输还应核验最终大小与校验和。
轮换本地快照与配置 S3 生命周期
快照会持续占用空间。按每小时生成一个 4 MB 文件计算,每日约 100 MB,每月约 3 GB,但前面的时间戳前缀重复上传可能进一步放大总量。可以同时使用本地保留策略与 S3 生命周期。
下面按集合保留最近 24 个快照。执行删除前应确认已经离机备份,并考虑同步清理不再需要的校验文件。
# Local rotation: keep last 24 hourly snapshots per collection
for D in /opt/qdrant/snapshots/*/; do
    ls -t "$D"*.snapshot 2>/dev/null | tail -n +25 | xargs -r sudo rm -v
done
原文给出的生命周期示例是 7 天转 Standard-IA、30 天转 Glacier Instant Retrieval、365 天删除,代码保留如下用于对照:
cat > lifecycle.json <<'EOF'
{
  "Rules": [{
    "ID": "qdrant-snapshots",
    "Status": "Enabled",
    "Filter": {"Prefix": ""},
    "Transitions": [
      {"Days":  7, "StorageClass": "STANDARD_IA"},
      {"Days": 30, "StorageClass": "GLACIER_IR"}
    ],
    "Expiration": {"Days": 365}
  }]
}
EOF
aws s3api put-bucket-lifecycle-configuration \
    --bucket cfg-snapshots-1779810367 \
    --lifecycle-configuration file://lifecycle.json
必须修正后再执行: 上述同一规则在第 7 天转入 Standard-IA、第 30 天再转出,中间仅停留 23 天,少于 Standard-IA 的 30 天最短存储期限。AWS 官方文档对同一规则内的连续转换有最短存储期约束;可把两级转换调整为 Days: 30 与 Days: 60 或更晚,也可以删除 Standard-IA 阶段,按需求直接规划归档。还要考虑 Glacier IR 的最短计费期限、小对象转换限制、转换请求与取回费用。
原文按当时区域单价估算 3 GB 对象的月存储费用约为 Standard 0.07 美元、Standard-IA 0.04 美元、Glacier IR 0.012 美元。这只是历史存储单价示例,并非全年小时级备份的总成本;累计保留量、重复上传、请求、取回、最短计费时间和区域都会影响实际账单。
容易踩到的五个问题
- 快照列表与文件变化要核对。 原文在触发完整快照后观察到集合快照文件减少,并留下校验文件;不能把这一现象当成所有版本的固定清理规则。创建成功后及时离机复制,不把唯一备份长期留在同一磁盘。
- 恢复默认优先级是 replica。 需要以快照为准时,明确使用
"priority":"snapshot",并核对副本状态,避免误解为完整覆盖已经发生。 - 快照是归档,不是可直接覆盖的段目录。 集合快照使用恢复 API;完整存储快照使用相应的启动恢复方式。不要解包到
/qdrant/storage后直接重启期待自动修复。 - 不要备份未完成的临时文件。 除排除
tmp/与临时扩展名外,还要等快照创建完成,再做大小与校验检查。 - IAM 角色生效可能有延迟。 原文观察到关联后约 10 至 20 秒内尚未获取凭据。自动化应有限重试
aws sts get-caller-identity并检查错误原因,而不是只依赖固定等待一定成功。
监控备份链路
至少监控三件事:
- 定时器是否执行。 用
systemctl status qdrant-backup.timer检查上次与下次触发,收集日志并对遗漏或失败告警。 - 最新备份是否合理。 比较远端最新对象的时间与大小。若无业务解释却突然缩小很多,应检查集合是否被清空或备份是否不完整。
- 能否恢复。 定期把备份恢复到非生产环境,比较点数并抽查载荷、向量与配置。原文建议每周演练,可根据业务要求调整。
流程的核心是定时创建、及时离机、按策略保留,以及持续恢复验证。S3 桶和 IAM 角色之外,还应保存恢复所需的配置与操作说明;训练语料、提示词和其他文件数据也要有各自的备份安排。