上一节的 Qdrant 集群已经能够提供查询,但还需要持续监控。Pod 反复重启、分片副本异常,或搜索延迟从 5 毫秒上升到 200 毫秒时,应由指标和告警尽早发现。本文依次配置指标采集、Grafana 展示、Prometheus 告警,并通过一次可控实验验证告警触发。
原文使用同一个三节点 k3s 与 Qdrant 集群,接入 kube-prometheus-stack,经 API 导入 Grafana 面板,定义五条 PrometheusRule,再缩容到一个副本触发其中一条。以下输出与截图来自原文测试。
原文测试环境:2026 年 5 月,Ubuntu 24.04.4 LTS、k3s v1.35.5、Qdrant 1.18.1、Qdrant Helm chart 1.18.0、kube-prometheus-stack chart 85.3.3(App Version v0.90.1)、Grafana 11.x。
Qdrant 的 /metrics 提供哪些指标
Qdrant 在 REST 端口 6333 的 /metrics 输出 Prometheus 格式指标。三 Pod 环境在负载下的示例如下:
curl -sS http://qdrant:6333/metrics -H "api-key: $KEY" | head -20

# HELP app_info information about qdrant server
app_info{name="qdrant",version="1.18.1"} 1

# HELP collections_total number of collections
collections_total 2

# HELP collections_vector_total total number of vectors in all collections
collections_vector_total 5280

# HELP cluster_peers_total total number of cluster peers
cluster_peers_total 3

# HELP cluster_term current cluster term
cluster_term 99

# HELP cluster_commit index of last committed operation
cluster_commit{peer_id="4561818375350355"} 247

# HELP rest_responses_total total number of responses
rest_responses_total{method="POST",
    endpoint="/collections/{collection_name}/points/query", status="200"} 11468
可以把监控重点分为四组:
| 类别 | 指标 | 用途 |
|---|---|---|
| 集群健康 | cluster_peers_total、cluster_term、cluster_pending_operations_total、cluster_voter |
观察 Raft 成员和共识进展 |
| 数据平面 | collection_points、collection_dead_replicas、collection_active_replicas_min、collection_running_optimizations |
检查分片副本与优化任务 |
| REST 流量 | rest_responses_total{status,endpoint}、rest_responses_duration_seconds_bucket |
请求量、错误率和延迟分布 |
| 资源 | memory_active_bytes、memory_allocated_bytes,以及 Kubernetes 的 CPU、RSS 指标 |
内存压力和 OOM 风险 |
延迟直方图 rest_responses_duration_seconds_bucket 很适合作为面板中心。按端点和状态区分后,可以分别计算 query、scroll 等调用的 p50、p95、p99,比一个全局平均延迟更有诊断价值。指标名称与标签应以实际版本输出为准。
安装 kube-prometheus-stack
该 chart 集成 Prometheus、Alertmanager、Grafana、Prometheus Operator、kube-state-metrics 与 node-exporter。先安装监控栈,再为 Qdrant 开启 ServiceMonitor,因为后者在创建资源时需要 ServiceMonitor CRD 已存在。
添加仓库,准备适合实验资源规模的 values 文件:
helm repo add prometheus-community \
    https://prometheus-community.github.io/helm-charts
helm repo update
下面示例减少资源与保留设置,以适配 4 GB 工作节点。原文提及配套仓库中的完整文件;此处保留正文给出的配置,不把未提供的外部文件假装成已包含。
# kps-values.yaml: lightweight kube-prometheus-stack
prometheus:
  prometheusSpec:
    # Discover ServiceMonitors from any namespace
    serviceMonitorSelectorNilUsesHelmValues: false
    podMonitorSelectorNilUsesHelmValues: false
    ruleSelectorNilUsesHelmValues: false
    retention: 2d
    resources:
      requests: {cpu: 200m, memory: 512Mi}
      limits:   {cpu: 800m, memory: 1Gi}
    storageSpec:
      volumeClaimTemplate:
        spec:
          storageClassName: local-path
          resources: {requests: {storage: 5Gi}}

grafana:
  adminPassword: cfg-grafana-2026
  persistence:
    enabled: true
    storageClassName: local-path
    size: 1Gi

alertmanager:
  enabled: true
  alertmanagerSpec:
    storage:
      volumeClaimTemplate:
        spec:
          storageClassName: local-path
          resources: {requests: {storage: 1Gi}}
三个 NilUsesHelmValues: false 设置决定相应选择器为空时,是否仍按 Helm release 标签筛选。要跨命名空间发现 ServiceMonitor、PodMonitor 和规则,还需要正确的 namespace selector;不能仅凭这三个布尔值就认为自动覆盖任何命名空间。生产中应明确限定允许选择的资源。
kubectl create namespace monitoring
helm install kps prometheus-community/kube-prometheus-stack \
    -n monitoring -f kps-values.yaml
等待 Prometheus、Alertmanager 和 Grafana Ready。原文中前两者各有两个容器,Grafana 有三个;具体数量由版本与 sidecar 配置决定。
kubectl get pods -n monitoring | grep -E "(prometheus|grafana|alertmanager|kube-state)"
alertmanager-kps-kube-prometheus-stack-alertmanager-0   2/2   Running   0   2m
kps-grafana-5859b7d8df-lwcdf                            3/3   Running   0   2m
kps-kube-prometheus-stack-operator-...                  1/1   Running   0   2m
kps-kube-state-metrics-...                              1/1   Running   0   2m
prometheus-kps-kube-prometheus-stack-prometheus-0       2/2   Running   0   2m
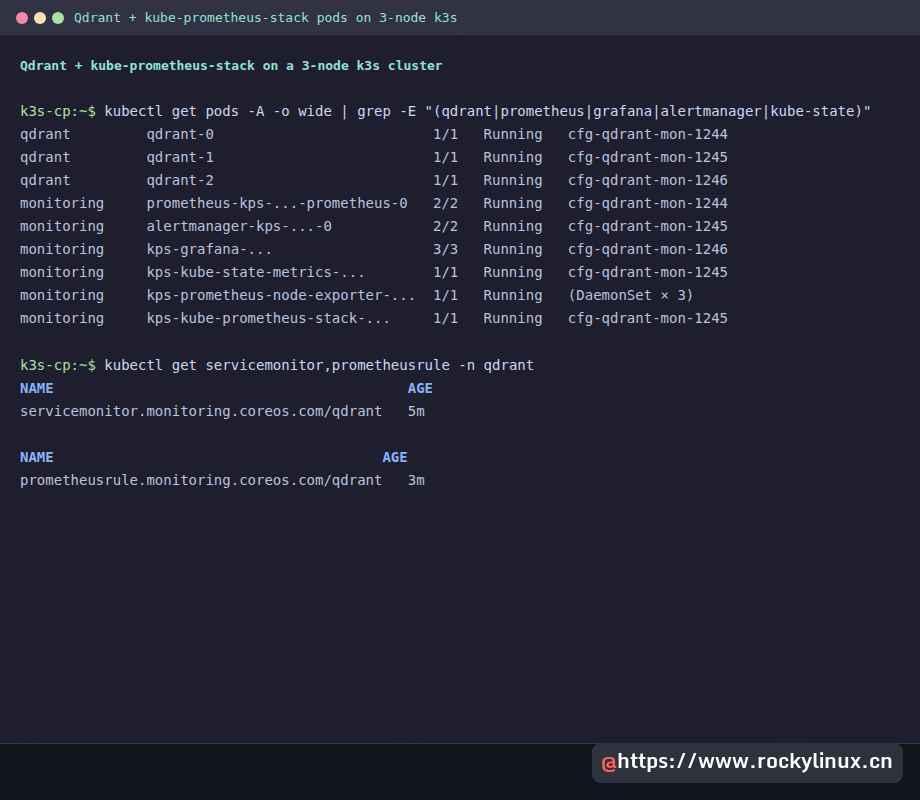
终端中可以同时查看 Qdrant 与监控栈的状态:
为 Qdrant 启用 ServiceMonitor
CRD 就绪后,更新 Qdrant values,启用监控。chart 会创建指向相应服务端点的 ServiceMonitor,再由 Operator 选择和转换为抓取配置:
# qdrant-values.yaml (same as the multi-node guide, plus one block at the bottom)
replicaCount: 3
image:
  tag: v1.18.1
cluster:
  enabled: true
podAntiAffinity:
  enabled: true
persistence:
  size: 3Gi
  storageClassName: local-path
apiKey: cfg-mon-key-2026

# Enable the ServiceMonitor
metrics:
  serviceMonitor:
    enabled: true
安装或升级 chart,确认资源已创建:
helm install qdrant qdrant/qdrant -n qdrant -f qdrant-values.yaml
# (or `helm upgrade` if Qdrant is already there from a previous step)

kubectl get servicemonitor,prometheusrule -n qdrant
NAME                                          AGE
servicemonitor.monitoring.coreos.com/qdrant   5m
原文采集间隔为 30 秒。可通过 Prometheus API 检查是否采集到全部三个 Pod:
kubectl port-forward -n monitoring \
    svc/kps-kube-prometheus-stack-prometheus 9090:9090 &

curl -s 'http://localhost:9090/api/v1/query?query=cluster_peers_total' | \
    jq -c '.data.result[] | {pod: .metric.pod, value: .value[1]}'
{"pod":"qdrant-1","value":"3"}
{"pod":"qdrant-2","value":"3"}
{"pod":"qdrant-0","value":"3"}
原始指标与 Prometheus 查询结果可以并排核对:
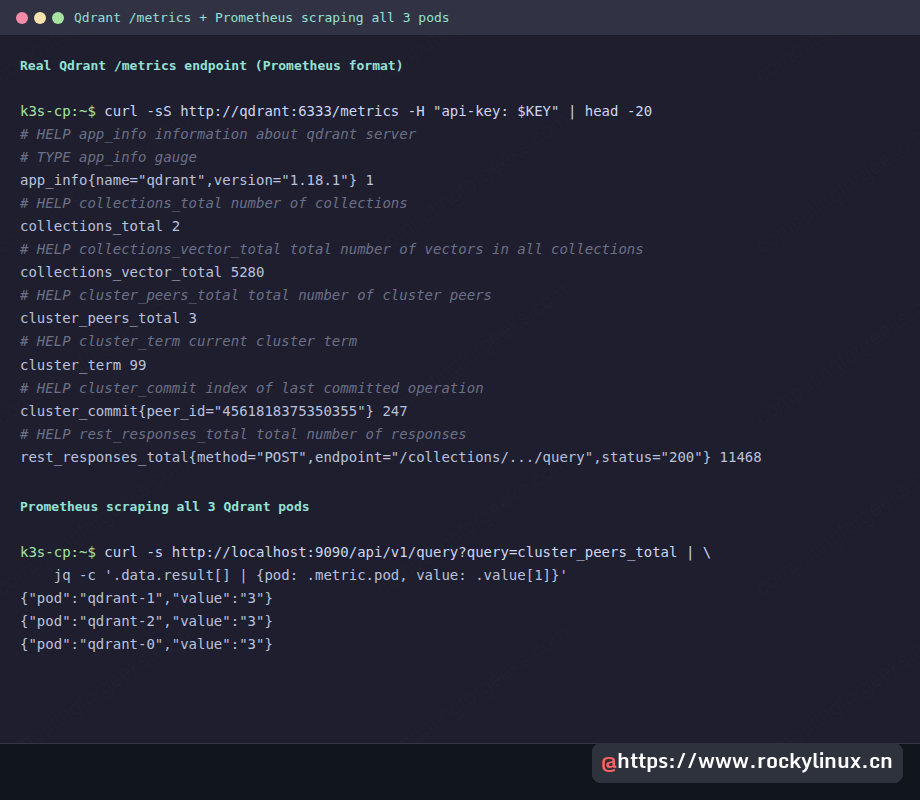
每个 Pod 独立报告 cluster_peers_total,健康的预期三节点环境应彼此一致。若结果少于三行或节点数不符,需要区分抓取失败、端点发现异常和共识状态变化,不能仅凭单项指标下结论。
通过 API 导入 Grafana 仪表板
一次性使用可以经 UI 导入,需版本管理、跨环境复用时则适合 API。流程是:准备使用占位 datasource UID 的 JSON,经 API 查询真实 Prometheus UID,替换后 POST 到 /api/dashboards/db。
#!/usr/bin/env bash
# provision-dashboard.sh
set -u
export KUBECONFIG=~/.kube_config

kubectl port-forward -n monitoring svc/kps-grafana 8080:80 &
PF=$!; trap 'kill $PF 2>/dev/null' EXIT
sleep 5

# Discover the Prometheus datasource UID
DS_UID=$(curl -sS -u admin:cfg-grafana-2026 \
    http://localhost:8080/api/datasources | \
    jq -r '.[] | select(.type=="prometheus") | .uid' | head -1)
echo "Prometheus DS UID: $DS_UID"

# Patch the JSON
sed "s/\"uid\": \"prometheus\"/\"uid\": \"${DS_UID}\"/g" \
    qdrant-dashboard.json > /tmp/dash-final.json

# Wrap and push
jq -n --slurpfile d /tmp/dash-final.json \
    '{dashboard: $d[0], overwrite: true, folderId: 0}' > /tmp/dash-import.json

curl -sS -u admin:cfg-grafana-2026 -X POST -H 'Content-Type: application/json' \
    http://localhost:8080/api/dashboards/db -d @/tmp/dash-import.json | jq .
原文面板 JSON 的完整版本在配套文件中,正文主要展示导入方式。其查询覆盖以下内容:
- 状态面板:
cluster_peers_total、cluster_term、collections_total、总向量数、待处理 Raft 操作与失效副本,用于快速判断健康。 - 请求速率:
sum(rate(rest_responses_total[2m])) by (status, pod),按 Pod 和响应状态比较吞吐。单 Pod 趋势明显偏离时值得排查。 - 延迟分位数:例如
histogram_quantile(0.95, sum(rate(rest_responses_duration_seconds_bucket{endpoint="/collections/{collection_name}/points/query"}[2m])) by (le))。将参数分别改为 0.50、0.95、0.99,计算对应分位数;标签必须与实际指标一致。 - 内存:按 Pod 展示
memory_active_bytes。 - 数据分布:观察
collection_points及其实际分片标签,检查布局是否均衡。跨副本求和时要避免把复制数据当成唯一点数。
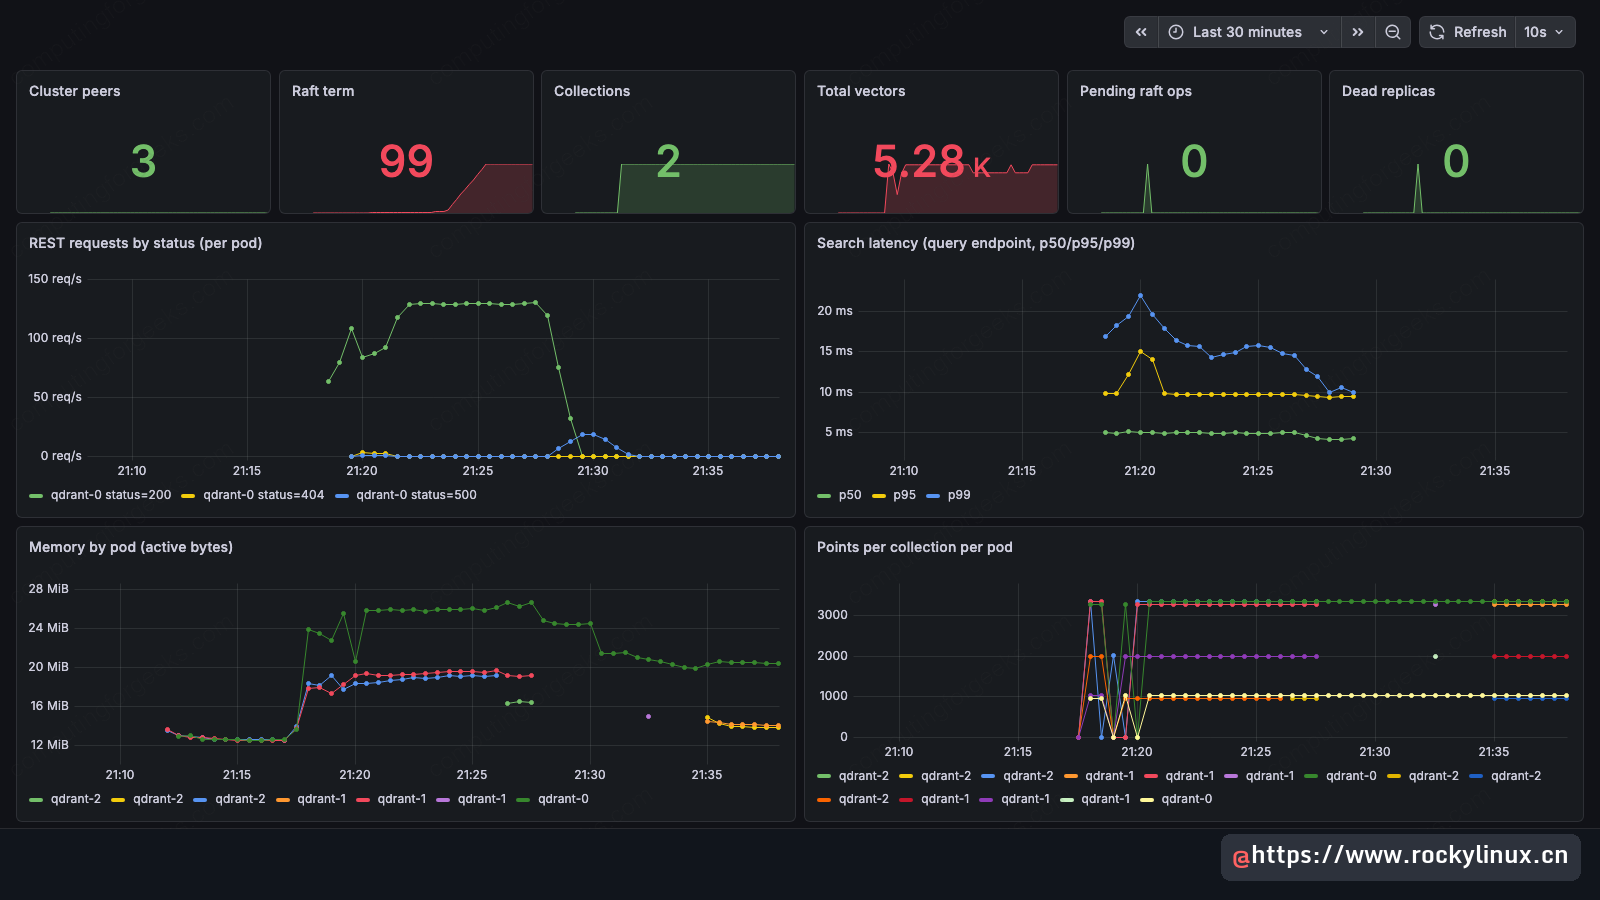
截图来自原文的持续 100 req/s 负载,集合含 5,000 个 BGE-small 嵌入。p99 约为 15 至 22 毫秒;此前故障演练后 Raft term 为 99,可见任期高并不必然意味着当前故障。原文此处写“4 分片乘 2 副本”,与上一节六分片示例不同,阅读面板应以该集合实际配置和标签为准。
定义告警规则
在 Qdrant 命名空间创建 PrometheusRule,确认 Operator 的资源和命名空间选择器能够发现它。下面的五条规则覆盖原文关心的健康与性能问题:
apiVersion: monitoring.coreos.com/v1
kind: PrometheusRule
metadata:
  name: qdrant
  namespace: qdrant
spec:
  groups:
    - name: qdrant.rules
      interval: 30s
      rules:
        # Fires when fewer than 3 scrape targets respond
        - alert: QdrantPeerCountBelowExpected
          expr: count(up{job="qdrant-headless"}) < 3
          for: 1m
          labels:  {severity: critical}
          annotations:
            summary: "Only {{ $value }} Qdrant peers responding (expected 3)"

        # Fires when a known target stops responding mid-flight
        - alert: QdrantTargetDown
          expr: up{job="qdrant-headless"} == 0
          for: 1m
          labels:  {severity: critical}

        - alert: QdrantHighSearchLatency
          expr: |
            histogram_quantile(0.95,
              sum(rate(rest_responses_duration_seconds_bucket{
                endpoint="/collections/{collection_name}/points/query"}[5m])
              ) by (le)
            ) > 0.1
          for: 3m
          labels:  {severity: warning}

        - alert: QdrantDeadReplicas
          expr: collection_dead_replicas > 0
          for: 2m
          labels:  {severity: critical}

        - alert: QdrantRaftBacklog
          expr: max(cluster_pending_operations_total) > 100
          for: 2m
labels: {severity: warning}前两条分别处理已知目标抓取失败,以及预期端点数量减少。QdrantTargetDown 对已发现目标的 up=0 生效;QdrantPeerCountBelowExpected 用来发现端点从服务发现中消失的情况。
规则边界: 当所有目标全部消失时,count(up{...}) 也可能成为空向量,单纯 < expected 未必触发。因此还应结合 absent(up{...})、工作负载期望副本数、Prometheus 自身存活与服务发现状态,覆盖“完全无数据”。这两条示例不能保证覆盖所有缺 Pod 场景。
通过缩容验证告警
应在隔离实验环境进行。将三节点有状态数据库缩到一个副本会失去 Raft 多数派,还可能影响读写与副本健康,不是一个无害的监控开关。原文用这一操作让两个 Pod 及其服务端点消失,以触发数量告警:
kubectl scale statefulset qdrant -n qdrant --replicas=1
# statefulset.apps/qdrant scaled

# Wait for the 1m for: clause + ~30s scrape interval
sleep 95

curl -sS http://localhost:9090/api/v1/alerts | \
    jq '.data.alerts[] | select(.labels.alertname | startswith("Qdrant"))'
{
  "labels": {
    "alertname": "QdrantPeerCountBelowExpected",
    "severity":  "critical"
  },
  "annotations": {
    "summary": "Only 1 Qdrant peers responding (expected 3)"
  },
  "state":    "firing",
  "value":    "1e+00",
  "activeAt": "2026-05-26T18:40:00Z"
}
原文规则设置持续一分钟后触发,下图显示它从 pending 变为 firing:
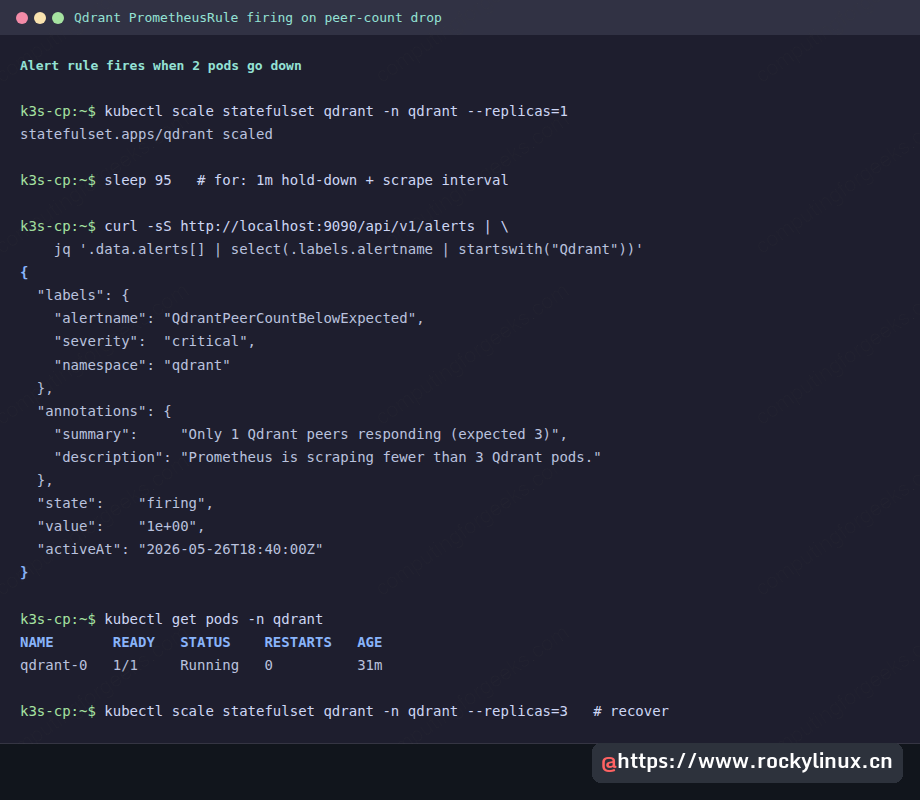
恢复副本数,再观察告警是否清除、节点与分片是否重新健康:
kubectl scale statefulset qdrant -n qdrant --replicas=3
# Wait for pods, then re-check; alert moves to "inactive"
将告警路由到有人处理的渠道
Prometheus 中出现 firing 还不够,需要 Alertmanager 把通知发送到实际有人查看的渠道。下面是通过 AlertmanagerConfig 接入 Slack 的示例,也可以使用 PagerDuty 等接收器:
apiVersion: monitoring.coreos.com/v1alpha1
kind: AlertmanagerConfig
metadata:
  name: qdrant-slack
  namespace: monitoring
spec:
  route:
    receiver: slack
    groupBy: [alertname, severity]
    matchers:
      - name: severity
        matchType: "="
        value: critical
  receivers:
    - name: slack
      slackConfigs:
        - apiURL:
            name: slack-webhook-secret
            key:  url
          channel: "#cfg-oncall"
          title:  '{{ template "slack.title" . }}'
          text:   '{{ template "slack.text"  . }}'
把 webhook 地址保存在名为 slack-webhook-secret 的 Kubernetes Secret 中,键名为 url。还要确认 Secret 命名空间、Alertmanager 的 alertmanagerConfigSelector 与 namespace selector、RBAC 和路由匹配条件正确。不能仅创建资源就假定已自动启用;验收应包括通知确实送达和恢复通知行为。
容易踩到的问题
- 先准备 ServiceMonitor CRD。 反向安装会遇到
no matches for kind "ServiceMonitor" in version "monitoring.coreos.com/v1"。 - 同时核对资源与命名空间选择器。
serviceMonitorSelectorNilUsesHelmValues: false及对应设置影响标签选择,但跨 namespace 还取决于 namespace selector。 up == 0不能单独覆盖目标被删除。 端点消失后该时间序列可能不再存在;数量比较覆盖部分丢失,还需 absent 或其他独立期望值覆盖全部缺失。- Grafana datasource UID 需要稳定管理。 自动生成的 UID 不应跨环境硬编码;可以按示例动态发现,或在数据源预配置中明确指定稳定 UID。
- 预置规则需要适配 k3s。 某些控制平面组件嵌入 k3s,默认抓取对象不同,可能出现
KubeControllerManagerDown、KubeSchedulerDown等告警。应调整采集与规则,或对已确认不适用的项做有范围的静默,避免长期屏蔽真实异常。
按优先级组织面板
面板不必把所有指标塞在第一页。可以分成三行:
- 集群健康。 节点数、复制状态、失效副本等异常应最先看到。
- 业务流量。 按状态的请求速率,以及 p50、p95、p99,说明调用方实际感受到的服务质量。
- 资源与容量。 内存、每 Pod 数据量等帮助判断接下来是否会失稳。
分片迁移、优化任务、快照与硬件 I/O 可放在诊断面板中,按具体问题深入查看。
原文流程以 30 秒采集间隔接入指标并定义五条规则,实际演示触发的是缩容告警;不能据此声称五条均已分别验证。生产验收应逐条检查规则、通知与恢复链路,并定期演练。再结合每个节点的 node_exporter,把 CPU、内存和磁盘指标放在同一监控体系中。