单个 Qdrant Pod 可以处理不少请求,但仍有单点故障风险:磁盘损坏、OOM 或宿主机崩溃都可能使服务中断。与其他有状态数据库类似,可以通过多个节点、分片副本和流量调度提高可用性。Qdrant 的官方 Helm chart 负责创建 StatefulSet、无头服务和 PVC,简化 Kubernetes 部署。
本文使用三台 Ubuntu 24.04 虚拟机搭建 k3s,经官方 chart 部署三节点 Qdrant,再用两个实验观察可用性:持续查询时强制删除一个 Pod,以及持续查询时滚动更新镜像。原文两次实验都没有观测到非 2xx 响应;这仅代表该测试范围,并非对所有故障模式的零中断保证。
原文测试环境:2026 年 5 月,Ubuntu 24.04.4 LTS、k3s v1.35.5、Qdrant 1.18.1、Helm chart v1.18.0、qdrant-client 1.18.0、fastembed 0.8.0。以下输出与耗时均来自原文。
多节点集群能带来什么
相比单 Pod,集群有三项变化。第一,Raft 共识维护集合、分片归属和复制设置等元数据。第二,数据分片允许一个集合分散到多台主机。第三,复制因子大于 1 时,每个分片有多个副本,单个副本失效后仍可能由其他副本提供数据。
三节点是常见起点:两节点虽然能保存副本,但其中一个不可用时,剩余节点无法形成多数派;三节点可在失去一个节点后保有多数派。五节点能容忍更多共识节点故障,但其成本取决于资源和复制设置,并不是节点数增加就必然把全部数据翻倍。
| 设置 | 作用 | 常见起点 |
|---|---|---|
shard_number |
集合分片数量,影响并行度与管理开销 | 根据数据规模与节点数规划,本文为 6 |
replication_factor |
每个分片的副本数 | 本文为 2;更高值增加存储与写入成本 |
write_consistency_factor |
写入成功所需的副本确认数量 | 按一致性和故障时写可用性取舍 |
技术说明: 副本数为 3 不代表三节点集群失去两台仍能正常提供所有服务,还受 Raft 多数派、健康副本、路由和写一致性要求约束。将写确认数设为全部副本,也会在副本失效时降低写可用性;它不是一个无需权衡的“最强一致性”开关。
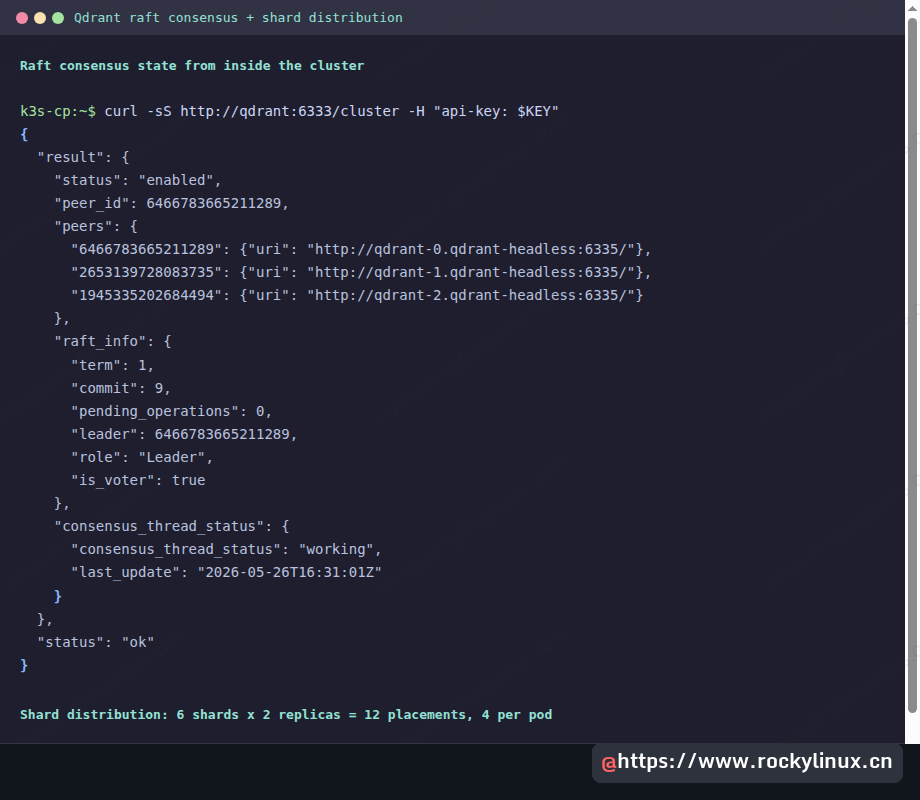
示例设置 shard_number=6、replication_factor=2,共 12 个分片副本;原文恰好分布为每个节点 4 个。
准备 Kubernetes 集群
需要三个 Ready 节点和可用的默认 StorageClass。原文使用三台各有 4 vCPU、4 GB 内存和 20 GB 磁盘的 Ubuntu 24.04 虚拟机。EKS、GKE 或 kubeadm 集群也可以,但存储和负载均衡需要按平台配置。
在控制平面节点执行:
curl -sfL https://get.k3s.io | \
  sudo INSTALL_K3S_EXEC='server --cluster-init --disable=traefik' sh -
sudo cat /var/lib/rancher/k3s/server/node-token
在各工作节点设置控制平面的 CP_IP 与上一步的 TOKEN,再执行:
curl -sfL https://get.k3s.io | \
  sudo K3S_URL=https://${CP_IP}:6443 K3S_TOKEN=${TOKEN} sh -
返回控制平面检查:
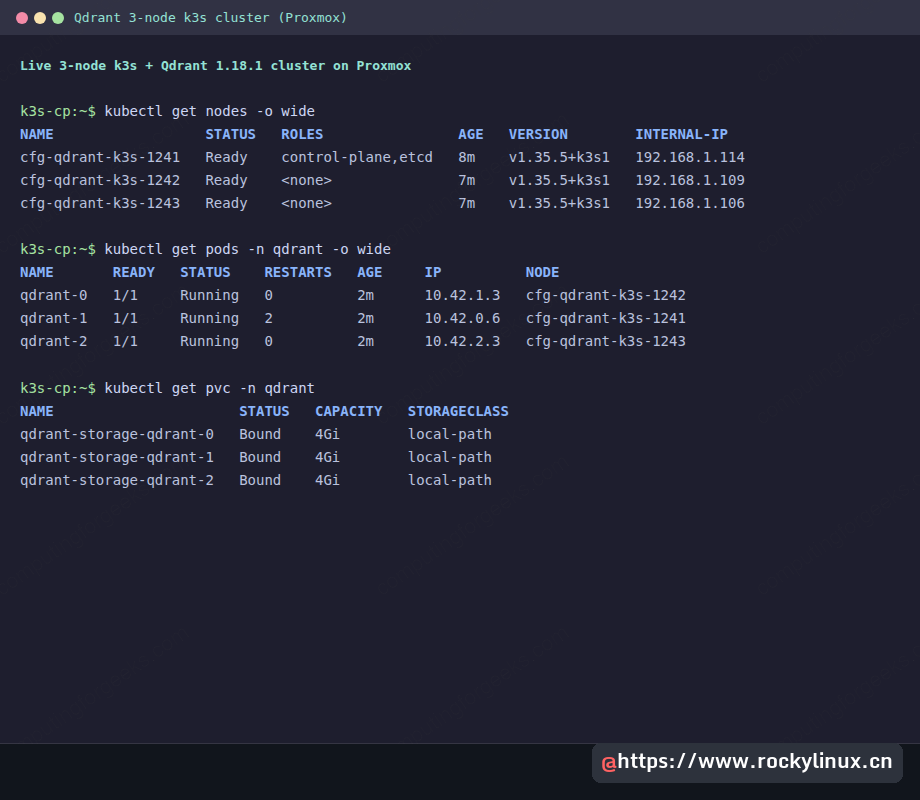
sudo kubectl get nodes -o wide
NAME                  STATUS   ROLES                AGE   VERSION
cfg-qdrant-k3s-1241   Ready    control-plane,etcd   8m    v1.35.5+k3s1
cfg-qdrant-k3s-1242   Ready    <none>               7m    v1.35.5+k3s1
cfg-qdrant-k3s-1243   Ready    <none>               7m    v1.35.5+k3s1
k3s 默认提供 local-path StorageClass 与 ServiceLB(Klipper),可用于实验。EKS 可以使用 EBS CSI 驱动与 gp3 StorageClass;对外服务按需求选择云负载均衡器。ALB 主要用于 HTTP/HTTPS Ingress,不能直接视作所有原生 gRPC 或 TCP 暴露方式的通用替代。
通过 Helm 部署 Qdrant
先安装 Helm 并添加官方 chart 仓库。chart 版本与应用镜像版本分别管理,部署前应检查具体 chart 的默认镜像与支持设置。
curl -sfL https://raw.githubusercontent.com/helm/helm/main/scripts/get-helm-3 \
  | sudo bash
helm repo add qdrant https://qdrant.github.io/qdrant-helm
helm repo update
示例通过 values 文件覆盖为三副本集群:
# values.yaml
replicaCount: 3
image:
  tag: v1.18.1

# Spread pods across nodes
podAntiAffinity:
  enabled: true

# Cluster mode: enables raft consensus + sharding
cluster:
  enabled: true

persistence:
  size: 4Gi
  storageClassName: local-path

# Strong api-key; in prod use a secretRef instead of an inline value
apiKey: cfg-lab-cluster-key-2026

resources:
  requests: {cpu: 250m, memory: 512Mi}
  limits:   {cpu: 1000m, memory: 1Gi}
在独立命名空间安装:
kubectl create namespace qdrant
helm install qdrant qdrant/qdrant -n qdrant -f values.yaml
chart 创建带稳定身份的 StatefulSet Pod:qdrant-0、qdrant-1、qdrant-2;普通 ClusterIP 服务为客户端提供统一入口,无头服务为节点提供稳定 DNS,例如 qdrant-0.qdrant-headless。节点通过这些地址发现彼此并参与 Raft。
等待三个 Pod 就绪:
kubectl get pods -n qdrant -o wide
NAME       READY   STATUS    RESTARTS   AGE   IP          NODE
qdrant-0   1/1     Running   0          58s   10.42.1.3   cfg-qdrant-k3s-1242
qdrant-1   1/1     Running   2          58s   10.42.0.6   cfg-qdrant-k3s-1241
qdrant-2   1/1     Running   0          58s   10.42.2.3   cfg-qdrant-k3s-1243

kubectl get pvc -n qdrant
NAME                      STATUS   CAPACITY   STORAGECLASS
qdrant-storage-qdrant-0   Bound    4Gi        local-path
qdrant-storage-qdrant-1   Bound    4Gi        local-path
qdrant-storage-qdrant-2   Bound    4Gi        local-path
原文首次启动时 qdrant-1 出现了两次重启,原因是后加入节点遇到首节点 API 已启动而共识尚未完成的短暂窗口。可以观察启动日志与最终 Ready 状态,但不能把持续 CrashLoopBackOff 一概视作正常。
验证 Raft 集群已经形成
三个 Pod 都处于 Running,不代表它们彼此识别。通过 /cluster 查看真正的共识状态:
kubectl port-forward -n qdrant svc/qdrant 6333:6333 &
curl -sS http://localhost:6333/cluster \
    -H "api-key: cfg-lab-cluster-key-2026" | jq
响应会显示节点列表、当前任期、提交索引与领导节点 ID:
{
  "result": {
    "status": "enabled",
    "peer_id": 6466783665211289,
    "peers": {
      "6466783665211289": {"uri": "http://qdrant-0.qdrant-headless:6335/"},
      "2653139728083735": {"uri": "http://qdrant-1.qdrant-headless:6335/"},
      "1945335202684494": {"uri": "http://qdrant-2.qdrant-headless:6335/"}
    },
    "raft_info": {
      "term": 1,
      "commit": 9,
      "leader": 6466783665211289,
      "role": "Leader",
      "is_voter": true
    },
    "consensus_thread_status": {
      "consensus_thread_status": "working",
      "last_update": "2026-05-26T16:31:01Z"
    }
  },
  "status": "ok"
}
原文中出现三个 peer,term 为 1,没有待处理操作,共识线程状态为 working。实际应结合稳定性与日志判断,不能把 term 大于某个固定数字当成故障的充分条件;如果状态 disabled、节点缺失、待处理操作长期堆积或任期频繁变化,则需要排查。
创建分片并复制的集合
shard_number 与 replication_factor 共同决定分布式数据布局。分片在单节点上也有意义,只是不能在一台机器上获得跨节点容错。
from qdrant_client import QdrantClient, models

client = QdrantClient(url="http://localhost:6333",
                      api_key="cfg-lab-cluster-key-2026")

client.create_collection(
    "articles",
    vectors_config=models.VectorParams(size=384, distance=models.Distance.COSINE),
    shard_number=6,
    replication_factor=2,
    write_consistency_factor=2,   # majority write: every replica acks
)
向集合写入 5,000 个 BGE-small 嵌入后,逐个 Pod 查看本地分片分布。原文提及的加载器属于配套文件,下面主要展示分布检查:
for POD in qdrant-0 qdrant-1 qdrant-2; do
  IP=$(kubectl get pod -n qdrant $POD -o jsonpath='{.status.podIP}')
  curl -sS "http://${IP}:6333/collections/articles/cluster" \
    -H "api-key: cfg-lab-cluster-key-2026" \
    | jq -c '{peer_id: .result.peer_id,
              local_shards: [.result.local_shards[].shard_id]}'
done
原文各分片均出现在两个不同 peer 上:
qdrant-0 local: shards [1, 2, 4, 5]   peer 6466783665211289
qdrant-1 local: shards [0, 1, 3, 4]   peer 2653139728083735
qdrant-2 local: shards [0, 2, 3, 5]   peer 1945335202684494

  shard 0: qdrant-1, qdrant-2
  shard 1: qdrant-0, qdrant-1
  shard 2: qdrant-0, qdrant-2
  shard 3: qdrant-1, qdrant-2
  shard 4: qdrant-0, qdrant-1
  shard 5: qdrant-0, qdrant-2
这使单个 peer 消失后仍有另一份分片数据可访问。查询发往任一健康节点时,由 Qdrant 自身执行节点间路由;无头服务负责发现和稳定地址,并不自行理解分片。
故障实验:持续查询时强制删除一个 Pod
复制因子为 2 的目标之一,是单个副本失效后继续读取。可以在隔离测试环境中运行查询循环,再使用 --grace-period=0 --force 强制删除一个 Pod。该操作会中断进程,不应直接在未知生产环境照做。
# Run 60 queries in a tight loop, ~0.2s apart
for i in $(seq 1 60); do
    curl -sS -o /dev/null -w '%{http_code} ' --max-time 5 \
        http://localhost:6333/collections/articles/points/query \
        -H "api-key: $KEY" -H "Content-Type: application/json" -d "$BODY"
    sleep 0.2
done &

# In parallel: kill qdrant-2 hard
kubectl delete pod qdrant-2 -n qdrant --grace-period=0 --force
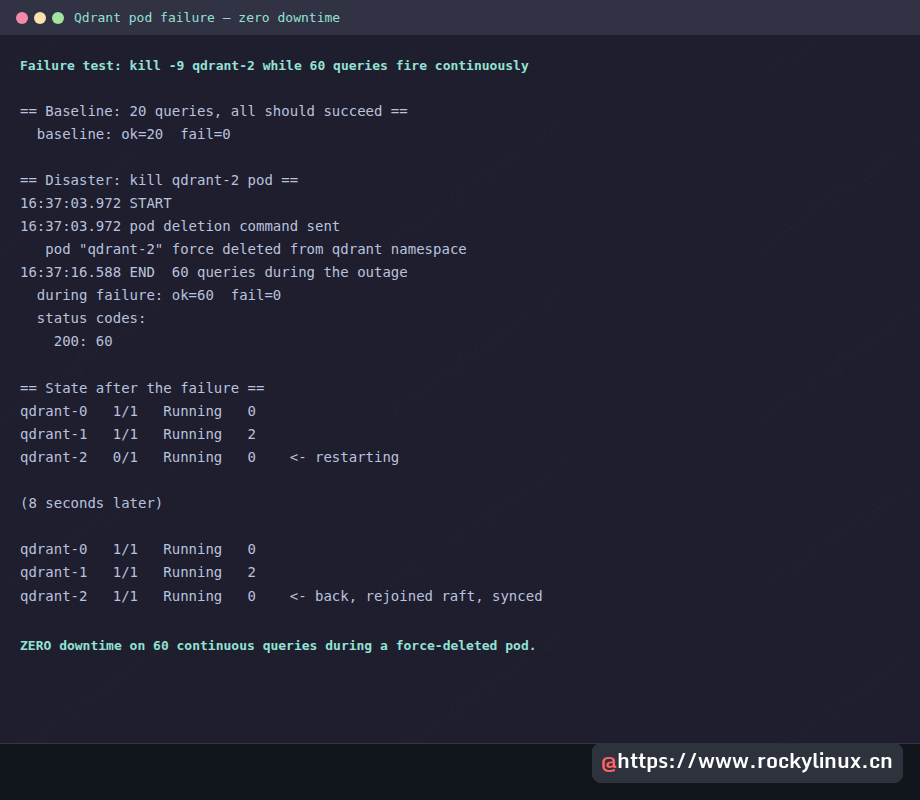
原文在故障窗口记录到 60 次成功查询,零失败:
== Disaster: kill qdrant-2 pod ==
16:37:03.972 START
16:37:03.972 pod deletion command sent
   pod "qdrant-2" force deleted from qdrant namespace
16:37:16.588 END  60 queries during the outage
  during failure: ok=60  fail=0
  status codes: 200: 60

== State after the failure ==
qdrant-0   1/1   Running   0
qdrant-1   1/1   Running   2
qdrant-2   0/1   Running   0    # restarting, raft re-joining
(8s later)
qdrant-2   1/1   Running   0    # back, shards re-synced
StatefulSet 在约 8 秒后重建 qdrant-2,重新挂载原 PVC,节点以 Follower 身份加入并同步分片。此时其他两个 Pod 继续提供查询。该实验依赖剩余副本与原存储仍可用,不等同于永久丢失宿主机的测试。
若从集群外通过 kubectl port-forward 测试,结果可能不同:隧道绑定某一个具体 Pod,该 Pod 被删除时隧道会断开,出现 connection refused。生产入口应使用正确配置的 Service 与负载均衡或 Ingress;集群内循环更适合观察分片副本本身的行为。
持续查询下的滚动升级
StatefulSet 通常按顺序逐个更新,等待当前 Pod Ready 后再处理下一个。技术上,OrderedReady 是 Pod 管理策略,滚动更新由相应的更新策略控制。结合足够的健康副本,可以降低升级中断风险,但还要检查版本兼容性、探针、连接重试和写一致性。
先启动集群内的持续查询:
kubectl run -n qdrant query-loop --image=curlimages/curl --restart=Never -- \
  sh -c '
    end=$(($(date +%s) + 600))
    while [ $(date +%s) -lt $end ]; do
      code=$(curl -sS -o /dev/null -w "%{http_code}" --max-time 5 \
        http://qdrant:6333/collections/articles \
        -H "api-key: cfg-lab-cluster-key-2026")
      echo "$(date "+%H:%M:%S") $code"
      sleep 0.5
    done
  '

# Tail the logs in another shell
kubectl logs -n qdrant -f query-loop > /tmp/loop.log &
再触发镜像更新:
helm upgrade qdrant qdrant/qdrant -n qdrant --reuse-values \
    --set image.tag=v1.18.0
kubectl rollout status statefulset/qdrant -n qdrant
原文镜像已缓存,每个 Pod 从终止、启动到重新加入与 Ready 约 21 秒,三个合计约 64 秒。窗口内记录的 128 次查询均返回 HTTP 200:
=== Results ===
Total queries: 128
HTTP 200    : 128
Non-200 codes: (none)

=== Image now: docker.io/qdrant/qdrant:v1.18.0 ===
qdrant-0   1/1   Running   0   21s   cfg-qdrant-k3s-1242
qdrant-1   1/1   Running   0   38s   cfg-qdrant-k3s-1241
qdrant-2   1/1   Running   0   55s   cfg-qdrant-k3s-1243
下面的终端同时显示查询循环与 rollout,便于对照验证:
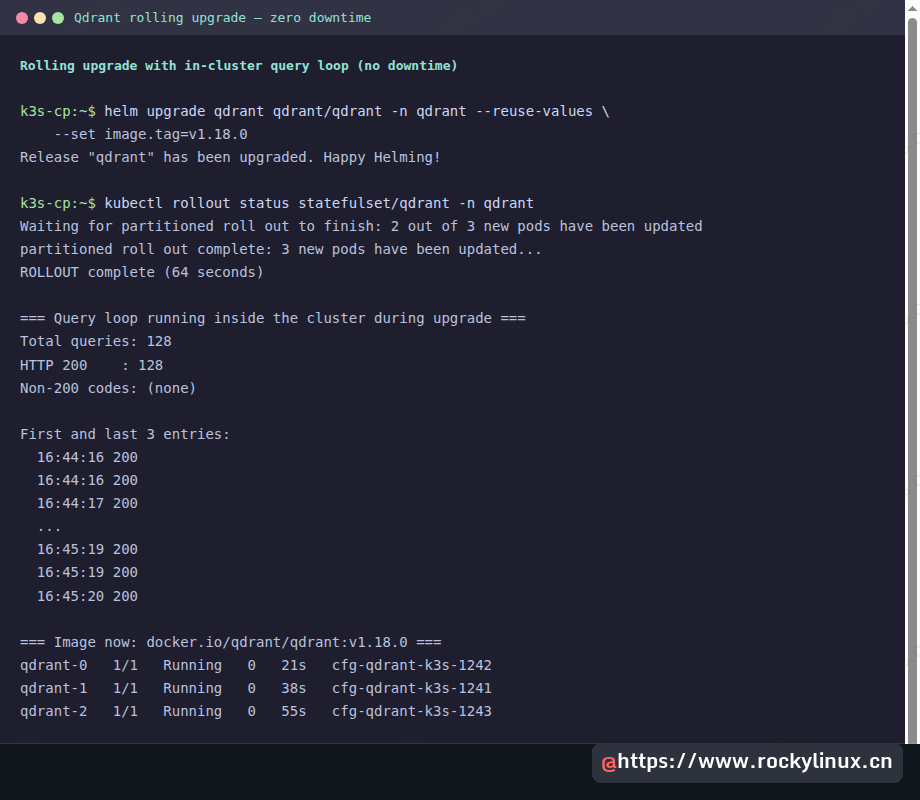
PVC 在升级后复用,稳定 Pod 身份有助于恢复原节点数据。不能直接把改回旧镜像标签当成普遍安全的数据库回滚。 降级前必须确认存储格式与版本兼容,必要时使用已验证备份恢复;重新加入也仍需执行共识与同步流程。
扩容节点与迁移分片
增加 replicaCount 后,StatefulSet 逐个添加 Pod。新 Pod 获取自己的 PVC,加入共识组,可接受后续分片布局:
helm upgrade qdrant qdrant/qdrant -n qdrant --reuse-values \
    --set replicaCount=5
kubectl rollout status statefulset/qdrant -n qdrant
已有分片不会仅因增加 peer 就自动均衡到新节点。可以通过 /collections/{name}/cluster 的 move_shard 操作复制分片、等待同步,再移除旧位置。大分片迁移会占用网络、磁盘和 CPU,建议安排在可控窗口并观察查询影响。
缩容前必须先迁走待移除节点上的分片,并按 Qdrant 的节点移除流程处理成员关系,再调整 StatefulSet。仅降低 replicaCount 不会自动完成数据迁移;丢失最后一个有效分片副本就可能造成数据丢失。
容易踩到的五个问题
- 镜像未必带 Shell 或 curl。 原文镜像中
kubectl exec ... -- curl报可执行文件不存在。可使用独立curlimages/curl测试 Pod,或在适当场景使用 port-forward,不要假设每个镜像都包含调试工具。 - port-forward 绑定具体 Pod。 其连接中断不一定说明集群所有副本失效,真正的高可用测试应覆盖生产入口。
- 首次引导可能出现短暂重启。 原文第二节点重启两次后恢复;若重启持续,应检查日志、DNS、端口和共识状态。
- 新增 peer 不会自动搬走已有分片。 需要显式迁移并关注迁移开销。
- local-path PVC 绑定宿主节点。 宿主永久失效后,Pod 可能因原卷不可访问而 Pending。云块存储的重挂载通常受可用区等拓扑约束;裸金属可评估 Longhorn、OpenEBS 或 Rook-Ceph 等方案,并验证其故障边界。
从实验环境走向生产
在此基础上还需完成三件事:
- 为入口配置 TLS。 使用支持所需 REST/gRPC 流量的 Ingress 或 LoadBalancer,并按需求结合 cert-manager。API 密钥不应跨公网明文传输。
- 选择适合故障模型的存储。
local-path适合实验;生产应评估 EBS、PD 或自建存储的重挂载、可用区、性能与故障恢复能力。 - 把快照流程接入 CronJob。 分布式快照捕获各节点持有的数据,需要按节点和分片覆盖,保存必要的对象存储凭据与恢复记录,不能只对随机一个 Service 后端取一次快照。
强制删除与滚动升级实验可以作为后续回归测试的一部分,在隔离环境中于 chart、Kubernetes 或拓扑变更后重复执行。同时应加入真实入口、写入、一致性与持久卷故障测试,才能覆盖当前生产部署的关键风险。