很多人只熟练掌握 grep、awk、sed 中的一个,然后拿它硬套所有任务。于是本来用 cut 零点几秒就能完成的取列操作,最后写成了一段复杂的 sed。我们在一份 200 万行访问日志上分别计时:提取客户端 IP 列时,cut 用时 0.18 秒,awk 0.55 秒,sed 2.8 秒,grep -o 约 10 秒。
本文说明三种工具各自适合什么任务,所有示例都基于先创建的三个样本文件,内容包括 grep 模式匹配、awk 取列与汇总、sed 流式编辑、管道组合、mawk 与 gawk 差异以及性能测试。全部命令于 2026 年 10 月在 Ubuntu 26.04 上运行,版本为 GNU grep 3.12、GNU sed 4.9、gawk 5.3.2 和 mawk 1.3.4。
按任务选择 grep、awk 或 sed
应按你向文本提出的问题选工具,而不是按最熟悉哪个来选。三者在各自领域都快速且易读,但在另外两种任务上会变得笨拙,因为它们围绕不同的数据模型设计:grep 回答“哪些行匹配”,awk 回答“匹配行中的第 3 个字段是什么、求和后是多少”,sed 回答“文本流经过时如何改写”。当任务同时需要两类答案时,一条短管道通常胜过在单一工具里写一条“聪明”的命令。
| 工具 | 最适合 | 输入模型 | 典型输出 | 何时改用其他工具 |
|---|---|---|---|---|
| grep | 查找模式匹配的行 | 行 | 匹配行、计数、文件名 | 需要取列或求和 |
| awk | 列、条件、汇总、分组 | 拆成字段的记录 | 计算或重排后的数据 | 任务只是一次普通替换 |
| sed | 查找替换、删除或插入行 | 行 | 编辑后的文本 | 需要算术或逐字段逻辑 |
最后一列比第一列更重要。grep 可以用 -o 提取,sed 可以用捕获组打印字段,awk 可以用 gsub() 替换,但这些都属于慢或别扭的路径。后文基准测试中,grep -o 为一项 awk 0.55 秒即可完成的任务花了 10 秒,因此文件变大后,选错工具不只是风格问题。
创建样本文件
所有示例都使用三个文件:Apache 风格访问日志、员工 CSV 和 INI 配置。IP 来自文档保留网段和私有网段,不指向真实主机。先创建临时目录,因为后文有命令会原地修改文件。
mkdir -p ~/textlab && cd ~/textlab先创建访问日志。这里使用 printf 和逐行引号参数,而不是 heredoc,因为从网页复制的 heredoc 很可能在结束标记带上多余空格而失效。单引号还能阻止 shell 展开日志行中的内容。
printf '%s\n' \
'203.0.113.10 - admin [17/Oct/2026:10:15:32 +0000] "GET /dashboard HTTP/1.1" 200 5432' \
'198.51.100.55 - - [17/Oct/2026:10:15:33 +0000] "POST /api/login HTTP/1.1" 401 128' \
'203.0.113.10 - admin [17/Oct/2026:10:15:34 +0000] "GET /api/users HTTP/1.1" 200 2048' \
'10.0.1.22 - - [17/Oct/2026:10:15:35 +0000] "GET /images/logo.png HTTP/1.1" 304 0' \
'198.51.100.55 - - [17/Oct/2026:10:15:36 +0000] "GET /admin/config HTTP/1.1" 403 256' \
'203.0.113.10 - admin [17/Oct/2026:10:15:37 +0000] "GET /api/reports HTTP/1.1" 200 8192' \
'10.0.1.22 - - [17/Oct/2026:10:15:38 +0000] "DELETE /api/users/5 HTTP/1.1" 500 512' \
'198.51.100.55 - - [17/Oct/2026:10:15:39 +0000] "GET /dashboard HTTP/1.1" 200 5432' > access.log
接着创建员工 CSV。第一行是表头,多个 awk 示例会故意跳过它,以便观察有表头和无表头时的差异。
printf '%s\n' \
'id,name,department,salary,city' \
'1,Alice Johnson,Engineering,95000,Portland' \
'2,Bob Smith,Marketing,72000,Seattle' \
'3,Carol Davis,Engineering,102000,Portland' \
'4,Dan Wilson,Sales,68000,Denver' \
'5,Eve Martinez,Engineering,98000,Seattle' \
'6,Frank Brown,Marketing,75000,Portland' \
'7,Grace Lee,Sales,71000,Denver' \
'8,Hank Taylor,Engineering,110000,Seattle' > employees.csv
配置文件包含三个由空行分隔的段,这是服务器上最常见的 INI 结构。
printf '%s\n' \
'[database]' 'host = 10.0.1.100' 'port = 5432' 'name = appdb' 'user = appuser' 'password = ChangeMe123' '' \
'[redis]' 'host = 10.0.1.101' 'port = 6379' 'maxmemory = 256mb' '' \
'[app]' 'debug = false' 'workers = 4' 'log_level = info' 'secret_key = replace-me' > config.ini
继续之前,确认三个文件存在且行数正确。
wc -l access.log employees.csv config.ini应得到 8、9、17 行。如果数字不对,通常粘贴时丢了引号,应删除该文件并重新粘贴对应代码块。本文所有输出都假定样本完全一致,因为多出一行就会改变后面 sed 示例打印的行号。
   8 access.log
   9 employees.csv
  17 config.ini
  34 total
文件就绪后,后续每个输出块都应与你看到的结果一致。
检查当前 awk 实现
在 Ubuntu 上,awk 是由 update-alternatives 管理的符号链接,不一定指向 GNU awk。mawk 是 Ubuntu 标为必需的包,因此最小镜像或容器可能只有 mawk。我们的 Ubuntu 26.04 服务器还安装了 gawk(server seed 通过 bcache-tools 拉入),alternatives 优先级为 gawk 10、mawk 5。
readlink -f "$(command -v awk)"在本机虚拟机上,链接指向 gawk。
/usr/bin/gawk这会在本文三个地方产生影响。
-
group-by 输出顺序不同
-
错误字段分隔符会产生不同报错
-
所有计时任务中 mawk 都不慢于 gawk
如果希望各处行为一致,可执行 sudo apt install gawk 安装,并在脚本中直接调用 gawk,避免依赖主机默认链接。gensub()、asort()、--csv、PROCINFO 等 GNU 专有特性在 mawk 中不存在,使用它们的脚本一旦进入最小容器镜像就会失败。有些失败很明确,用 gensub() 最容易验证。
mawk -F, 'NR>1 {print gensub(/ /, ".", "g", $2)}' employees.csvmawk 尚未读取输入就以状态 2 退出,而同一程序在 gawk 下会输出 Alice.Johnson、Bob.Smith 等结果。
mawk: line 2: function gensub never defined更糟的是有些特性会静默失败;后文 group-by 示例中的 PROCINFO 就是如此。
用 grep 查找文本
grep 逐行读取并打印所有匹配行。在这个任务上它是三者中最快的,因为根本不需要拆分字段;只要问题形式是“内容是否存在、在哪里”,就应先用它。只判断是或否时它还会提前停止(grep -q),所以 shell 脚本常用它作为 if 条件。GNU grep 手册记录了全部参数,下文覆盖日常使用中的大多数;本站在 grep 速查中也有更完整的一页参考。
执行基本搜索
普通搜索会打印任何位置包含模式的完整行,这既是优点,也是接下来会看到的陷阱。
grep "admin" access.log管理员用户有三次请求,按理应出现三行,实际却返回四行。
203.0.113.10 - admin [17/Oct/2026:10:15:32 +0000] "GET /dashboard HTTP/1.1" 200 5432
203.0.113.10 - admin [17/Oct/2026:10:15:34 +0000] "GET /api/users HTTP/1.1" 200 2048
198.51.100.55 - - [17/Oct/2026:10:15:36 +0000] "GET /admin/config HTTP/1.1" 403 256
203.0.113.10 - admin [17/Oct/2026:10:15:37 +0000] "GET /api/reports HTTP/1.1" 200 8192
第三行匹配的是 URL /admin/config,不是用户字段。grep 不知道“列”的概念,因此当词语可能出现在多个字段中时,要么把模式收紧为带空格的 " admin ",要么改用 awk 直接测试字段。真实日志中,这是 grep 计数偏高的最常见原因。
使用忽略大小写、反向匹配与计数
-i 忽略大小写,因此小写模式也能找到 GET 请求。
grep -i "get" access.log八行中有六行是 GET;尽管日志使用方法名大写,-i 仍然全部命中。当不同来源的日志大小写不一致时,这能省去手写 [Gg][Ee][Tt] 的麻烦。
203.0.113.10 - admin [17/Oct/2026:10:15:32 +0000] "GET /dashboard HTTP/1.1" 200 5432
203.0.113.10 - admin [17/Oct/2026:10:15:34 +0000] "GET /api/users HTTP/1.1" 200 2048
10.0.1.22 - - [17/Oct/2026:10:15:35 +0000] "GET /images/logo.png HTTP/1.1" 304 0
198.51.100.55 - - [17/Oct/2026:10:15:36 +0000] "GET /admin/config HTTP/1.1" 403 256
203.0.113.10 - admin [17/Oct/2026:10:15:37 +0000] "GET /api/reports HTTP/1.1" 200 8192
198.51.100.55 - - [17/Oct/2026:10:15:39 +0000] "GET /dashboard HTTP/1.1" 200 5432
-v 反转匹配,看起来可以快速列出所有非 200 响应。
grep -v "200" access.log结果中保留了 401、304、403、500,因此在这个样本文件上看似正确。
198.51.100.55 - - [17/Oct/2026:10:15:33 +0000] "POST /api/login HTTP/1.1" 401 128
10.0.1.22 - - [17/Oct/2026:10:15:35 +0000] "GET /images/logo.png HTTP/1.1" 304 0
198.51.100.55 - - [17/Oct/2026:10:15:36 +0000] "GET /admin/config HTTP/1.1" 403 256
10.0.1.22 - - [17/Oct/2026:10:15:38 +0000] "DELETE /api/users/5 HTTP/1.1" 500 512
这里能工作,但很脆弱:响应大小 2000 字节或年份 2000 的时间戳同样包含“200”,也会从结果中消失。统计状态码应使用后文的 awk 字段测试。-c 统计匹配行数,-n 为匹配行编号。
grep -n "203.0.113.10" access.log冒号前是行号,因此可直接用 vim +6 access.log 或 sed -n '6p' 跳转。只关心数量时用 -c,它不输出匹配行,更适合脚本比较。下面是编号后的匹配结果。
1:203.0.113.10 - admin [17/Oct/2026:10:15:32 +0000] "GET /dashboard HTTP/1.1" 200 5432
3:203.0.113.10 - admin [17/Oct/2026:10:15:34 +0000] "GET /api/users HTTP/1.1" 200 2048
6:203.0.113.10 - admin [17/Oct/2026:10:15:37 +0000] "GET /api/reports HTTP/1.1" 200 8192
grep 模式中的点表示“任意字符”,因此 203.0.113.10 也会匹配 203a0b113c10。这个样本中无所谓,但在真实日志里搜索 IP 或版本号时,应加 -F 按固定字符串处理。该模式还会匹配 203.0.113.100,若只想精确匹配一个主机,应配合 -w。
只输出匹配部分
-o 只打印匹配到的片段,-E 启用扩展正则,使三位重复量词(由花括号包围的 3)和 | 无需额外反斜杠。裸 [0-9]{3} 也会匹配三位响应大小,因为 grep 无法辨别数字所处字段。用请求末尾的引号作为锚点,可以把模式限制在状态字段。
grep -oE '" [0-9]{3} ' access.log | grep -oE '[0-9]{3}'第一条 grep 的匹配包含引号和空格,因为它们是状态字段的锚点;第二条再把这些字符剥掉,只留下纯数字,供 sort | uniq -c 使用。
200
401
200
304
403
200
500
200
用 | 做选择可以一次找到两种方法,比分别运行两条 grep 更省,因为文件只读取一次。
grep -E "POST|DELETE" access.log两条会修改数据的请求都出现,而且都失败。真实日志中值得告警,因为写操作失败通常表示认证或后端问题,而不是 URL 拼写错误。这里 401 是登录失败,500 是服务器删除时崩溃。
198.51.100.55 - - [17/Oct/2026:10:15:33 +0000] "POST /api/login HTTP/1.1" 401 128
10.0.1.22 - - [17/Oct/2026:10:15:38 +0000] "DELETE /api/users/5 HTTP/1.1" 500 512
-P 启用 Perl 兼容正则,增加 \d、前瞻和回顾。这里提取每行开头的 IP,得到干净的客户端列表。-P 是 GNU 扩展,不要依赖它运行在 BSD 或 busybox grep 上。
grep -oP '^\d+\.\d+\.\d+\.\d+' access.log每个请求的客户端地址各占一行,保持日志顺序。只需唯一客户端时再接 sort -u,因为同一地址会在每次请求中重复。
203.0.113.10
198.51.100.55
203.0.113.10
10.0.1.22
198.51.100.55
203.0.113.10
10.0.1.22
198.51.100.55
这方法可用,但只适合小输入。在 200 万行日志上,grep -o 是提取第一列最慢的方案,因为它让正则引擎扫描每个字节,而不是按分隔符拆字段;awk 或 cut 快得多。
获取匹配附近上下文
单看一行错误通常无法说明发生了什么。-B1 -A1 打印前后各一行,-C2 是前后各两行的简写。多个匹配距离很近时,grep 会合并上下文,并用 -- 分隔组。
grep -B1 -A1 "500" access.log失败的 DELETE 位于其他客户端的正常请求之间,因此这里的邻近行可以排除全面故障。忙碌服务器上错误附近往往是无关请求,所以 -C 最好用于已按客户端或请求 ID 过滤的日志。
203.0.113.10 - admin [17/Oct/2026:10:15:37 +0000] "GET /api/reports HTTP/1.1" 200 8192
10.0.1.22 - - [17/Oct/2026:10:15:38 +0000] "DELETE /api/users/5 HTTP/1.1" 500 512
198.51.100.55 - - [17/Oct/2026:10:15:39 +0000] "GET /dashboard HTTP/1.1" 200 5432
查看 systemd 服务日志也同理,但 journalctl 自带更快的过滤条件,不必把所有日志都管道给 grep。
列出匹配文件与整词匹配
-r 递归搜索目录下所有文件,适合在只知道配置值时查找它被写在哪里。以普通用户搜索 /etc/ssh,会得到匹配项,同时因私有主机密钥不可读而产生权限错误。
grep -r "PermitRootLogin" /etc/ssh/两个匹配都是注释,说明主文件中没有覆盖该设置。不要据此下结论,应检查 /etc/ssh/sshd_config.d/,因为 Ubuntu 会在 sshd_config 顶部引入这些片段,sshd 采第一个读到的值。三条错误来自仅 root 可读的私有主机密钥。
/etc/ssh/sshd_config:#PermitRootLogin prohibit-password
/etc/ssh/sshd_config:# the setting of "PermitRootLogin prohibit-password".
grep: /etc/ssh/ssh_host_rsa_key: Permission denied
grep: /etc/ssh/ssh_host_ecdsa_key: Permission denied
grep: /etc/ssh/ssh_host_ed25519_key: Permission denied
加 -s 可屏蔽这些错误;确实需要搜索不可读文件时则用 sudo 运行。无论如何,即使找到匹配,退出码仍是 2 而不是 0,这对依赖 grep 返回值的脚本很重要:-s 只隐藏消息,不消除失败。-l 只列出包含匹配的文件名。
grep -rl "port" *.ini *.csv *.log两个文件匹配;若只想到配置文件,第二个结果会令人意外。
config.ini
access.log
访问日志匹配是因为 /api/reports 包含“port”。这种子串命中就是递归搜索 /etc 返回大量噪声的原因。-w 限制为整词,因此只有真正名为 port 的设置会命中。
grep -w "port" config.ini只打印两个真实 port 设置,因为 -w 要求匹配两侧是非单词字符或行边界。
port = 5432
port = 6379
grep 也是服务器上“这个设置在哪里”的主要工具。若搜索前还要按文件时间、所有者或大小过滤,应结合 find,而不是 grep 根目录下所有文件。
用 awk 选择列
awk 把每行当作记录并拆成字段:$1 是第一列,$NF 是最后一列,$0 是整行。默认分隔符是空白,-F 可设置其他字符。一旦按字段思考,条件、汇总和分组就会自然出现,因此任何类似表格问题都适合 awk。
选择列并设置分隔符
数一下日志行中按空格拆分的字段:第 1 个是客户端,第 7 个是请求路径,因为 GET 前的引号属于第 6 个字段。
awk '{print $1, $7}' access.log行内其他内容全部丢弃;print $1, $7 中的逗号会在两个值之间输出一个空格。
203.0.113.10 /dashboard
198.51.100.55 /api/login
203.0.113.10 /api/users
10.0.1.22 /images/logo.png
198.51.100.55 /admin/config
203.0.113.10 /api/reports
10.0.1.22 /api/users/5
198.51.100.55 /dashboard
处理 CSV 需要 -F,,NR>1 跳过表头,因为 NR 是当前记录号。
awk -F, 'NR>1 {print $2, $3}' employees.csv名称和部门会输出且不含表头。若不写 NR>1,第一行会输出为“name department”,多余表头会破坏后续汇总,因此后面示例都保留该判断。
Alice Johnson Engineering
Bob Smith Marketing
Carol Davis Engineering
Dan Wilson Sales
Eve Martinez Engineering
Frank Brown Marketing
Grace Lee Sales
Hank Taylor Engineering
-F, 只适用于简单 CSV。字段若被引号包裹且内部包含逗号(如 “Smith, Jr.”)就会拆错;这类文件应使用 gawk 的 --csv 或真正的 CSV 工具。
测试字段值
花括号前的模式决定动作作用于哪些行,因此一个程序即可完成过滤和输出。下面列出工资高于 90000 的员工。
awk -F, 'NR>1 && $4 > 90000 {print $2, $4}' employees.csv四个人通过判断。awk 把 $4 当作数字,因为它看起来是数字且与数字比较,所以 102000 会高于 98000,而不是像按文本比较那样排在其后。
Alice Johnson 95000
Carol Davis 102000
Eve Martinez 98000
Hank Taylor 110000
同样的思路可以修复前面脆弱的 grep -v "200",因为字段测试不会被行内其他内容误命中。
awk '$9 != 200 {print $1, $7, $9}' access.log所有非 200 请求都会列出客户端、路径和状态,并且即使响应大小或时间戳包含数字 200,这个版本仍保持正确。
198.51.100.55 /api/login 401
10.0.1.22 /images/logo.png 304
198.51.100.55 /admin/config 403
10.0.1.22 /api/users/5 500
这是处理日志时应养成的习惯:字段周围的数据变化时,字段测试仍然可靠。
对列求和、求平均与分组
END 块在最后一行之后执行一次,适合计算总和与平均值。
awk -F, 'NR>1 {sum += $4; count++} END {printf "Employees: %d\nAverage salary: $%.2f\n", count, sum/count}' employees.csv两个数字都来自对文件的一次扫描,因此 awk 内存中最多只需保留一行,同样命令也可用于 10 GB 数据导出。
Employees: 8
Average salary: $86375.00
关联数组可实现 group-by:每个部门名作为两个数组的键,一个保存累计值,一个保存人数,END 块再相除。这个任务里 grep 和 sed 都无法竞争,因为它们不能做算术。
awk -F, 'NR>1 {sum[$3]+=$4; count[$3]++} END {for (dept in sum) printf "%s: $%.2f (%d employees)\n", dept, sum[dept]/count[dept], count[dept]}' employees.csv在本次运行中,gawk 按以下顺序打印部门。
Marketing: $73500.00 (2 employees)
Sales: $69500.00 (2 employees)
Engineering: $101250.00 (4 employees)
mawk 输出相同三行,但顺序为 Marketing、Engineering、Sales。两种顺序都不算错,因为 awk 不定义 for (key in array) 的遍历顺序。顺序重要时应接 sort,或在 gawk 的 BEGIN 块中设置 PROCINFO["sorted_in"];mawk 接受该程序却忽略设置,所以只有 sort 可移植。下面是 gawk 下使用排序设置的示例。
gawk -F, 'BEGIN{PROCINFO["sorted_in"]="@ind_str_asc"} NR>1 {sum[$3]+=$4; count[$3]++} END {for (dept in sum) printf "%s: $%.2f (%d employees)\n", dept, sum[dept]/count[dept], count[dept]}' employees.csv现在键始终按字母顺序输出,因此比较不同日期的报告才有意义。
Engineering: $101250.00 (4 employees)
Marketing: $73500.00 (2 employees)
Sales: $69500.00 (2 employees)
只要报告会被人或 diff 工具重复阅读,排序就是安全默认值。
使用内置变量与字符串函数
NR 是记录号,NF 是当前行字段数,因此 NF 可快速发现畸形行。$NF 始终取最后一个字段,无论有多少列,所以在中间新增列后仍然有效。它最常用于 ls -l 和 df 输出,因为所需名称总在最后。
awk -F, 'NR>1 {print $2, $NF}' employees.csv每个名称与最后一列的城市配对。若某行缺少字段,$NF 会悄悄取到错误值,因此可用 awk -F, 'NF != 5' 快速检查坏行,再信任报告。当前文件所有行都有五个字段,因此不会输出任何内容。
Alice Johnson Portland
Bob Smith Seattle
Carol Davis Portland
Dan Wilson Denver
Eve Martinez Seattle
Frank Brown Portland
Grace Lee Denver
Hank Taylor Seattle
字符串函数可省去再调用 tr 或 cut 的步骤,让筛选和格式化一次完成。下面输出大写部门、姓名长度和名称前五个字符。
awk -F, 'NR>1 {print toupper($3), length($2), substr($2,1,5)}' employees.csvlength 会把姓名中的空格计入,因此 “Hank Taylor” 是 11 个字符,“Alice Johnson” 是 13 个字符。
ENGINEERING 13 Alice
MARKETING 9 Bob S
ENGINEERING 11 Carol
SALES 10 Dan W
ENGINEERING 12 Eve M
MARKETING 11 Frank
SALES 9 Grace
ENGINEERING 11 Hank
printf 可生成对齐列,便于把报告粘贴到工单或邮件。
awk -F, 'NR>1 {printf "%-15s %-12s $%9.2f\n", $2, $3, $4}' employees.csv格式字符串中的宽度让每行对齐,因为 %-15s 将姓名填充到 15 个字符,%9.2f 将工资按总宽 9 右对齐。
Alice Johnson   Engineering  $ 95000.00
Bob Smith       Marketing    $ 72000.00
Carol Davis     Engineering  $102000.00
Dan Wilson      Sales        $ 68000.00
Eve Martinez    Engineering  $ 98000.00
Frank Brown     Marketing    $ 75000.00
Grace Lee       Sales        $ 71000.00
Hank Taylor     Engineering  $110000.00
多数临时报告只需要这几个格式说明符。
设置多个字段分隔符
-F 接受正则表达式,因此方括号表达式可一次按多个字符拆分。下面按 [ 和 : 拆分日志行,以取得日期和小时。双反斜杠看似多余,但单引号会把 \\[ 原样交给 awk,awk 的字符串处理再把它变成字符类中的转义左方括号 \[。
awk -F'[\\[:]' '{print $2, $3}' access.log样本中每个请求都发生在同一小时,所以八行的第 3 个字段都是 10。对全天日志使用相同拆分并接 sort | uniq -c,就能得到每小时请求数,这通常是故障后的首个统计。
17/Oct/2026 10
17/Oct/2026 10
17/Oct/2026 10
17/Oct/2026 10
17/Oct/2026 10
17/Oct/2026 10
17/Oct/2026 10
17/Oct/2026 10
左方括号必须转义。若写成较短的 -F'[[:]',gawk 会把 [: 当作 [:digit:] 这类字符类的开头,随后报错。
awk: fatal: invalid regexp: Unmatched [, [^, [:, [., or [=: /[[:]/mawk 会以 regular expression compile failed (bad class -- [], [^] or [) 拒绝同一分隔符。两者都以状态 2 退出且不输出内容,因此基于这条单行命令的 cron 任务会悄悄生成空报告。保留反斜杠,并让脚本检查 awk 退出状态。
用 sed 编辑文本流
sed 在每行经过时应用编辑命令并打印结果。默认不修改文件,因此可安全试验,只有 -i 才写回。推荐流程是先在 stdout 上反复调整表达式,输出正确后再加 -i.bak 对真实文件执行一次。GNU sed 手册列出全部命令;替换、删除、范围打印和插入已覆盖几乎所有实际需求。
替换文本
s/old/new/g 替换每行中的全部匹配;没有 g 时只替换每行第一处。
sed 's/admin/root/g' access.log注意第五行,URL 也变了,因为 sed 不知道哪一段是用户字段。对真实日志全局替换会改写你根本不想改的路径。
203.0.113.10 - root [17/Oct/2026:10:15:32 +0000] "GET /dashboard HTTP/1.1" 200 5432
198.51.100.55 - - [17/Oct/2026:10:15:33 +0000] "POST /api/login HTTP/1.1" 401 128
203.0.113.10 - root [17/Oct/2026:10:15:34 +0000] "GET /api/users HTTP/1.1" 200 2048
10.0.1.22 - - [17/Oct/2026:10:15:35 +0000] "GET /images/logo.png HTTP/1.1" 304 0
198.51.100.55 - - [17/Oct/2026:10:15:36 +0000] "GET /root/config HTTP/1.1" 403 256
203.0.113.10 - root [17/Oct/2026:10:15:37 +0000] "GET /api/reports HTTP/1.1" 200 8192
10.0.1.22 - - [17/Oct/2026:10:15:38 +0000] "DELETE /api/users/5 HTTP/1.1" 500 512
198.51.100.55 - - [17/Oct/2026:10:15:39 +0000] "GET /dashboard HTTP/1.1" 200 5432
让模式足够具体,只命中用户字段;这里通过在两侧包含空格实现。
sed 's/ admin / root /' access.log现在 /admin/config 保留下来,只有用户列变化。自由文本中通常需要用 ^ 或周围字符锚定,才能精确替换。始终先不加 -i 运行并阅读输出,这种预演没有成本。
203.0.113.10 - root [17/Oct/2026:10:15:32 +0000] "GET /dashboard HTTP/1.1" 200 5432
198.51.100.55 - - [17/Oct/2026:10:15:33 +0000] "POST /api/login HTTP/1.1" 401 128
203.0.113.10 - root [17/Oct/2026:10:15:34 +0000] "GET /api/users HTTP/1.1" 200 2048
10.0.1.22 - - [17/Oct/2026:10:15:35 +0000] "GET /images/logo.png HTTP/1.1" 304 0
198.51.100.55 - - [17/Oct/2026:10:15:36 +0000] "GET /admin/config HTTP/1.1" 403 256
203.0.113.10 - root [17/Oct/2026:10:15:37 +0000] "GET /api/reports HTTP/1.1" 200 8192
10.0.1.22 - - [17/Oct/2026:10:15:38 +0000] "DELETE /api/users/5 HTTP/1.1" 500 512
198.51.100.55 - - [17/Oct/2026:10:15:39 +0000] "GET /dashboard HTTP/1.1" 200 5432
一旦替换输出完全符合预期,就可以应用到真实文件。
带备份地原地编辑文件
-i 把结果写回文件。给它加后缀(如 -i.bak)后,sed 会在旁边保留原文件,这就是修改 /etc 下任何文件或重启读取该文件的服务前的撤销手段。这里先在副本上操作,以便后续示例仍能看到原始配置。
cp config.ini config_test.ini
sed -i.bak 's/workers = 4/workers = 8/' config_test.ini
grep workers config_test.ini config_test.ini.bak
新值写入文件,旧值留在备份中;若修改出错,用一次 mv 即可恢复。
config_test.ini:workers = 8
config_test.ini.bak:workers = 4
GNU sed 接受裸 -i,但 macOS 的 BSD sed 会把下一个参数当作后缀,因此 sed -i 's/a/b/' file 在那里会失败。sed -i.bak 在两者上都能工作,这也是推荐写法。
删除和打印行
d 删除地址选中的行,多条命令可用 ; 串联。下面去掉段标题和空行,只保留设置。没有 -i 时文件本身不会被修改,sed 只打印结果。
sed '/^\[/d; /^$/d' config.ini剩下十二行键值设置,这是快速查看冗长注释配置实际生效内容的方法。
host = 10.0.1.100
port = 5432
name = appdb
user = appuser
password = ChangeMe123
host = 10.0.1.101
port = 6379
maxmemory = 256mb
debug = false
workers = 4
log_level = info
secret_key = replace-me要删除特定设置时应按模式删除,而不是按行号。sed '/^password/d' config.ini 会删除任意位置的密码行;sed '5d' 删除第五行,而此文件第五行是 user = appuser,不是密码。每次有人编辑文件,行号都会变化,因此脚本中按编号删除迟早会出错。
-n 关闭 sed 的自动打印,因此只有 p 指定的内容会输出。CSV 第 2 至第 4 行是前三名员工。
sed -n '2,4p' employees.csv第 1 行是表头,因此范围从 Alice 开始。没有 -n 时,sed 会先打印全部内容,再把第 2 至第 4 行打印第二次。
1,Alice Johnson,Engineering,95000,Portland
2,Bob Smith,Marketing,72000,Seattle
3,Carol Davis,Engineering,102000,Portland
这种行范围适合在编写过滤条件前抽样查看大 CSV 的前几行。
在匹配行前后添加内容
i\ 在地址行前插入,a\ 在后面追加。给每个 port 设置追加 timeout 只需一条命令,不必知道每段从哪里开始。预览正确后再配合 -i.bak。
sed '/^port/a\timeout = 30' config.ini两个 port 行下方都添加了新设置,因为地址 /^port/ 匹配两次,a\ 每次命中执行一次。把文本直接放在 a\ 同一行是 GNU 扩展;BSD 和 macOS sed 要求在文本前加反斜杠和换行。
[database]
host = 10.0.1.100
port = 5432
timeout = 30
name = appdb
user = appuser
password = ChangeMe123

[redis]
host = 10.0.1.101
port = 6379
timeout = 30
maxmemory = 256mb

[app]
debug = false
workers = 4
log_level = info
secret_key = replace-me
预览正确后,用同一地址配合 -i.bak 写入。
用捕获组重排文本
在 -E 下,圆括号捕获文本,\1、\2 可引用捕获组。交换名和姓只需一次替换;-n 与 p 标志只打印发生替换的行。基本正则会把手写圆括号当作普通字符,因此不用 -E 时每个组都要写成 \( 和 \),多数 sed 单行命令也因此变得难读。
sed -E -n 's/^[0-9]+,([A-Za-z]+) ([A-Za-z]+),.*/\2, \1/p' employees.csv每名员工都转换为“姓, 名”,表头消失,因为 ^[0-9]+, 要求行首有数字 ID。
Johnson, Alice
Smith, Bob
Davis, Carol
Wilson, Dan
Martinez, Eve
Brown, Frank
Lee, Grace
Taylor, Hank
捕获组还可用于重排日期、交换键值顺序或给值加引号。
选择配置中的单个段
地址范围 /start/,/end/ 会选择两个模式之间包括首尾在内的全部内容。把结束地址设为 [redis] 后面的空行比设成下一个段标题更干净,因为无需再用第二条 sed 删除该标题。下面只打印 redis 段。
sed -n '/^\[redis\]/,/^$/p' config.ini该段连末尾空行一起输出,因为结束地址本身也在范围内。
[redis]
host = 10.0.1.101
port = 6379
maxmemory = 256mb
这仅在段之间有空行时有效。若没有空行,可用 /^\[redis\]/,/^\[/p 结束到下一个标题,再通过 sed '$d' 去掉该标题行。
用 grep、awk 与 sed 组合管道
管道让每个工具做最擅长的工作:grep 缩小输入,awk 选列并计算,sed 改写。以下四种模式覆盖大多数场景。
- 按字段计数:awk 提取,再接
sort | uniq -c | sort -rn;先过滤再提取:grep 缩小输入,awk 输出字段;重塑名称:awk 选择、sed 改写、awk 再格式化;转换配置:用单个 awk 程序跨行跟踪状态。
按客户端统计请求数是最经典的管道,也是使用频率最高的组合之一。
awk '{print $1}' access.log | sort | uniq -c | sort -rn两个客户端各有三次请求并列第一。uniq -c 只统计相邻重复项,因此第一个 sort 不能省。最后的 sort -rn 把最忙客户端放在顶部。
      3 203.0.113.10
      3 198.51.100.55
      2 10.0.1.22
若只想列出 4xx 和 5xx 错误及详情,可用 grep 过滤、awk 提取。
grep -E '" (4[0-9]{2}|5[0-9]{2}) ' access.log | awk '{print $1, $7, $9}'304 被排除,因为它是缓存响应而非错误。模式中的引号可避免响应大小 4096 被当作状态码,因为大小出现在状态码之后,不可能紧接在结束引号后。
198.51.100.55 /api/login 401
198.51.100.55 /admin/config 403
10.0.1.22 /api/users/5 500
把 Engineering 团队转换为邮箱地址需要用到全部三个阶段。
awk -F, 'NR>1 && $3=="Engineering" {print $2}' employees.csv | sed 's/ /./g' | awk '{print tolower($0) "@example.com"}'awk 选取并提取,sed 把空格换成点,第二个 awk 转为小写并添加域名。
alice.johnson@example.com
carol.davis@example.com
eve.martinez@example.com
hank.taylor@example.com
把 INI 转成环境变量时,管道已不再是正确答案。常见版本 grep -E "^[a-z]" config.ini | sed 's/ = /=/' | awk '{print "export " toupper($0)}' 会把值也转成大写(密码变成 CHANGEME123),且每个段都会重复导出 HOST。用一个记住当前段的 awk 程序可同时修复两个问题。
awk -F' = ' '/^\[/{gsub(/[][]/,""); sec=toupper($0); next} NF==2 {print "export " sec "_" toupper($1) "=\"" $2 "\""}' config.ini每个变量都带段前缀,值保持原大小写,并用双引号包裹,因此含空格的值仍会作为一个字符串加载。
export DATABASE_HOST="10.0.1.100"
export DATABASE_PORT="5432"
export DATABASE_NAME="appdb"
export DATABASE_USER="appuser"
export DATABASE_PASSWORD="ChangeMe123"
export REDIS_HOST="10.0.1.101"
export REDIS_PORT="6379"
export REDIS_MAXMEMORY="256mb"
export APP_DEBUG="false"
export APP_WORKERS="4"
export APP_LOG_LEVEL="info"
export APP_SECRET_KEY="replace-me"
用进程替换把变量加载到当前 shell,再读取几个值确认。
source <(awk -F' = ' '/^\[/{gsub(/[][]/,""); sec=toupper($0); next} NF==2 {print "export " sec "_" toupper($1) "=\"" $2 "\""}' config.ini)
echo "$DATABASE_HOST $REDIS_PORT $APP_LOG_LEVEL"
这些值来自环境。若值中含 $、反引号或双引号,shell 仍会展开,因此只能加载你信任的配置文件。
10.0.1.100 6379 info当这类单行命令逐渐发展为带函数和错误处理的脚本时,一本好参考书会很快回本;本站 Bash 脚本书单适合从管道过渡到正式脚本时使用。
测试 grep、awk 与 sed 的速度
几千行文件上三者都快得来不及眨眼,应按可读性选择。几百 MB 的日志才真正体现速度差异,因此我们在测试机(2 vCPU、2 GB 内存、Ubuntu 26.04)上生成 158 MB、200 万行的访问日志,并用三种工具分别执行四个相同任务。数据都是在文件已进入页缓存后取三次运行的最佳值,输出接到 wc -l 或 sort,避免终端绘制干扰。
生成器使用固定随机种子的 gawk,因此可复现同样的 200 万行;mawk 的随机生成器即使同种子也会产生不同内容。请在临时目录运行,因为它会写入 158 MB。
gawk 'BEGIN{srand(42); split("GET GET GET GET POST DELETE PUT",m," "); split("200 200 200 200 200 304 401 403 404 500",s," "); split("/dashboard /api/login /api/users /api/reports /images/logo.png /admin/config",u," "); for(i=1;i<=2000000;i++){ip="10.0." int(rand()*250) "." int(rand()*250); printf "%s - - [17/Oct/2026:10:%02d:%02d +0000] \"%s %s HTTP/1.1\" %s %d\n", ip, int(rand()*60), int(rand()*60), m[int(rand()*7)+1], u[int(rand()*6)+1], s[int(rand()*10)+1], int(rand()*9000)}}' > big.log然后对想比较的命令计时,这里测试 grep 计数。
time grep -c '" 500 ' big.log下表中的时间单位为秒,每个单元格取三次运行最佳值。
| 任务 | grep | sed | mawk | gawk | 其他 |
|---|---|---|---|---|---|
| 统计状态码为 500 的行 | 0.19(grep -c) |
0.40(sed -n + wc -l) |
0.55 | 0.76 | |
| 打印客户端 IP 列 | 10.05(grep -oE) |
2.80(s/ .*//) |
0.55 | 0.55 | 0.18(cut) |
| 把每个 GET 替换成 FETCH | 0.75(s///g) |
0.43(gsub) |
1.20(gsub) |
||
| 按状态码统计请求 | 2.53(grep -o + sort + uniq -c) |
0.43 | 0.72 |
所有工具返回的答案一致:含 500 的行 200453 行,IP 共 2000000 个。有三点值得据此调整习惯:单纯查找或计数行时 grep 最快,约为 awk 的三倍;按单个分隔符提取列时 cut 最快,awk 是灵活的次选,而 grep -o 和 sed 都较慢,因为它们让正则引擎扫描每个字节,而不是按分隔符拆分;mawk 在每个 awk 任务中都不慢于 gawk,替换任务快近三倍,因此默认 awk 指向 gawk 的主机可在大批量一次性处理时显式调用 mawk。
慢任务中,locale 的影响甚至比工具更大。服务器镜像使用 C.UTF-8,桌面通常使用 en_US.UTF-8 等,任何 UTF-8 locale 都会让 grep 和 sed 处理多字节字符。对这份纯 ASCII 日志强制使用按字节处理的 C locale,可以让两者显著加速。
| 命令 | C.UTF-8 | LC_ALL=C |
|---|---|---|
grep -oE '^[^ ]+' big.log |
10.10 秒 | 3.50 秒 |
sed 's/ .*//' big.log |
2.81 秒 | 1.04 秒 |
固定模式下的简单 grep -c 没有变化(两种情况均 0.19 秒),因为 GNU grep 已对固定字符串走快速路径。针对可确认是 ASCII 的日志执行大量正则扫描时使用 LC_ALL=C;含非英文字符的文本不要这样设置,因为 C locale 会把多字节字符按单个字节处理,字符类行为也会改变。
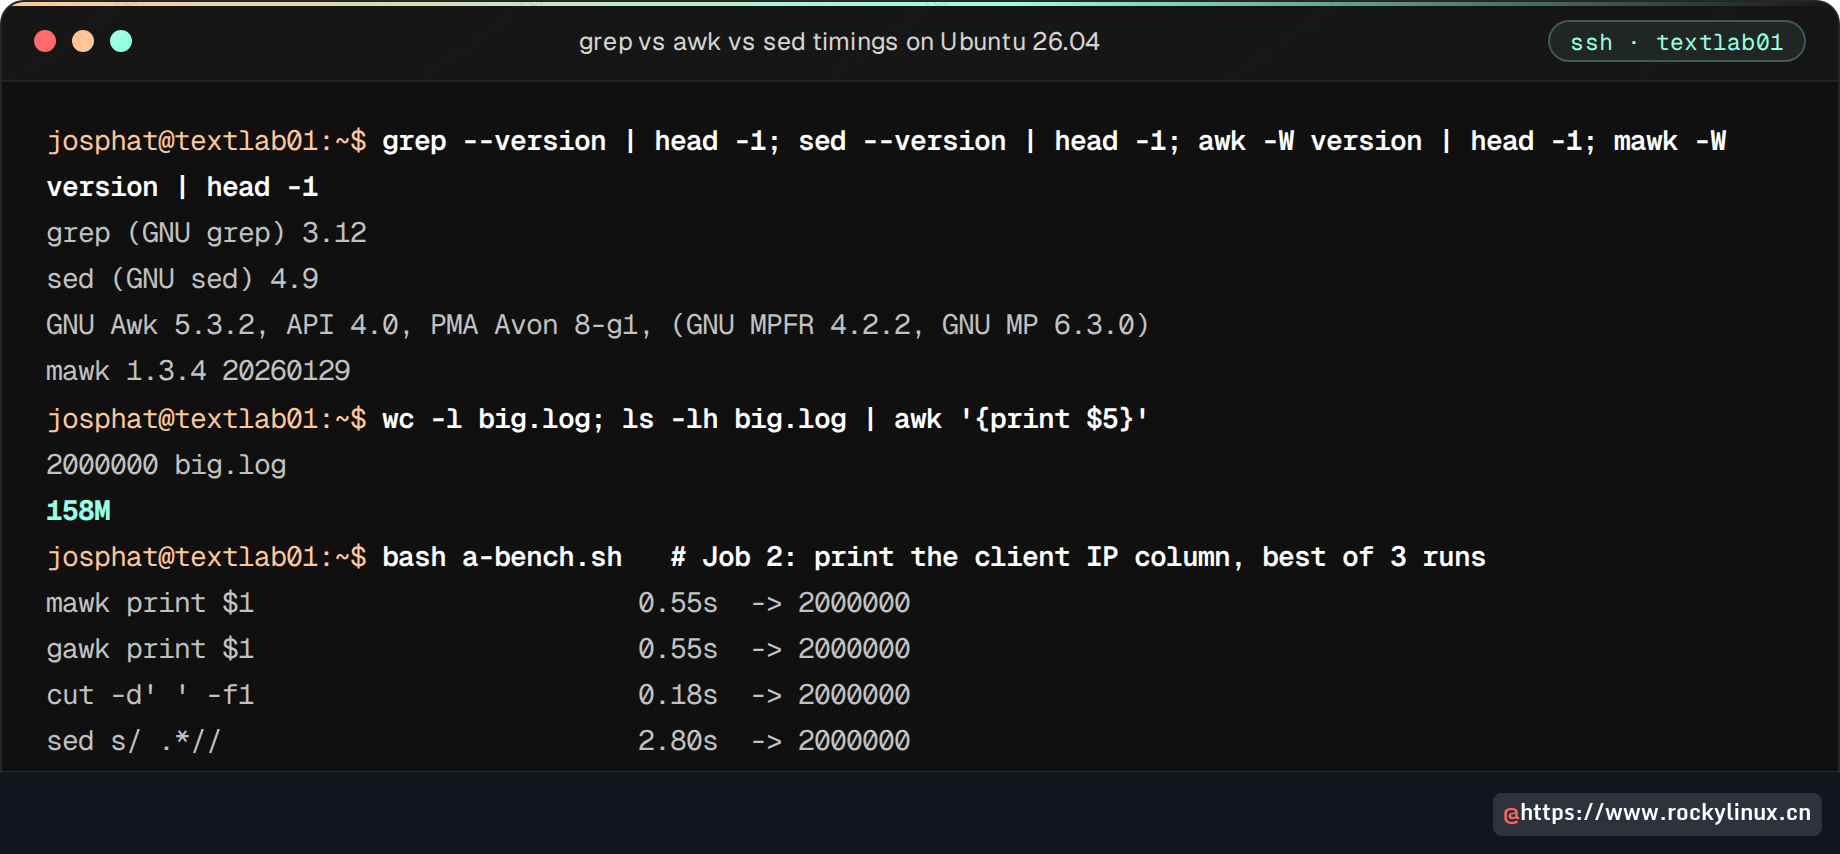
截图中同一台虚拟机展示了工具版本和第一张表中的取列耗时。你的绝对秒数会随 CPU 和磁盘变化,但每次运行的排序都一致,因此更应相信相对排名,而不是具体秒数。
grep、awk 与 sed 快速参考
下表是上文使用过的形式,并按最可能使用的顺序排列。通用行是模板,每种形式都在前文示例中配合真实输出出现过。
| 任务 | 命令 |
|---|---|
| 搜索字符串 | grep "pattern" file |
| 按固定字符串搜索(不解释正则) | grep -F "10.0.1.22" file |
| 忽略大小写 | grep -i "pattern" file |
| 排除匹配行 | grep -v "pattern" file |
| 统计或编号匹配行 | grep -c / grep -n "pattern" file |
| 只打印匹配部分 | grep -oE '[0-9]{3}' file |
| 显示匹配上下文 | grep -C2 "pattern" file |
| 列出包含匹配的文件 | grep -rl "pattern" /path/ |
| 整词匹配 | grep -w "port" file |
| 打印指定列 | awk '{print $1, $7}' file |
| 自定义分隔符并跳过表头 | awk -F, 'NR>1 {print $2}' file |
| 按字段过滤 | awk '$9 != 200' file |
| 对列求和 | awk '{s+=$4} END {print s}' file |
| 分组汇总 | awk '{a[$1]+=$2} END {for (k in a) print k, a[k]}' file |
| 打印最后一个字段 | awk '{print $NF}' file |
| 替换文本 | sed 's/old/new/g' file |
| 原地编辑并备份 | sed -i.bak 's/old/new/' file |
| 删除匹配行 | sed '/pattern/d' file |
| 打印指定行范围 | sed -n '2,4p' file |
| 在匹配行后追加 | sed '/pattern/a\new line' file |
| 用捕获组交换内容 | sed -E 's/(a) (b)/\2 \1/' file |
| 打印两个模式之间的内容 | sed -n '/start/,/end/p' file |
若只从基准测试中记住一条规则,就是:查找和计数用 grep,计算用 awk,改写用 sed,而只需要一列时优先用 cut。若想深入了解三者共享的正则表达式,LPIC-1 搜索文本指南并列讲解了基本与扩展语法。