Qwen3.8 Flash-Next 在 16 个 vCPU、无 GPU 的环境中,用 66.4 GB 的量化文件实现了每秒 4.8 个 token 的解码速度。2-bit 量化在页缓存已预热时加载约需 12 秒;首次冷加载会更慢,因为权重需要从磁盘换入。这是一个 125B 模型跑出了 7B 级模型的 CPU 速度。关键在于架构:每个 token 只激活约 6B 参数,同时还有一个 51B 参数的 n-gram 表和一个 4B 的多 token 预测模块,后两者大多作为常驻但闲置的权重存在。
本文实测了三个最小的量化版本,运行了投机解码路径并测试了 Ollama。下文所有 CPU 数据都来自这次实测:llama.cpp b12211、Unsloth GGUF 修订版 084c631ac221、2026-11-04 的 Dynamic v3.1 量化,以及 Ubuntu 26.04。
本教程在一台 16 vCPU、128 GB 内存的虚拟机上完成完整流程:编译 llama.cpp、下载分片 GGUF、运行第一个提示词、测试不同量化的性能、评估上下文内存开销,最后通过 OpenAI API 提供服务、接入 MTP 解码,并绕过 Ollama 当前不支持分片 GGUF 的限制。
Flash-Next 如何改变内存估算
Qwen3.8 Flash-Next 是一个 125B 参数的混合专家(MoE)模型,还包含两个普通模型没有的模块。它也是 Qwen4 架构的预览版:MoE 核心、n-gram 表和多 token 预测模块预计都会出现在 Qwen4 正式模型中,因此本文的内存估算和 llama.cpp 工作流可以沿用到正式版本,只是构建版本和量化固定值需要重新核对。
资源占用由三部分组成,每一部分影响的是不同指标:
- 激活的 MoE 路径: 每个 token 约激活 6B 参数,这正是解码速度在 CPU 上仍然可用的原因。
- N-gram 嵌入表: 2000 万条目合计 51B 参数,与 Transformer 并列存在,因此磁盘和内存占用与 6B 模型完全不同。
- MTP 模块: 用于投机解码的 4B 参数模块,可在推理时选用,也可以替换。
Transformer 本身持有剩余权重,并像普通稠密模型一样量化。在 1-bit 到 4-bit 的 UD 系列中,每个量化的最后一个分片都是约 28.8 GB 的 n-gram 表。Unsloth 在同一仓库的 engram 目录还提供更大的预构建表,可以以更高内存占用换取更好的预测质量。更大 bit 数的量化分片方式不同:Q8_0 和 BF16 使用六个或更多分片,最后一个分片也更大。
下载前需要知道两个细节。第一,主模型没有 Q4_K_M 量化,仓库中的 Q4_K_M 文件只是 MTP 伴随模型。第二,上面的大小来自 Hugging Face 的 blob 列表,使用十进制 GB;所以标记为“66 GB”的量化,在 llama.cpp 输出中会显示为 61.8 GiB。
第 1 步:在 Ubuntu 26.04 上编译 llama.cpp
qwen4exp 架构从 2026 年 8 月底起已经进入 llama.cpp 上游,因此较新的构建都能读取这些文件。本文固定使用 b12211,因为下面全部数据都来自该构建,也只对应该构建。测试机使用 16 个并行任务时,编译约需五分钟。如果系统是全新安装,先安装工具链:
sudo apt install build-essential cmake git libcurl4-openssl-dev克隆固定标签并配置本机原生编译。GGML_NATIVE=ON 会让编译器使用主机 CPU 支持的 AVX 扩展,后面的提示词处理速度依赖这一设置。
git clone --depth 1 --branch b12211 https://github.com/ggml-org/llama.cpp
cd llama.cpp

cmake -B build -DGGML_NATIVE=ON -DCMAKE_BUILD_TYPE=Release
cmake --build build --config Release -j 16
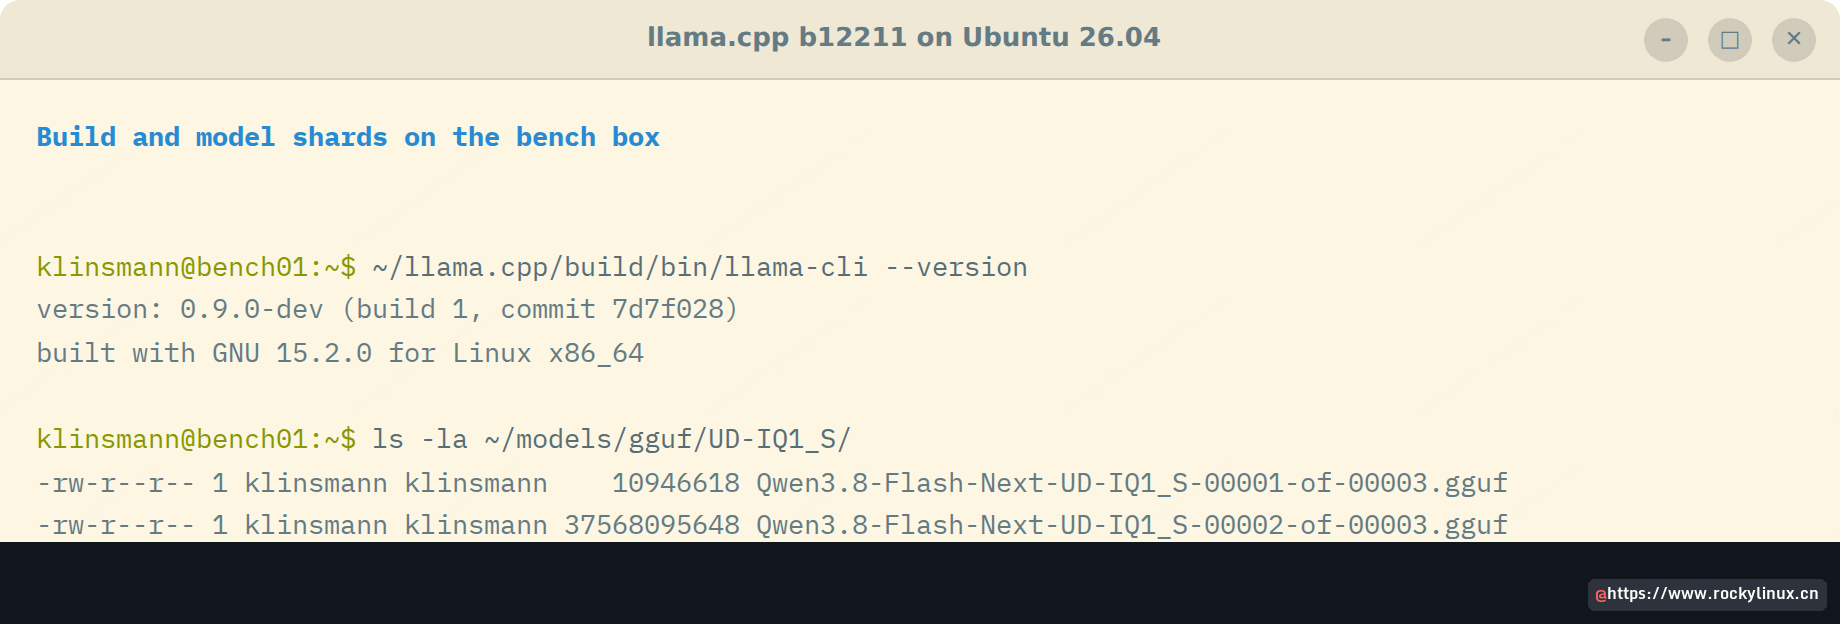
下载模型前,先确认构建版本正确。下面的版本横幅显示 build 1、commit 7d7f028,也就是 b12211 标签,同时列出了下一步下载得到的三个分片文件:
~/llama.cpp/build/bin/llama-cli --version输出示例:
version: 0.9.0-dev (build 1, commit 7d7f028)
built with GNU 15.2.0 for Linux x86_64

ls -la ~/models/gguf/UD-IQ1_S/
-rw-r--r-- 1 klinsmann klinsmann     10946618 Qwen3.8-Flash-Next-UD-IQ1_S-00001-of-00003.gguf
-rw-r--r-- 1 klinsmann klinsmann  37568095648 Qwen3.8-Flash-Next-UD-IQ1_S-00002-of-00003.gguf
-rw-r--r-- 1 klinsmann klinsmann 28800138432 Qwen3.8-Flash-Next-UD-IQ1_S-00003-of-00003.gguf有一个参数会直接影响后面的运行命令。对聊天模型的单次提示词,--single-turn 只运行一轮后退出,符合基准命令的需要。旧教程可能使用 -no-cnv;在当前构建中该参数属于 llama-completion,不是 llama-cli,所以应使用 --single-turn。
第 2 步:下载 GGUF 量化
| 量化 | 下载大小 |
|---|---|
UD-IQ1_S |
66.4 GB |
UD-IQ1_M |
68.0 GB |
UD-Q2_0 |
70.5 GB |
UD-IQ2_XS |
75.8 GB |
UD-Q2_K_XL |
79.6 GB |
UD-IQ3_XXS |
83.6 GB |
UD-Q3_K_XL |
89.5 GB |
UD-IQ4_XS |
93.7 GB |
UD-Q4_K_XL |
111.3 GB |
UD-Q5_K_XL |
158.3 GB |
UD-Q6_K_XL |
169.2 GB |
Q8_0 |
188.2 GB |
BF16 |
354.0 GB |
Unsloth 在同一仓库中发布分片 GGUF。使用 hf CLI 下载目标量化;体积最小的版本也有 66.4 GB,开始前先确认磁盘容量。测试机上保存了三个量化及伴随模型,占用 310 GB 后仍有剩余空间。
sudo apt install python3-pip python3-venv
python3 -m venv ~/hf-venv
~/hf-venv/bin/pip install -U "huggingface_hub[cli]"
~/hf-venv/bin/hf download unsloth/Qwen3.8-Flash-Next-GGUF \
  --include "UD-IQ1_S/*" --local-dir ~/models/gguf
如果磁盘足够,并且准备测试后面的投机解码,可以同时下载同一仓库 MTP 目录下的草稿模型:
~/hf-venv/bin/hf download unsloth/Qwen3.8-Flash-Next-GGUF \
  --include "MTP/*" --local-dir ~/models/gguf
较小的 UD 量化通常由三个或四个分片组成。第一个 00001 分片只有 10.9 MB,包含元数据;中间分片保存权重,最后约 28.8 GB 的分片是 n-gram 表。将 llama.cpp 指向 00001 文件时,它会自动读取其余分片,所以本文所有命令只指定第一个分片。
第 3 步:运行第一个提示词
采样参数采用 Unsloth 的 llama-cli 示例。下面的命令运行一个提示词,输出会把思考块与答复分开,然后退出:
~/llama.cpp/build/bin/llama-cli \
  -m ~/models/gguf/UD-IQ1_S/Qwen3.8-Flash-Next-UD-IQ1_S-00001-of-00003.gguf \
  -p "Summarize what a mixture-of-experts language model is in one paragraph." \
  -n 128 -t 16 --temp 1.0 --top-p 0.95 --top-k 20 --min-p 0.0 \
  --single-turn --seed 42
以下是 1-bit 量化、随机种子 42 的实际运行结果:
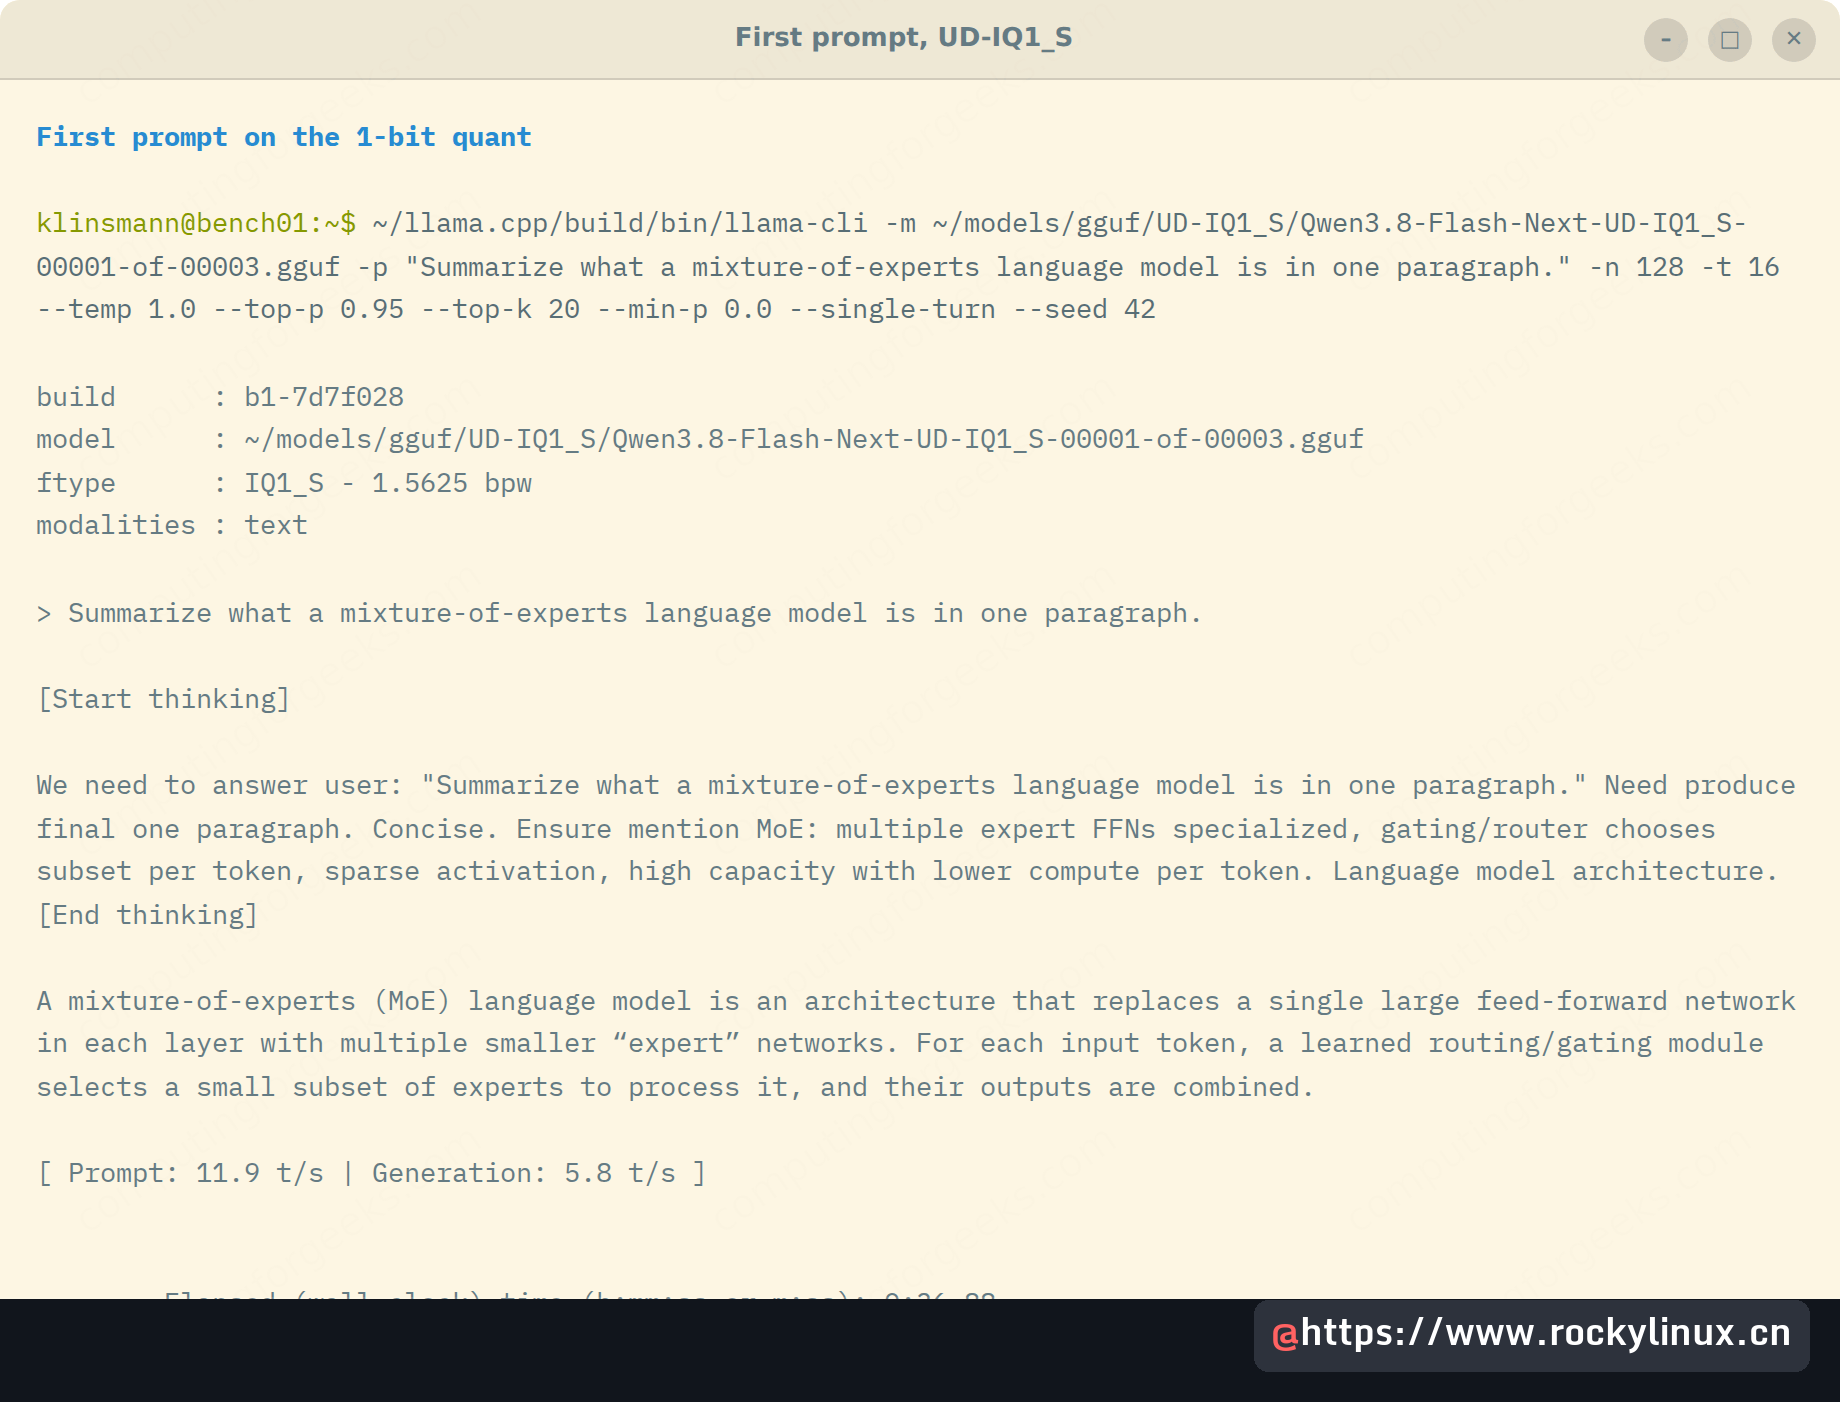
页缓存预热后,这次短运行显示提示词处理速度为每秒 11.9 token,生成速度为每秒 5.8 token,常驻内存峰值为 43.1 GiB。这个速率只代表单次提示词;要比较不同量化,应看第 4 步的 llama-bench 数据。模型在回答前花了约 60 个 token 思考,这是该系列的正常行为,也会直接计入 CPU 上的总耗时。如果只关心最终答复,-n 的预算要把思考 token 一起算进去。
第 4 步:测量不同量化阶梯
llama-bench 可以给出不同量化之间可比较的数据。我们对三个量化都运行了相同固定工作负载:512 个提示词 token、生成 128 个 token、16 线程。
~/llama.cpp/build/bin/llama-bench \
  -m ~/models/gguf/UD-IQ1_S/Qwen3.8-Flash-Next-UD-IQ1_S-00001-of-00003.gguf \
  -p 512 -n 128 -t 16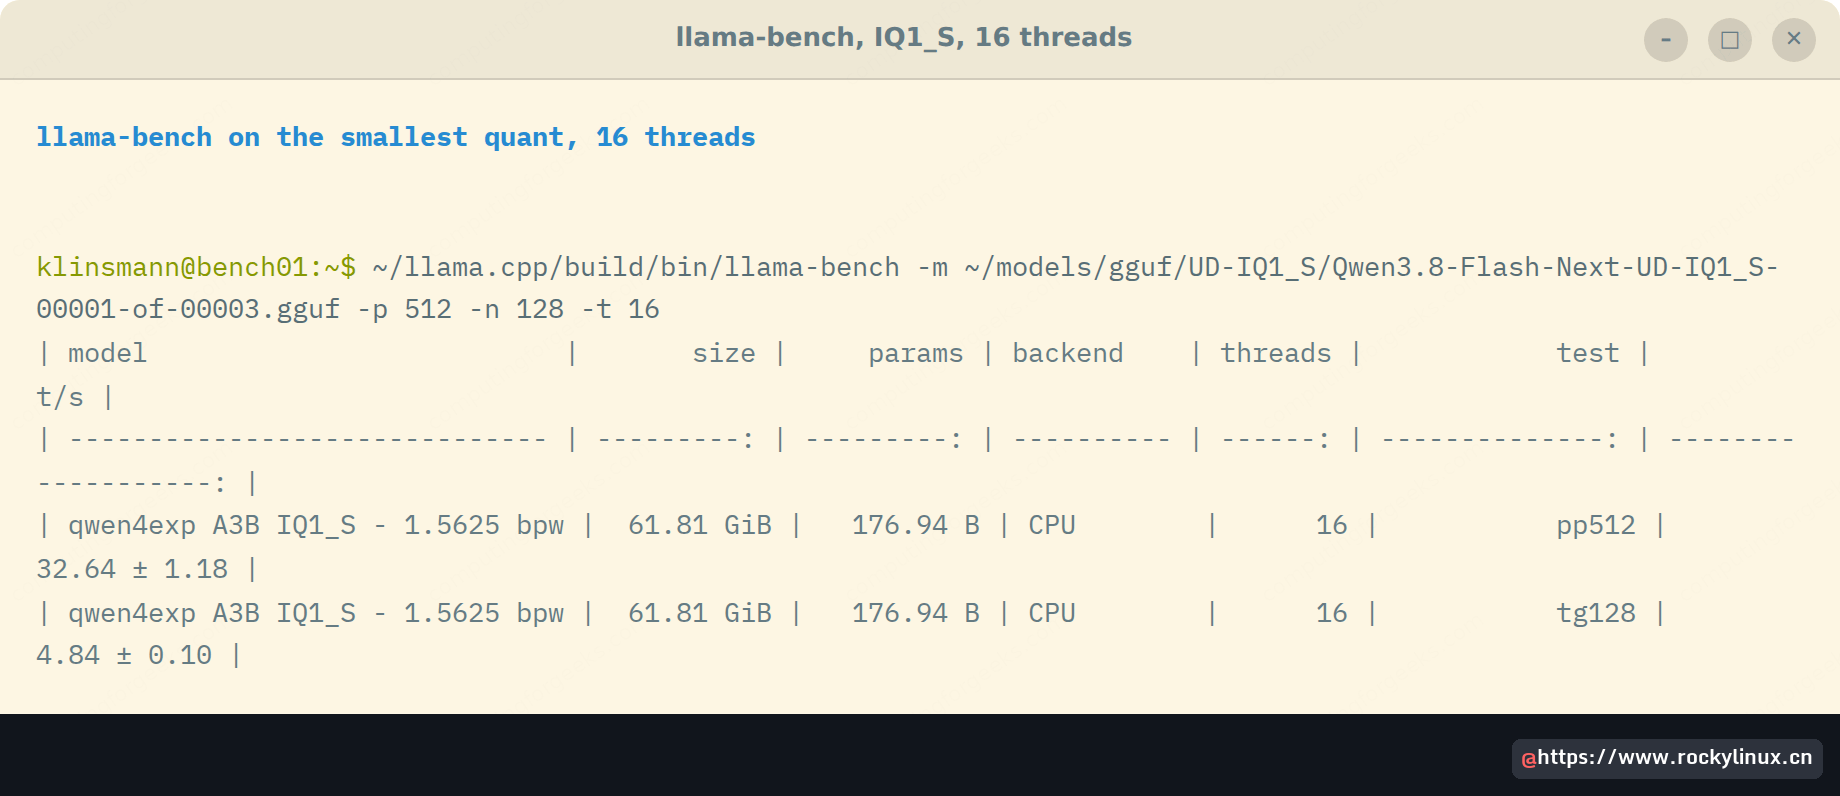
| 量化 | 下载 | 模型大小 | llama-cli 峰值 RSS |
pp512(token/s) | tg128(token/s) |
|---|---|---|---|---|---|
UD-IQ1_S |
66.4 GB | 61.81 GiB | 43.1 GiB | 32.64 ± 1.18 | 4.84 ± 0.10 |
UD-IQ2_XS |
75.8 GB | 70.61 GiB | 62.6 GiB | 31.67 ± 0.32 | 4.67 ± 0.09 |
UD-Q2_K_XL |
79.6 GB | 74.11 GiB | 68.5 GiB | 32.08 ± 0.61 | 4.67 ± 0.06 |
量化选择几乎不会改变速度。模型大小相差约 20% 时,tg128 生成速度仍在每秒 4.67 到 4.84 token 之间,差距基本处于运行波动范围内。三个量化使用完全相同的 28.8 GB n-gram 分片,额外 bit 主要进入 Transformer 和专家权重;每个 token 只激活约 6B 参数,所以每个 token 需要流经内存的数据量变化很小。
更有价值的信息来自内存。1-bit 运行虽然文件为 61.81 GiB,常驻内存峰值只有 43.1 GiB。n-gram 表通过 mmap 按需进入内存,128 token 的运行根本不会触碰其中大部分内容。规划内存时应参考模型大小列,而不是短运行的 RSS,否则长会话进行到一半时机器就会开始交换。
第 5 步:检查上下文的内存成本
在这个模型上,每个上下文 token 大约消耗 30 KB 常驻内存。我们在 2-bit 量化上启动两次 llama-server,分别使用 4096 和 32768 上下文,并在加载后从 ps 读取常驻集:
~/llama.cpp/build/bin/llama-server \
  -m ~/models/gguf/UD-Q2_K_XL/Qwen3.8-Flash-Next-UD-Q2_K_XL-00001-of-00004.gguf \
  -t 16 -c 4096 --port 8080 &

until curl -s http://127.0.0.1:8080/health | grep -q '"status":"ok"'; do
  sleep 2
done

ps -o rss= -p $!
kill $!
wait $! 2>/dev/null
ps 输出的单位是 KB。4096 上下文时读到:
64152464停止服务,再用 -c 32768 重复相同流程:
~/llama.cpp/build/bin/llama-server \
  -m ~/models/gguf/UD-Q2_K_XL/Qwen3.8-Flash-Next-UD-Q2_K_XL-00001-of-00004.gguf \
  -t 16 -c 32768 --port 8080 &

until curl -s http://127.0.0.1:8080/health | grep -q '"status":"ok"'; do
  sleep 2
done

ps -o rss= -p $!
kill $!
wait $! 2>/dev/null
32768 上下文时读到:
65011616两次加载都使用已预热的页缓存,因此差异只来自 KV 缓存分配。
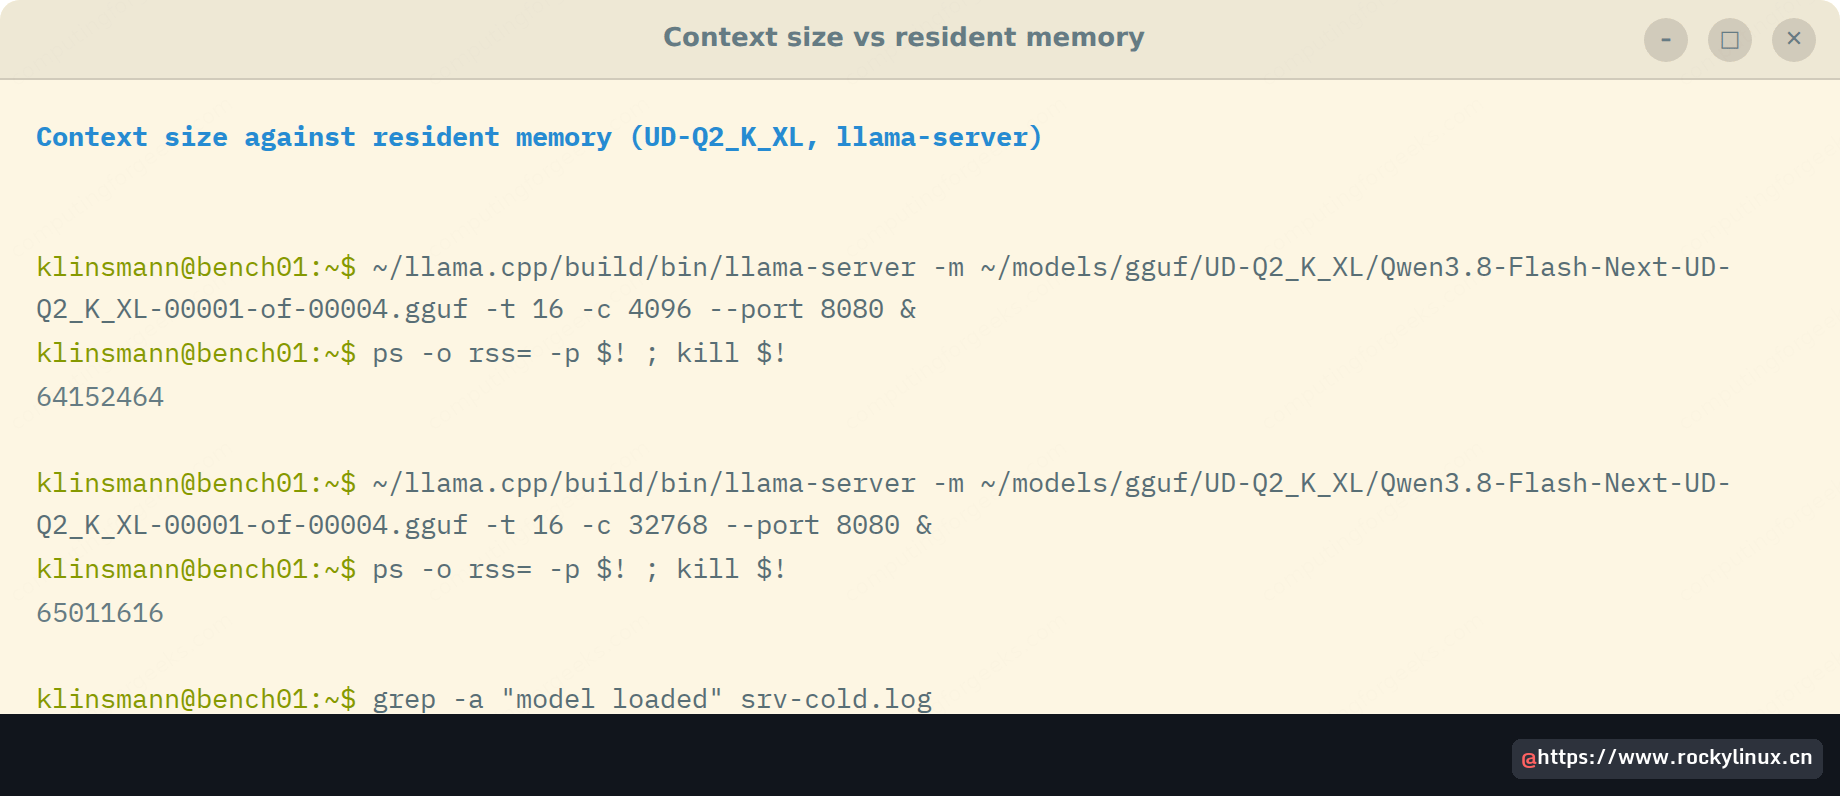
上下文扩大八倍后,常驻内存只增加约 840 MiB,折合每个 token 约 30 KiB。按模型原生 262K 上下文外推,权重之外还需要约 8 GB;因此 128 GB 机器有足够空间,而 96 GB 机器在使用较大量化时不够。生成速度没有变化:4096 上下文为每秒 5.17 token,32768 上下文为每秒 5.21 token,说明 CPU 解码路径并不直接受到 KV 缓存大小拖累。
第 6 步:通过 OpenAI API 提供服务
llama-server 暴露 OpenAI Chat Completions API,任何兼容该协议的客户端都可以接入。使用上一步确定的上下文大小启动服务,并在发送流量前等待模型加载完成:
~/llama.cpp/build/bin/llama-server \
  -m ~/models/gguf/UD-Q2_K_XL/Qwen3.8-Flash-Next-UD-Q2_K_XL-00001-of-00004.gguf \
  -t 16 -c 32768 --port 8080

0.12.120.410 I srv  server_run_i: model loaded
0.12.120.416 I srv  server_on_li: listening on http://127.0.0.1:8080
模型仍在加载时到达的请求会返回 HTTP 503 和“loading model”消息。热加载约需 12 秒,因此应轮询健康检查端点,或等待出现 model loaded 后再发第一个请求。下面的 32K 上下文补全请求正常返回,推理内容位于独立字段:
curl -s http://127.0.0.1:8080/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"messages":[{"role":"user","content":"Write one sentence about ZFS."}],"max_tokens":48}'
响应示例:
{"choices":[{"finish_reason":"length","index":0,"message":{"role":"assistant","content":"ZFS is a modern, robust filesystem and volume manager that","reasoning_content":"We need to respond to user: \"Write one sentence about ZFS. Need final one sentence about ZFS. Ensure only one sentence. Maybe mention robust filesystem."}}],"model":"/home/klinsmann/models/gguf/UD-Q2_K_XL/Qwen3.8-Flash-Next-UD-Q2_K_XL-00001-of-00004.gguf","system_fingerprint":"b1-7d7f028","object":"chat.completion","usage":{"completion_tokens":48,"prompt_tokens":59,"total_tokens":107},"timings":{"prompt_n":59,"prompt_per_second":15.86773943343026,"predicted_n":48,"predicted_per_second":5.214238643499175}}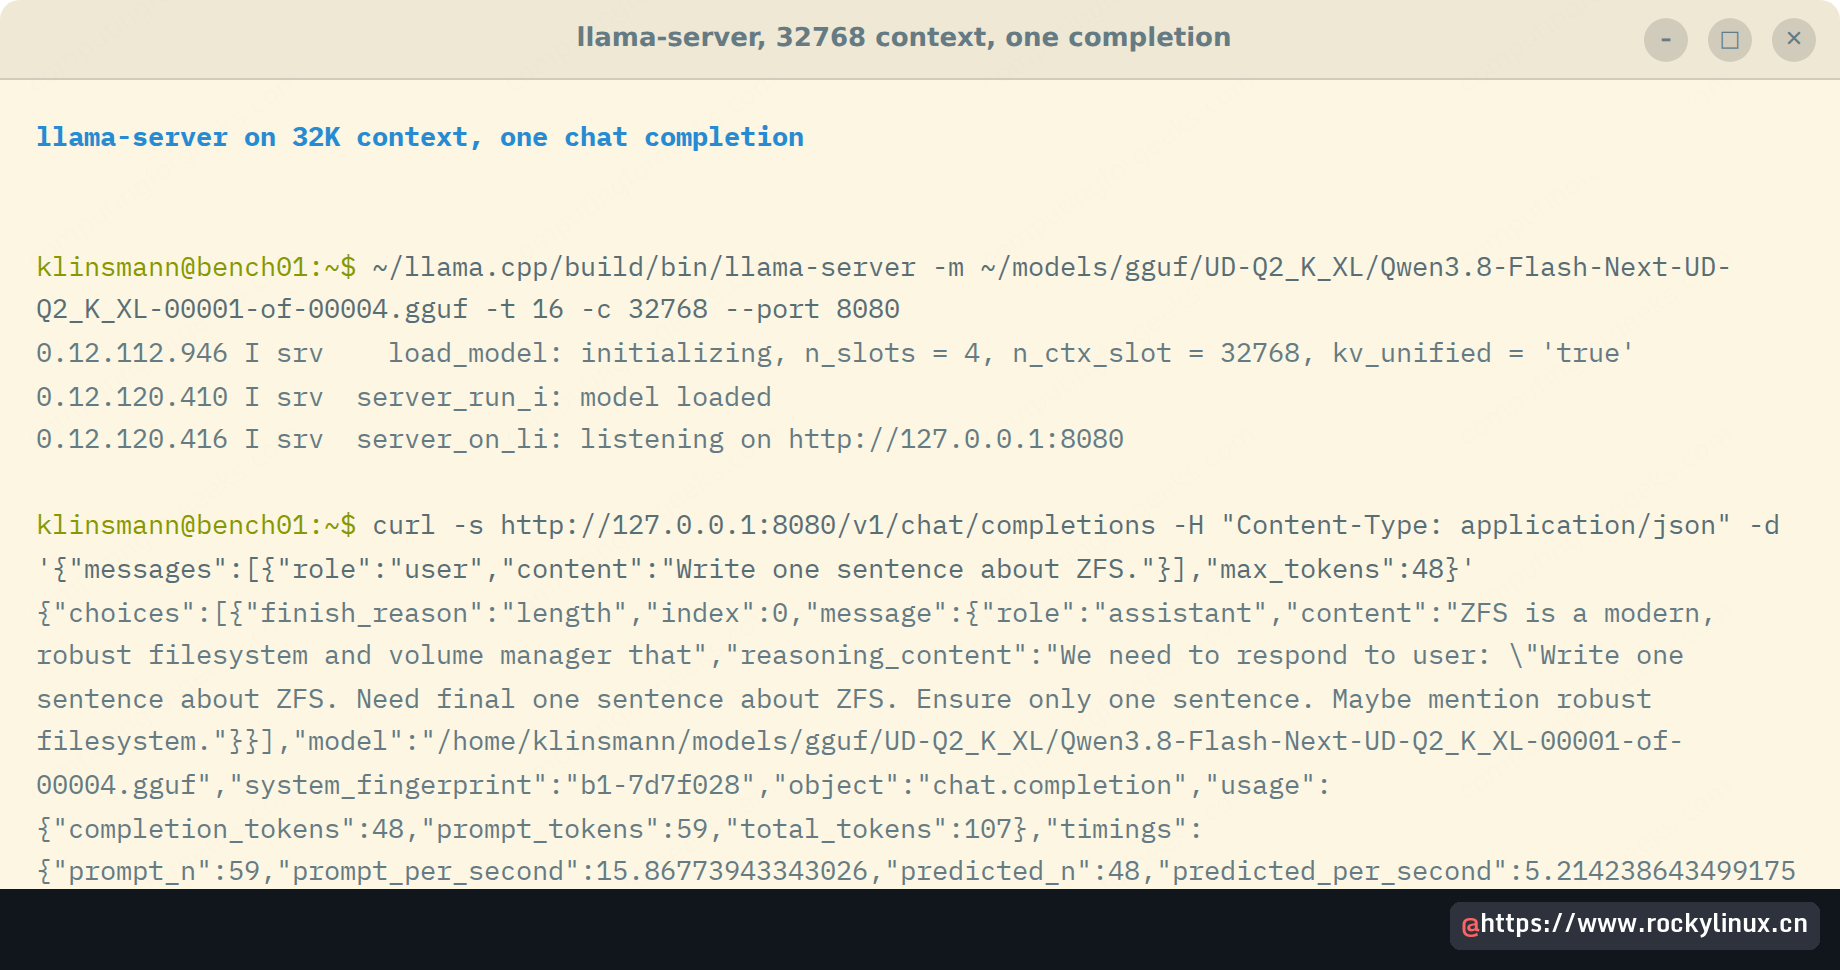
容量规划最有用的是 timings:59 token 的提示词处理速度为每秒 15.87 token,生成速度为每秒 5.21 token,略高于同一量化 tg128 的 4.67 token/s。冷启动完全不同。清除页缓存后,2-bit 量化加载耗时 3 分 24 秒,相当于从测试磁盘以约 390 MB/s 读取。如果为团队提供服务,应让模型长期保持常驻。
第 7 步:尝试 MTP 草稿路径
多 token 预测是该模型原生的投机解码路径。上游 llama.cpp b12211 提供 draft-mtp 选项,但 issue 30860 在多个构建上会在加载时中止。我们改用 Unsloth 的说明,使用 Daniel Han 的 qwen4exp/mtp 分支,并固定到实测时的提交:
git clone https://github.com/danielhanchen/llama.cpp ~/llama-mtp
git -C ~/llama-mtp checkout 6fcaa16
cmake -B ~/llama-mtp/build -S ~/llama-mtp -DGGML_NATIVE=ON -DCMAKE_BUILD_TYPE=Release
cmake --build ~/llama-mtp/build --config Release -j 16
草稿模型是此前通过 MTP/* 模式下载的 shared-Q8_0 伴随文件。用 -md 指向它并设置草稿类型,再使用与普通运行完全相同的提示词进行公平比较:
~/llama-mtp/build/bin/llama-cli \
  -m ~/models/gguf/UD-Q2_K_XL/Qwen3.8-Flash-Next-UD-Q2_K_XL-00001-of-00004.gguf \
  -md ~/models/gguf/MTP/mtp-Qwen3.8-Flash-Next-shared-Q8_0.gguf \
  --spec-type draft-mtp \
  -p "Summarize what a mixture-of-experts language model is in one paragraph." \
  -n 128 -t 16 --temp 1.0 --top-p 0.95 --top-k 20 --min-p 0.0 \
  --single-turn --seed 42
提示词和随机种子与第 3 步一致,但本次使用 Q2_K_XL 量化,因此应与第 6 步热加载的 Q2_K_XL 服务对比,而不是与 1-bit 运行比较。
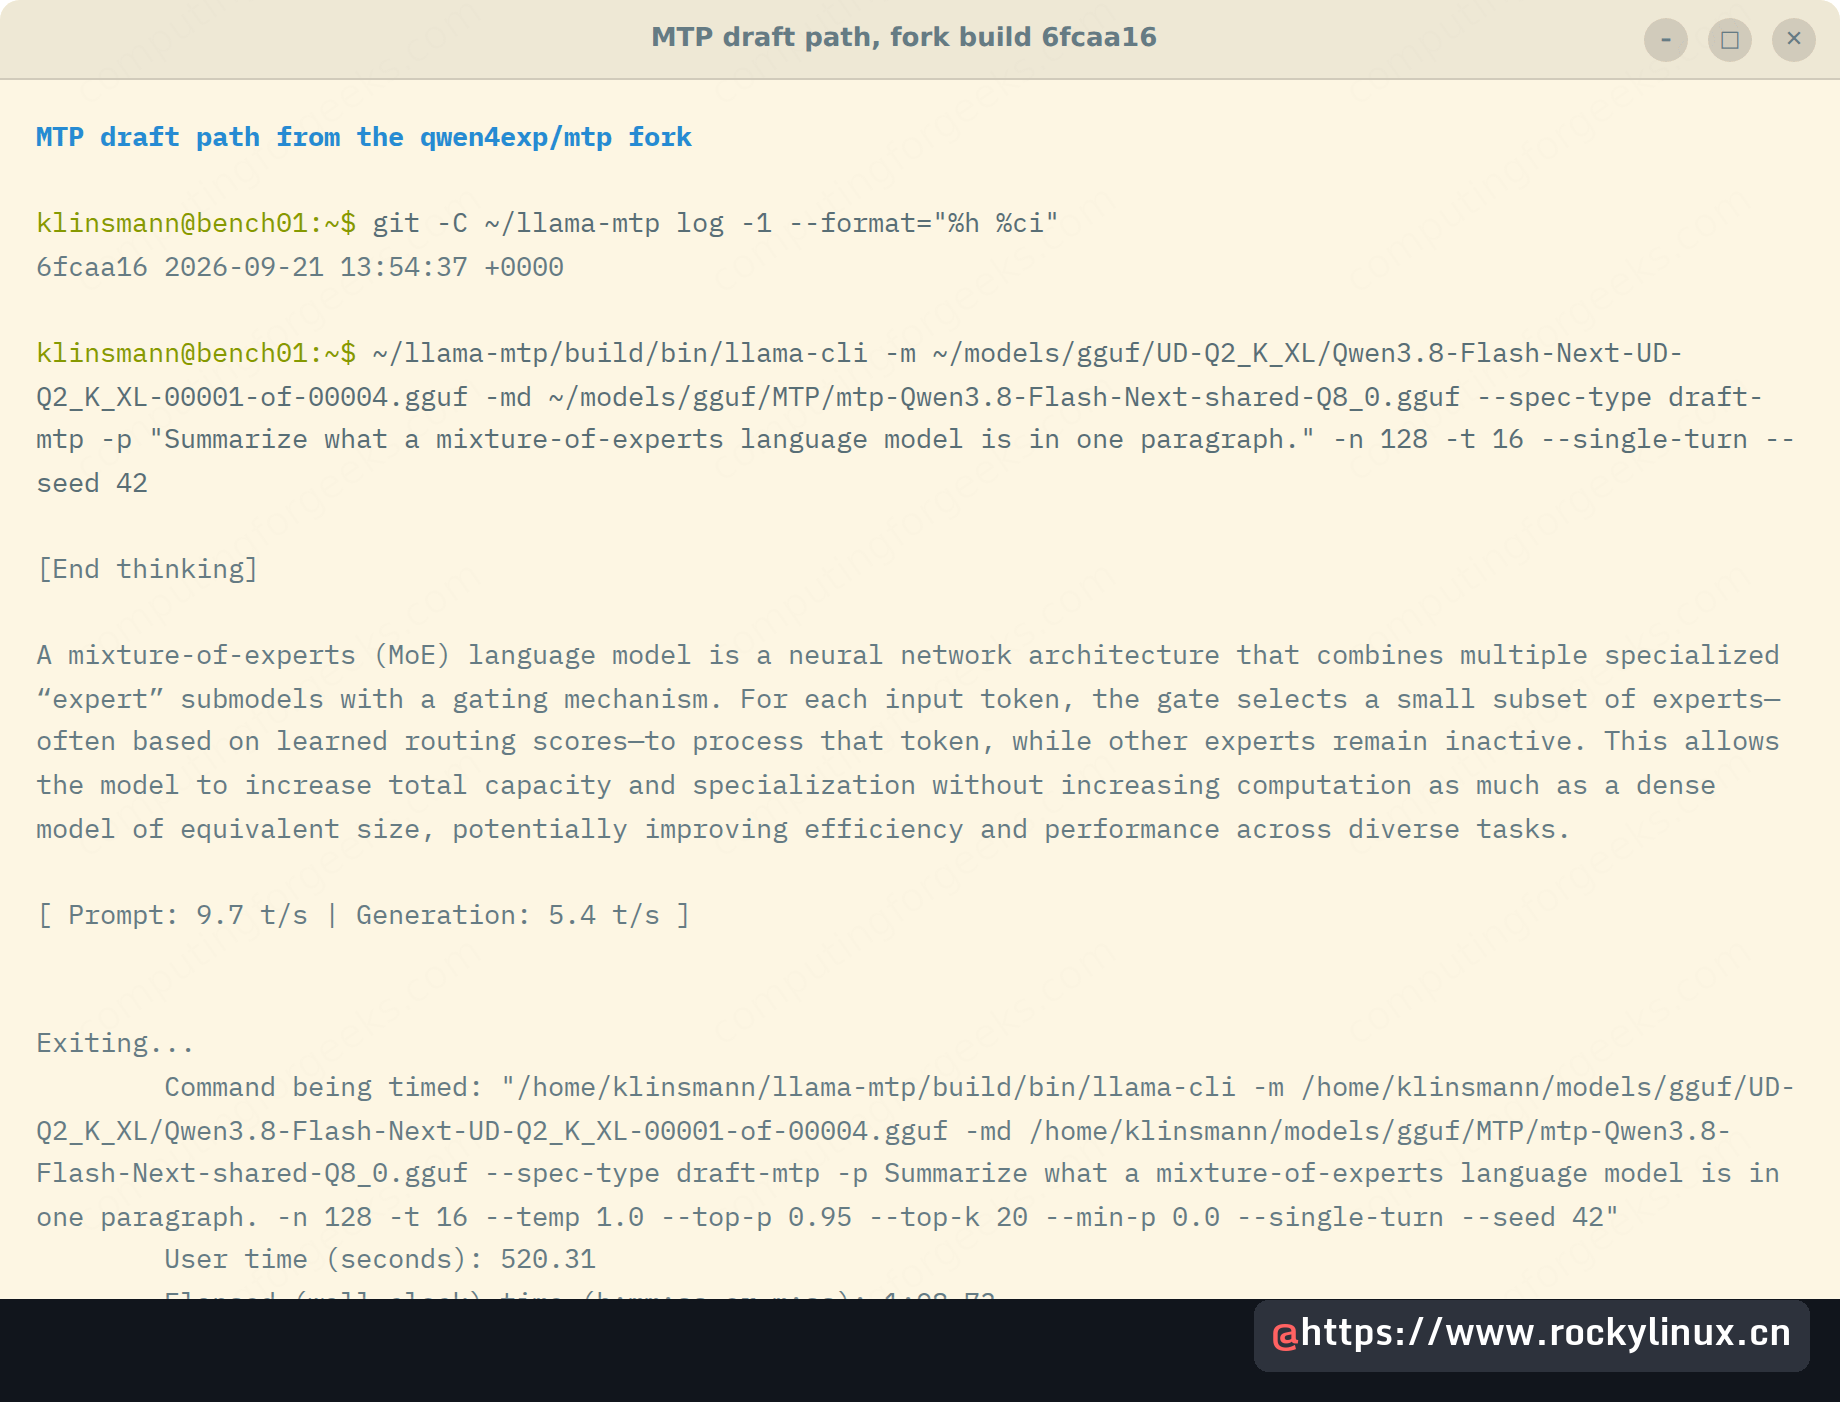
页缓存已预热时,草稿路径生成速度为每秒 5.4 token,而第 6 步普通 2-bit 量化通过 llama-server 为每秒 5.2 token。约 4% 的提升处于运行噪声范围内,因此在 CPU 上,MTP 并不值得额外编译一个分支。它还会多占用约 3 GiB 常驻内存:71.5 GiB 对普通 Q2_K_XL llama-cli 的 68.5 GiB。Unsloth 报告 GPU 上可获得 1.3 到 1.7 倍提升,因为草稿接受率在 GPU 上更重要;只有开始把层卸载到 GPU 后,才值得重新评估这个分支。
第 8 步:测试 Ollama
Ollama 是多数人已经安装的推理运行器,但按当前版本无法直接拉取这个模型。先使用标准安装方式:
curl -fsSL https://ollama.com/install.sh -o /tmp/ollama-install.sh
sudo sh /tmp/ollama-install.sh
从仓库拉取会返回 HTTP 400,因为该仓库只提供分片 GGUF,而 Ollama 不能拉取分片。错误信息会直接说明问题并给出合并方案:
ollama pull hf.co/unsloth/Qwen3.8-Flash-Next-GGUF:UD-IQ1_S输出示例:
Error: pull model manifest: 400: {"error":"This repository only contains sharded GGUF files. Ollama does not yet support pulling sharded GGUF via the registry; please download the shards and merge them locally with `ollama create` ..."}llama.cpp 提供了专门处理这种情况的拆分工具。先创建输出目录,再把三个分片合并成一个文件;随后写一个只有一行的 Modelfile 指向合并文件,Ollama 就能像普通本地模型一样导入:
mkdir -p ~/models/merged

~/llama.cpp/build/bin/llama-gguf-split --merge \
  ~/models/gguf/UD-IQ1_S/Qwen3.8-Flash-Next-UD-IQ1_S-00001-of-00003.gguf \
  ~/models/merged/qwen38-flashnext-iq1s.gguf
输出示例:
gguf_merge: /home/klinsmann/models/merged/qwen38-flashnext-iq1s.gguf merged from 3 split with 1224 tensors.将 Modelfile 保存为 ~/Modelfile.qfn,内容只有一行,并写入刚生成的合并文件绝对路径:
FROM /home/klinsmann/models/merged/qwen38-flashnext-iq1s.gguf创建模型并运行一次确认:
ollama create qwen38-flashnext-iq1s -f ~/Modelfile.qfn
ollama run qwen38-flashnext-iq1s "Say OK and nothing else."
ollama list
示例输出:
writing manifest
success
OK

NAME                         ID             SIZE     MODIFIED
qwen38-flashnext-iq1s:latest e59ee068f2b7   66 GB    2 minutes ago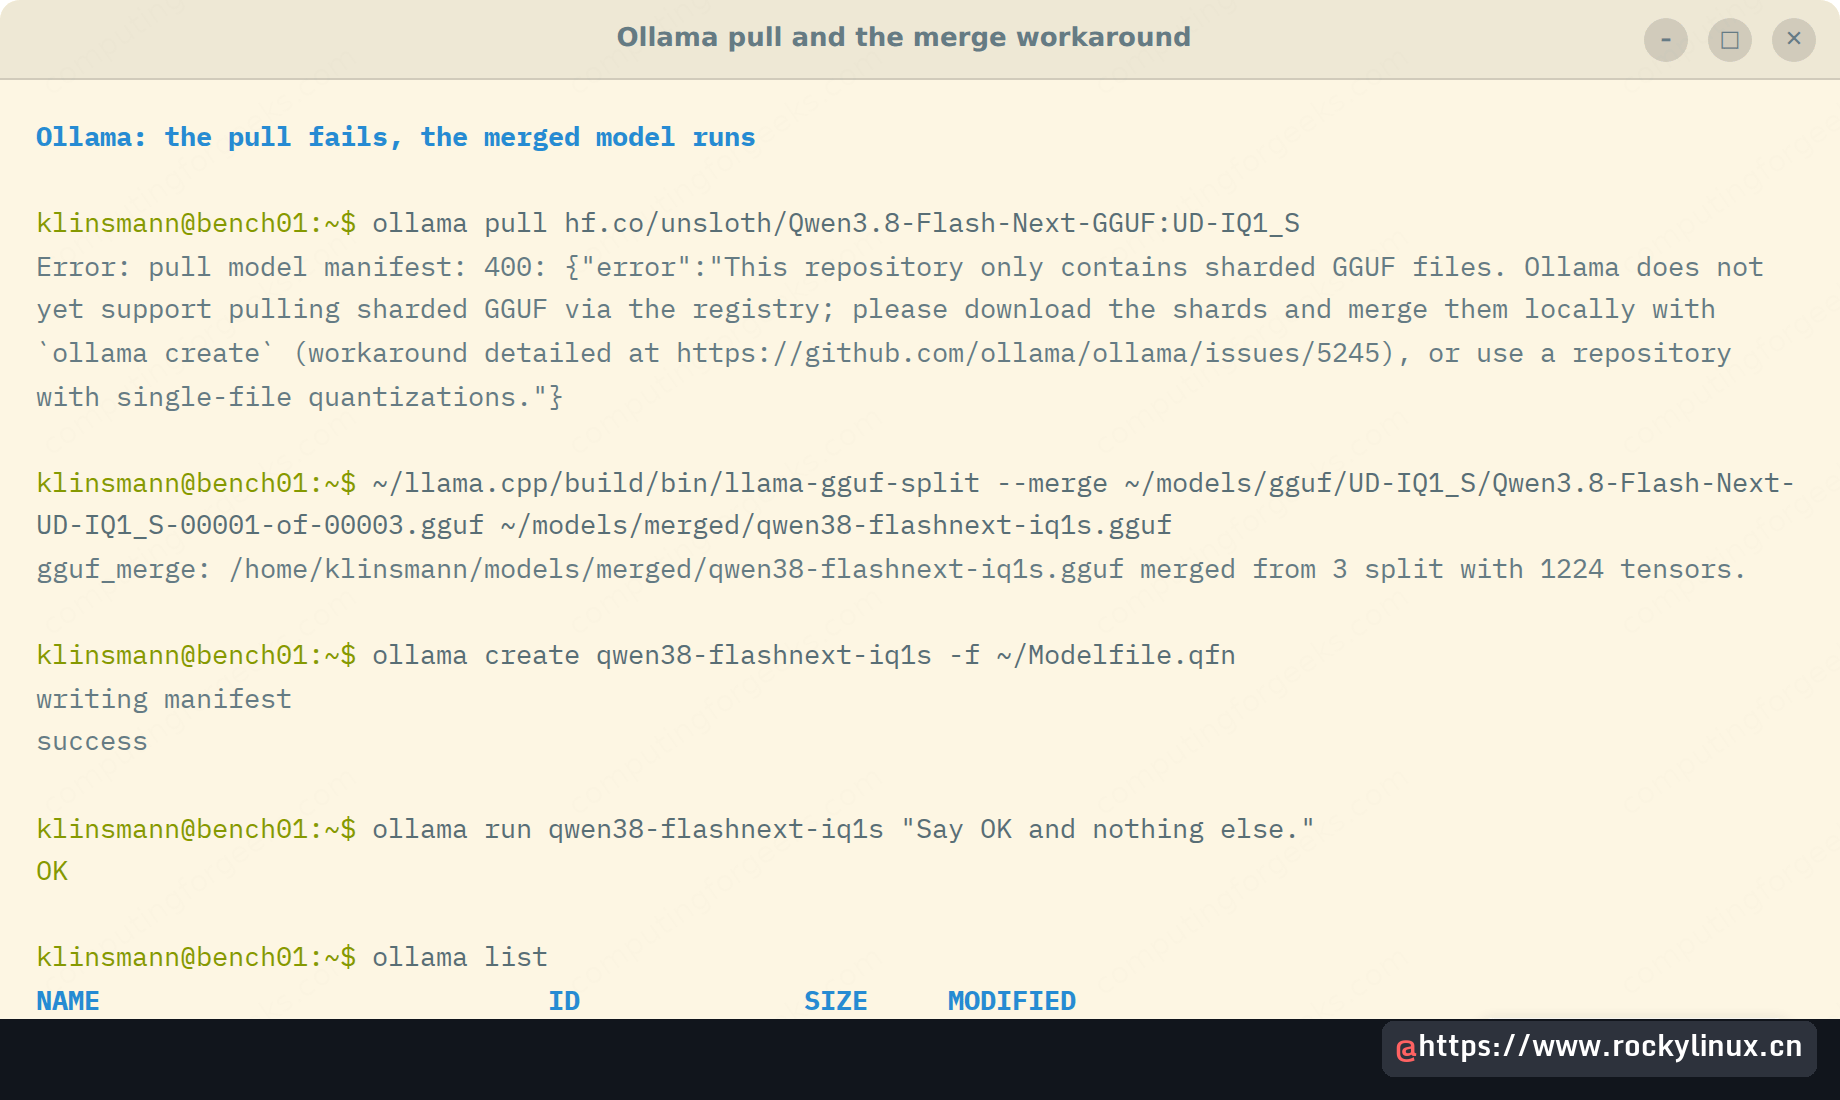
每个量化只需合并一次,但两份副本同时存在时磁盘占用会翻倍;完成导入后应删除原分片。如果 Ollama 是日常运行器,可继续参考 Ollama 命令速查表了解其他常用参数。
硬件底线
综合所有数据,64 GB 内存是最低底线,而且只适用于 1-bit 量化并依赖 mmap 分页。模型文件为 61.81 GiB,而 64 GB 实际约为 59.6 GiB。IQ2_XS 在 n-gram 表常驻后峰值为 62.6 GiB,Q2_K_XL 为 68.5 GiB。32 GB 机器理论上可以通过 mmap 从 SSD 分页运行 UD-IQ1_S,但官方文档把这种方式描述为特性而不是警告;速度损失是根据采样器触发表频率作出的推断。内存规划方面,Unsloth 给出的底线是 75 GB 内存或统一内存,而使用 3-bit 量化与 MTP 伴随模型时建议 96 GB 设备,因此应按 96 GB 规划,而不是只算 75 GB 加余量。
GPU 侧也符合一个常见模式:显卡保存 6B 激活路径,其余权重留在系统内存。2026 年 10 月的一条 Hacker News 高热讨论给出了社区数据,但并非本文实测:
- RTX 4090 + 128 GB DDR5: 报告达到每秒 124 token,未说明量化。
- RTX 4090 + 128 GB DDR4: 使用 3-token MTP 时超过每秒 110 token;同一张卡上 Q5 的 27B 模型约为每秒 60 token。
- RTX 3080 10 GB: 约每秒 30 token,报告使用 Coder 变体,是这组数据中的低端。
- RTX 6000 Pro: Q4 解码达到每秒 255 token,是帖子中的最高值。
这些报告呈现出一个可用于规划的规律:部分 GPU 卸载之所以可行,是因为每个 token 激活的模型部分很小,10 GB 显卡因此也能运行 125B 模型。系统内存在这个模型上几乎和显存一样重要,最好优先保证容量,其次关注带宽。
Flash-Next 还是 Qwen3.8 27B?
Flash-Next 的模型卡在三个公开指标上都高于 27B:
| 基准 | Flash-Next | Qwen3.8 27B |
|---|---|---|
| SWE-bench Pro | 62.5 | 61.7 |
| DeepSWE 1.1 | 58.7 | 42.2 |
| GPQA Diamond | 91.7 | 89.2 |
但这些是厂商选择的基准,应谨慎看待。真正的差异在量化敏感性,而社区数据比模型卡更混乱。一次广泛传播的 128 项代码生成与补全测试使用 Strata 量化阶梯工具,27B 在 Q4/Q5 得分 71.9%,Flash-Next 在 IQ3_XXS 得分 89.1%。同一讨论并非一边倒:有用户报告 4-bit 27B 优于 3-bit Flash-Next,但该说法只是转述其他讨论,没有给出自己的数据。
| 对比 | 证据 | 结果 |
|---|---|---|
| 3-bit Flash-Next 对 4/5-bit 27B | 一次 HN 上的 128 任务测试(Winfred-zz、Strata) | Flash-Next 89.1 对 71.9,但并非同 bit |
| 3-bit Flash-Next 对 4-bit 27B | 仅有轶事报告 | 存在争议,无数据 |
| 同 bit、正面对比 | 无公开结果 | 未知 |
按 bit 数拆分,社区证据大致对应三种情况。结论是:在一次可测量测试中,3-bit 的 Flash-Next 胜出;4-bit 的交点尚未被证明;27B 在所有 bit 数下都因更小体积和更低内存需求占优。本文没有自行做质量测试。如果拥有 GPU,可参考 27B 教程中的 RTX 4090 实测数据;如果受内存限制,则本文 CPU 数据更有决策价值。
常见错误
SM110 GPU 卸载 9 层以上时输出乱码
llama.cpp issue 27763 报告,在 SM110 硬件上 -ngl 达到 9 后会出现静默输出损坏,且没有 CUDA 错误提示。纯 CPU 运行不受影响。后续排查发现根因是 CUDA 13.2 工具链问题:改用 CUDA 13.0.88 重建后,同一张显卡可以完成完整卸载并输出连贯内容;官方 Vulkan 预构建也可作为无需重编译的回退方案。-ngl 8 最多只能算部分缓解,因为讨论中仍有一张副卡在 8 层时异常。长期修复方案是用不同 CUDA 工具链重新编译。
仅导出草稿的 MTP 文件会段错误
Issue 30696 记录了一个只有草稿、没有完整模型的 GGUF 导出:加载和运行时会在图构建的上下文预留阶段触发段错误,报告称该问题不只出现在 Metal。导出时应同时附带完整模型,或者直接使用 Unsloth 仓库中预构建的伴随模型,本文采用后者。
Vulkan 草稿路径触发 GGML_ASSERT(buffer)
Issue 30860 报告,在多个构建中通过 Vulkan 后端运行 --spec-type draft-mtp 会在 KV 池输入阶段中止。该讨论也确认 CUDA 存在相同问题,因此并非 Vulkan 专属;测试时修复尚未合并。即使使用 -ngl 0 也能复现,因为中止发生在 llama-server 加载阶段的草稿探测,而不是 GPU 内核中。唯一成功的草稿运行来自该分支的 CPU llama-cli,补丁合并前应使用这一路径。
Unsloth 示例混用了量化名称
Unsloth 文档中的 llama-cli 示例指向 UD-IQ1_S 目录,但参数却写出了 UD-Q4_K_XL 分片名。如果磁盘上只有 1-bit 量化并原样复制命令,加载会失败。应选择与实际下载量化一致的分片名称。
首次加载期间返回 HTTP 503
llama-server 会在模型加载完成前打开 HTTP 端口。加载期间每个请求都会返回 HTTP 503 和“Loading model”,与服务器 README 对 /health 的说明一致。冷页缓存下这个窗口很长。第 5 步 4096 上下文服务器冷启动日志显示,端口在模型加载完成前已经可以响应,但一直返回 503:
0.00.021.746 I srv    load_model: loading model '/home/klinsmann/models/gguf/UD-Q2_K_XL/Qwen3.8-Flash-Next-UD-Q2_K_XL-00001-of-00004.gguf'
3.23.630.527 I srv    load_model: initializing, n_slots = 4, n_ctx_slot = 4096, kv_unified = 'true'
3.23.657.899 I srv  server_run_i: model loaded
3.23.657.909 I srv  server_on_li: listening on http://127.0.0.1:8080
在这 3 分 24 秒里,每个请求都会得到 503。应像第 5 步一样轮询 /health,直到返回 ok。只重试几次就放弃的脚本会把仍在分页加载权重的服务器误判为死亡。
qwen4exp 要求设置 ctx_other
MTP 分支启动并计算内存时会打印一条 error 级别信息,首次运行时看起来很像严重错误:
E llama_init_from_model: failed to initialize the context: qwen4exp requires ctx_other to be set (this warning is normal during memory fitting)按消息本身提示忽略即可。我们的运行在打印该信息后继续加载草稿伴随模型,并以每秒 5.4 token 生成,没有需要修复的问题。
需要持续观察的指标
三个数字决定这个模型能否长期稳定运行,而每个数字都有对应调节手段:
- RSS 与总内存: n-gram 表会惰性分页,长时间会话下常驻内存会逐渐上升。接近总内存后机器开始交换,token 速度会断崖式下降。
- Engram 替换: 用
engram目录中更大的预构建表替换 28.8 GB 分片,可以在不改 Transformer 的情况下提升预测质量,是模型成本最低的质量升级方式。 - MTP 草稿接受率: 实测分支构建来自 9 月。issue 30860 的上游
draft-mtp修复合并后,应在上游重新基准测试,因为这些数字会变化。
日常使用时应监控前两个指标,每次重新编译后则重新评估第三个。如此规模的模型很容易把问题藏在平均值里,而真正的问题往往只在单会话指标中显现。